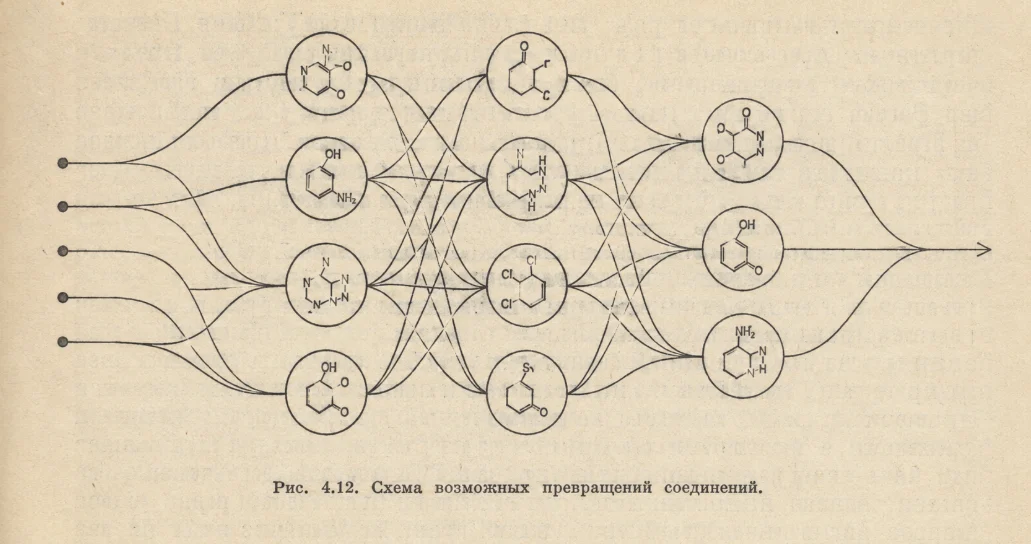
Как учебник из девяностых описывает архитектуру нейросетей
Перебирая архивные учебные материалы по линейной алгебре (да, у меня есть такая специфическая привычка, можете не удивляться), я наткнулся на любопытный химический фрагмент. Автор заявлял: «Молекула воды — это вектор (2, 0, 1). Молекула метана — вектор (4, 1, 0)». И без лишних колебаний переходил к линейной зависимости векторов, преподнося это как нечто абсолютно самоочевидное.
Поначалу мне показалось, что это лишь методическая условность для наглядности упражнений. Однако, поразмыслив над этим с полчаса, я осознал правоту автора: он фактически предугадал, почему абсолютно любую предметную область можно упаковать в нейросеть. Просто в девяностых это называлось линейной алгебре, а не модным representation learning.
Химия для тех, кто не любит химию
Суть концепции элементарна. Предположим, у нас есть набор из n атомов (водород, углерод, кислород и т. д.). Каждому элементу мы ставим в соответствие орт-вектор, где на нужной позиции стоит единица, а остальные заполнены нулями:
-
b1 = (1, 0, …, 0) — водород,
-
b2 = (0, 1, …, 0) — углерод,
-
b3 = (0, 0, 1, …, 0) — кислород.
Если этот формат координат кажется вам знакомым, поздравляю: вы только что столкнулись с one-hot encoding. Именно так сегодня кодируют категориальные переменные перед подачей в алгоритмы. Автор пособия из 90-х, разумеется, не оперировал этим термином, но по сути описал классический метод, просто применив его к атомам вместо токенов.
Идем далее. Молекула — это не что иное, как линейная комбинация таких базисных векторов с целыми неотрицательными коэффициентами. Сколько атомов определенного вида входит в состав вещества, столько единиц мы и берем.
Вот как выглядит вектор воды в базисе (H, C, O): H2O = 2·b1 + 0·b2 + 1·b3 = (2, 0, 1). А вот аналогичное представление для углекислого газа: CO2 = 0·b1 + 1·b2 + 2·b3 = (0, 1, 2).

На языком науки это зовется «bag of atoms» (по аналогии с «bag of words»). Пространственная упорядоченность стирается, фиксируется лишь количественный состав. По сути, классическая брутто-формула и представляет собой такой «мешок», ее невозможно перепутать со структурной, но об этом мы поговорим чуть позже.
Молекула воды предсказывает саму себя
Решив проверить теорию на практике, я взялся за калькулятор. Если молекула выражена вектором, а атомная масса — скалярной величиной, то молярная масса вещества будет линейной функцией такого вектора. Иными словами, обычным скалярным произведением.
Берем константы: масса водорода — 1.008, углерода — 12.011, кислорода — 15.999 а.е.м. Вычисляем молярную массу как взвешенную сумму:
-
m(H2O) = 2·1.008 + 0·12.011 + 1·15.999 = 18.015,
-
m(CO2) = 0·1.008 + 1·12.011 + 2·15.999 = 44.009,
-
m(C2H2) = 2·1.008 + 2·12.011 + 0·15.999 = 26.038,
-
m(CH4) = 4·1.008 + 1·12.011 + 0·15.999 = 16.043.
Сверяемся со справочными данными: вода — 18.015, углекислота — 44.01, ацетилен — 26.04, метан — 16.04. Результаты совпадают с точностью до округления констант.
К чему мы пришли? Перед нами примитивнейшая искусственная нейросеть: без скрытых слоев, без нелинейных активаций, с единственным выходным нейроном. Входные данные — вектор молекулы, веса — атомные массы. Обучать эту конструкцию не требуется, ведь идеальные коэффициенты уже подарила нам таблица Менделеева. Однако, если бы мы не знали атомных весов, а обладали лишь выборкой пар «вектор — масса» для сотни соединений, обычная линейная регрессия легко восстановила бы эти веса без единого намека на химические законы. Именно так сегодня функционируют передовые предиктивные модели материаловедения: они опираются не на физику, а на скрытые статистические паттерны в векторизованных составах.

ИИ‑роутер — доступ к 300+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Универсальность векторного подхода
Обобщим этот опыт в виде фундаментального принципа.
Любая нейросеть в своей основе оперирует базовыми операциями: умножение вектора на матрицу, добавление смещения, пропуск через нелинейную функцию и циклическое повторение. Единственное жесткое условие для входных данных — они должны представлять собой вектор, то есть элемент пространства со строгими правилами сложения и скалярного умножения.
Как только вы находите способ корректно отобразить объекты вашей сферы в векторный вид, где арифметические операции имеют физический или логический смысл, вам открывается весь арсенал линейной алгебры. И совершенно не принципиально, что именно вы векторизуете: слова (word2vec, токен-эмбеддинги), пиксели изображений (интенсивность цвета), транзакции пользователей маркетплейса или химические элементы. Для архитектуры сети не существует понятий «химия» или «текст» — она оперирует исключительно числами и матрицами.
В этом и заключается главное преимущество современного искусственного интеллекта: 90% трудозатрат в Data Science уходит на качественное проецирование реального мира в векторные пространства, тогда как само обучение библиотеки берут на себя.
Где концепция «мешка атомов» дает сбой
Автор учебника справедливо отмечал, что реальным молекулам соответствует лишь подмножество векторов с целыми неотрицательными параметрами. Но есть и другая проблема, о которой в методичке умалчивалось, хотя химики знают ее прекрасно.
Возьмем этанол (C2H6O) и диметиловый эфир (C2H6O). Это два совершенно разных соединения с кардинально отличающимися температурами кипения, токсичностью и свойствами. Тем не менее, их вектор состава в стандартном атомном базисе абсолютно идентичен: (2, 6, 1). «Bag of atoms» бессилен перед изомерами, поскольку полностью игнорирует ключевой фактор — топологию связей между атомами.

С аналогичной трудностью сталкивался метод «мешка слов» (BoW) в NLP до прихода трансформеров: фразы «собака укусила почтальона» и «почтальон укусил собаку» казались ему идентичными из-за потери порядка следования.
Проблема решается схожими методами. Если в обработке естественного языка на помощь пришли позиционные эмбеддинги и механизмы внимания (attention), то в химии задействуют графовые нейросети (GNN). В этом случае молекула предстает не плоским набором чисел, а графом со связями, где модель учится анализировать топологическую структуру.
Механика выглядит следующим образом: каждый атом по-прежнему описывается вектором, но теперь он привязан к вершине графа, а тип элемента служит базовым признаком. На следующем этапе вершины «обмениваются сообщениями» с соседями по химическим связям, аккумулируя их векторные представления и обновляя собственные. За несколько итераций информация о пространственной конфигурации расходится по всему графу.
На датасете QM9, включающем более 100 000 компактных органических молекул с квантовохимическими характеристиками, подобные сети предсказывают 11 из 13 целевых параметров с точностью дорогостоящих квантовых расчетов. Главное отличие от брутто-формулы в том, что граф сохраняет связи, позволяя легко разделять этанол и диметиловый эфир.
От тривиальных атомов к двадцати аминокислотам
Этот же подход, но в значительно более масштабном исполнении, лежит в основе предсказания белковых структур. Разница с учебником очевидна: вместо трех базовых элементов здесь фигурируют 20 аминокислот, а вместо простой молекулы — полипептидная цепь из сотен звеньев.
Белок — это линейная последовательность букв алфавита: к 20 стандартным добавляется редкий селеноцистеин, формируя алфавит примерно из 21 символа. Простейшее кодирование одной аминокислоты зеркально повторяет подходы из методички: 21-мерный вектор с единицей на определенной позиции и нулями в остальных. Этот классический one-hot encoding до сих пор используют в качестве бенчмарка для новых белковых эмбеддингов, хотя он неизменно проигрывает современным аналогам.
Проигрывает по той же причине, что и брутто-формула перед графами. One-hot не учитывает, что лейцин и изолейцин обладают практически идентичными физико-химическими свойствами. Для векторов это два независимых ортогональных индекса, удаленных друг от друга точно так же, как и от любых других восемнадцати. Поэтому разработчики обращаются к опыту word2vec: жесткий one-hot заменяют на обучаемый эмбеддинг. Он автоматически настраивается так, чтобы сходные по природе аминокислоты группировались поблизости в векторном пространстве.

Архитектуры вроде ESM спроектированы именно по этому принципу. Белок здесь выступает в роли предложения, аминокислота — токена, а сама модель представляет собой трансформер, решающий задачу в духе языковой модели BERT: угадывание замаскированного токена по контексту. Только вместо поиска пропущенного слова в тексте сеть восстанавливает недостающую аминокислоту, опираясь на эволюционный контекст миллионов природных последовательностей. На выходе каждый элемент внутри белка обретает собственный контекстуальный вектор, на порядок превосходящий статический one-hot за счет зашитой в него эволюционной логики.
AlphaFold2 идет еще дальше. Модель оперирует не одним вектором на аминокислоту, а двумя матричными слоями одновременно: множественным выравниванием последовательностей (MSA), где строки отражают вариации гомологичных белков у разных организмов, и парным представлением — вектором для каждой пары аминокислот, отражающим вероятность их пространственного контакта.
Центральный компонент сети (Evoformer из десятков блоков) распределяет внимание по матрице MSA и последовательно уточняет парные взаимосвязи до тех пор, пока из эволюционной статистики не проступит трехмерная геометрия. Финальный модуль транслирует эти векторы в реальные XYZ-координаты атомов.
Принципиально важно, что фундаментом этого технологического прорыва остается всё та же базовая идея из методички: аминокислота — это точка в многомерном пространстве. Только размерность здесь исчисляется не тремя осями (H, C, O), а тысячами обучаемых параметров, а правила комбинаторики оптимизируются на миллионах белковых структур с помощью алгоритмов маскированного моделирования.
Более поздняя модель ESMFold вообще отказалась от использования MSA. Выяснилось, что масштабные языковые модели способны самостоятельно извлекать эволюционную статистику из «сырых» последовательностей, предсказывая структуру напрямую по эмбеддингам без поиска гомологов. Это обеспечивает колоссальный прирост в скорости вычислений в сравнении с AlphaFold 2, пусть и ценой микроскопической потери точности.
Возвращаясь к методичке
Разумеется, автор вузовского пособия из девяностых не совершал фундаментальных прорывов — линейная алгебра к тому моменту уже имела вековую историю. Тем не менее, ему удалось наглядно показать ключевую идею: стоит перевести объект в векторный формат, как к нему начинает применяться весь мощнейший аппарат абстрактной математики. И совершенно неважно, что именно кодируют координаты — атом водорода, остаток белковой цепи или токен в большой языковой модели.
Эволюция от трех атомов в старой методичке до двадцати аминокислот в современных моделях ESMFold или AlphaFold 2 оказалась гораздо короче, чем кажется. Разница заключается лишь в мерности пространства и том, кто именно производит расчет коэффициентов: студент с тетрадью или кластер GPU, выполняющий операции в течение нескольких недель.
Нейронные сети выполняют те же скалярные произведения, но в сверхвысоких размерностях, с огромными вычислительными мощностями и каскадом нелинейных функций активации между слоями. На пожелтевших страницах старого учебника полувековой давности уже содержались те самые принципы, которые объясняют сегодняшние успехи AlphaFold 2 и GPT. Всё сводится к векторам, остальное — лишь инженерная реализация.
P.S.: сама методичка авторства Р. А. Симоненко называется «Методическая разработка для студентов химического факультета. Часть 1. Векторы, матрицы и определители». Она досталась мне в виде потертых ксерокопий от знакомого, в свободном доступе в интернете я ее, увы, не встречал.
Похожие статьи
 Искусственный интеллект как фетиш: опыт пересборки социального
 Инновации в упаковке продуктов: от химии и микробиологии до электроники и IT
 Объяснение архитектуры современных нейросетей через призму методички 1990-х годов
 Как шведские энтузиасты в гараже обошли стартап Бэббиджа с бюджетом в 30 паровозов
 Эволюция кода: история ИТ. Часть 5. Гэри Килдалл
 Очередная, 100501-я версия латиницы для русского языка
 Получение энергии из атмосферы
 В России испытали новый СВЧ-радиометр МРИТ-76 для измерения температуры жидкого чугуна