Как собирают данные для обучения роботов: от телеуправления и симуляций до камер на кепках
Языковые модели стали заметно умнее прежде всего благодаря масштабированию: их обучали на десятках триллионов токенов, которые человечество за годы выложило в интернет. В робототехнике подобного запаса нет. Никто не публиковал миллионы часов видео, на которых робот складывает рубашку или наливает воду, и каждый час таких записей приходится создавать с нуля.
В этой статье мы рассмотрим, какими способами сегодня собирают данные для обучения роботов, каков объём уже накопленного и в какую сумму обойдётся попытка сравняться с LLM. По грубым подсчётам, у роботов данных примерно в тысячу раз меньше.
Почему всё упирается в данные
Успехи ИИ последних лет объясняются в первую очередь масштабом. В 2020 году, после выхода GPT-3, Gwern изложил эту мысль в эссе «The Scaling Hypothesis». Он утверждал, что интеллект — это, по сути, простые алгоритмы обучения в сочетании с огромным массивом разнообразного опыта: чем больше вычислительных ресурсов, тем мощнее нейросети. В 2024 году исследователь, скрывающийся под псевдонимом Nostalgebraist , резюмировал: весь современный ИИ вырос из одного открытия — модели последовательно и предсказуемо становятся лучше по мере роста объёма данных.
Цифры подтверждают эту картину:
-
по данным Epoch AI, начиная с 2010-х годов обучающие датасеты языковых моделей удваиваются примерно раз в полгода;
-
GPT-3 обучалась приблизительно на 300 млрд токенов из интернета, тогда как крупнейшие современные модели — на десятках триллионов;
-
в 2024 году Epoch AI оценила совокупный объём доступного качественного текста примерно в 300 трлн токенов.
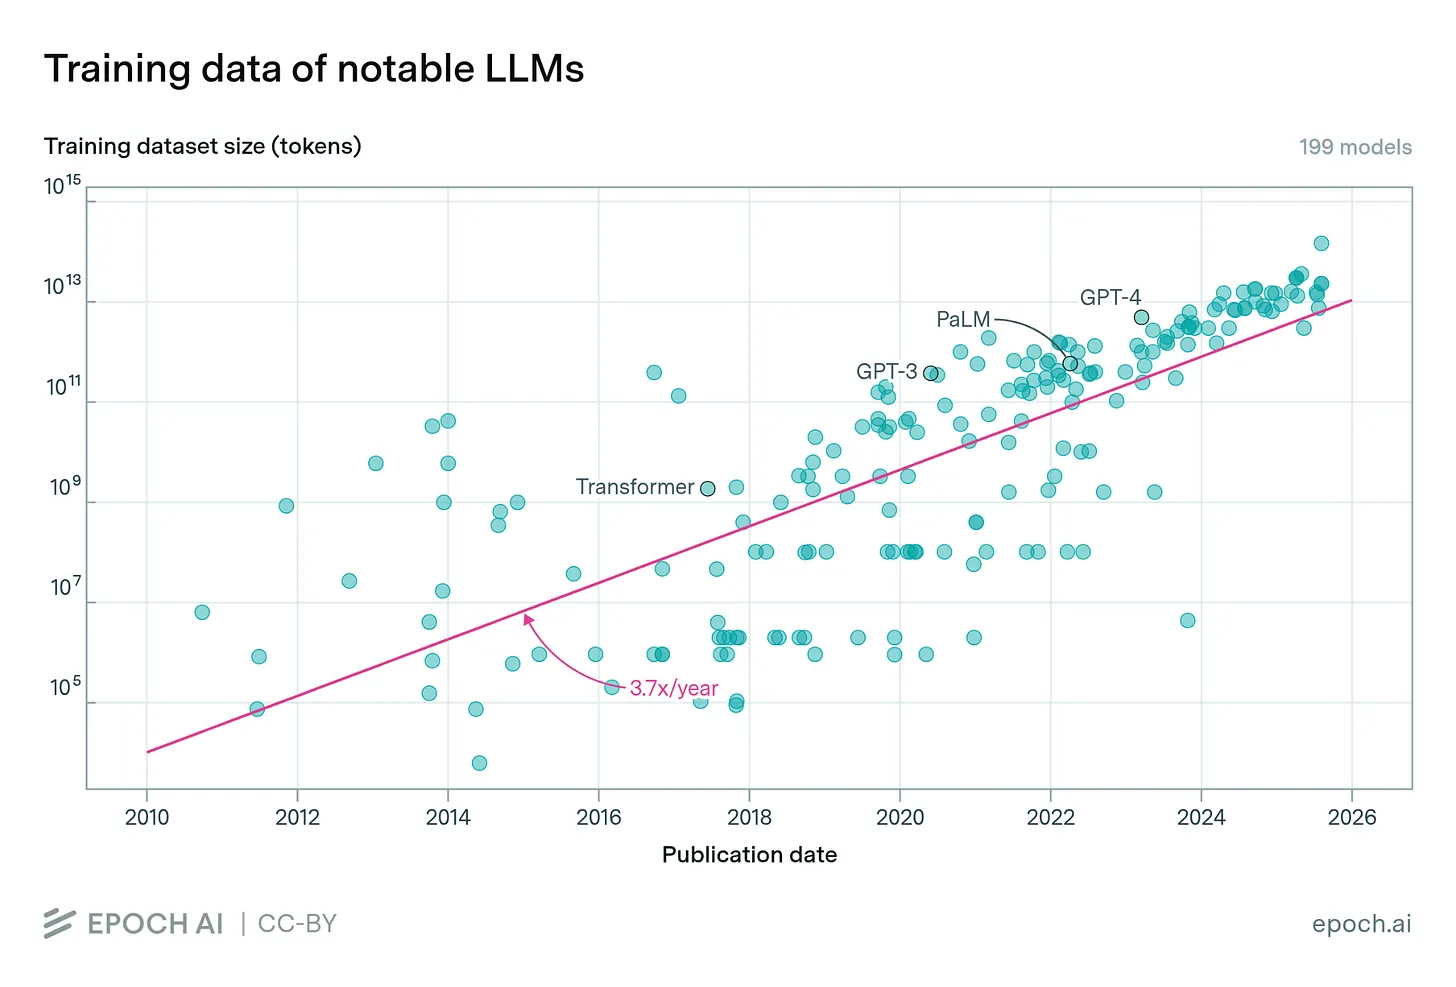
Сопоставимого резерва качественных открытых данных для роботов попросту не существует. Поэтому одним из главных вопросов отрасли остаётся то, где их взять и в каком количестве они нужны.
Как выглядит обучающий пример для робота
Принцип здесь тот же, что и у LLM. Модели требуется множество образцов правильного выполнения задачи либо хотя бы способ определить, насколько удачной была попытка. Модель получает входные данные, её ответ сопоставляется с эталонным, а параметры подстраиваются градиентным спуском так, чтобы ошибка уменьшалась.
С текстом всё предельно просто: любой отрывок уже представляет собой готовый пример. Модели показывают начало фразы и предлагают предсказать продолжение.
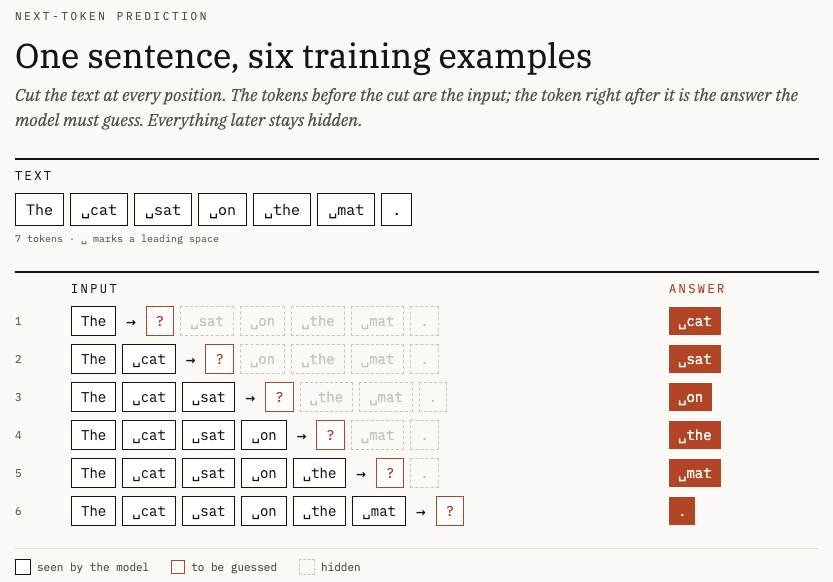
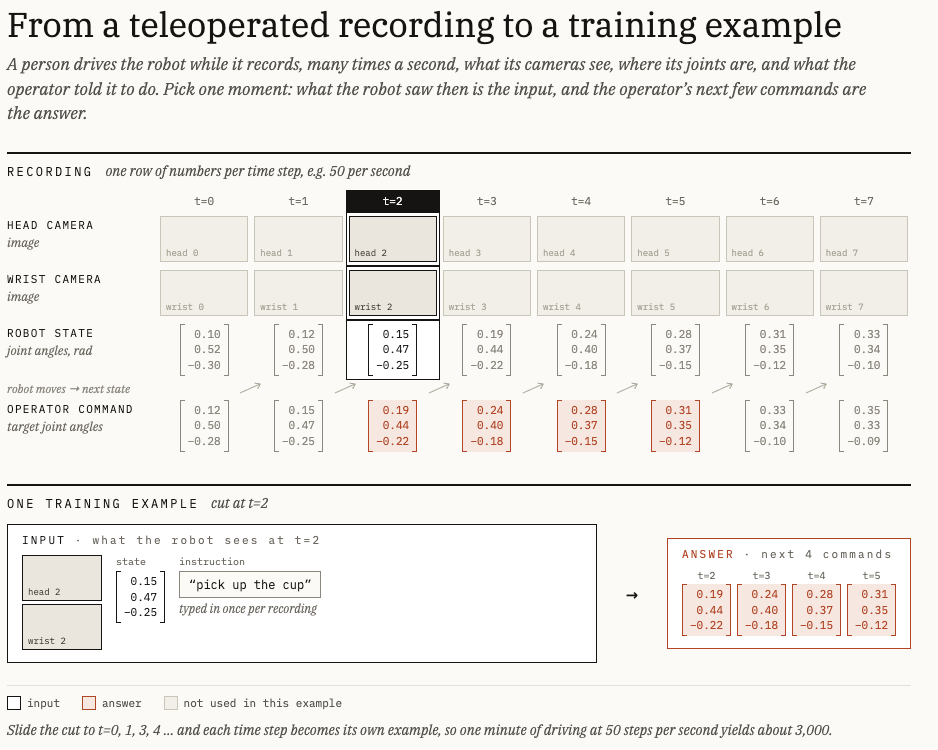
Для робота пример — это запись выполнения задачи. В каждый момент времени в ней зафиксировано состояние машины (скажем, углы поворота суставов) и кадры с камер. На их основе модель предсказывает следующее действие.
Пять способов добыть данные
Телеуправление
Оператор, пользуясь органами управления, напрямую связанными с роботом, выполняет нужную задачу руками машины: складывает рубашку, переставляет предметы, наливает воду.
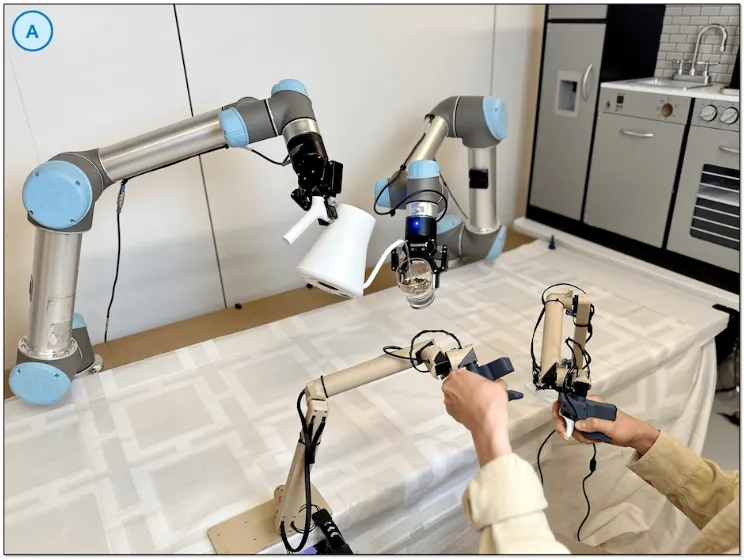
Всё происходящее записывается, после чего модель учат воспроизводить действия оператора. Когда модель перенимает поведение эксперта (здесь — человека), такой подход называют клонированием поведения (behavioral cloning). Это частный случай более широкого направления — обучения с подражанием (imitation learning).
Плюс: данные в точности отвечают возможностям конкретного робота, так как записаны именно на нём. Благодаря этому метод до сих пор активно применяют. В сети встречаются фотографии целых «фабрик данных», где люди занимаются исключительно управлением роботами. Есть и ролики с авариями: оператор забывает, что работает через робота, и выполняет движение, которое машина повторить не в состоянии.
Минусы:
-
высокая цена: каждому оператору необходим реальный робот, поэтому масштабировать подход трудно;
-
неудобство: оператор, как правило, не ощущает предмет руками, и тонкие манипуляции так по-настоящему не записать;
-
много брака: по имеющимся сведениям, для обучения годится лишь часть собранного.
Роботы, которые учатся сами
Робот действует самостоятельно, а специальная система оценивает, получилась ли попытка. Это обучение с подкреплением (reinforcement learning). Например, примерно в 2016 году у Google существовала так называемая «ферма манипуляторов» (arm farm): механические руки сами пробовали хватать предметы, а удачный захват считался успехом.
Сегодня такие фермы почти не встречаются. Однако в перспективе главным источником данных, вероятнее всего, станут роботы, работающие в реальном мире. Специалисты называют этот механизм «маховиком данных» (data flywheel): роботы трудятся, их данные улучшают модели, обновлённых роботов внедряют шире, и данных становится ещё больше.
Так, Physical Intelligence опробует этот подход на шоколадной фабрике неподалёку от собственного офиса. Сложностей две. Во-первых, роботов с ИИ, занятых настоящей работой, пока крайне мало. Во-вторых, их данные однообразны: одна и та же задача в одних и тех же условиях, а для обучения это малополезно.
Симуляция
Вместо физического робота в виртуальном мире обучают его цифровую копию, как правило, методом обучения с подкреплением. Применяется и схема «учитель — ученик» (teacher/student). Модель-учитель наблюдает всё, что происходит в симуляции. Модель-ученик видит лишь то, что доступно реальному роботу: изображение с камер и собственное состояние. Ученик учится копировать учителя.
Симуляция недорога, быстра и легко масштабируется до тысяч роботов:
-
Figure AI научила своего гуманоида ходить, обучая его с подкреплением на тысячах виртуальных копий;
-
OpenAI научила роботизированную руку собирать кубик Рубика, затратив эквивалент 13 000 лет симулированного опыта;
-
к 2019 году беспилотные автомобили Waymo проехали 10 млн миль по реальным дорогам и 10 млрд миль в симуляции.
Главная трудность — разрыв между симуляцией и реальностью (sim-to-real gap). Данные ценны ровно в той мере, в какой точна сама симуляция. Для задач передвижения (локомоции) она работает неплохо: физика ходьбы по пересечённой местности или полёта дрона по маршруту хорошо изучена и поддаётся цифровому моделированию. Зато манипуляции с предметами, особенно мягкими и деформируемыми, смоделировать точно гораздо сложнее.
Частичным решением служит рандомизация домена (domain randomization). Каким будет трение или упругость в реальном мире, заранее неизвестно, поэтому в симуляции эти параметры случайным образом варьируют. Так модель готовится к широкому диапазону значений. В проекте с кубиком Рубика OpenAI пошла дальше и разработала автоматическую рандомизацию (ADR), которая создаёт всё более сложные условия. По словам команды, причина заключалась в том, что трение, упругость и динамику подобных объектов слишком трудно описать точно.
Результат, впрочем, получился скромным: при самых сложных начальных положениях кубика рука справлялась лишь в 20% случаев. Возможно, именно поэтому для обучения манипуляциям этот приём сегодня почти не используют. Зато в локомоции случайное варьирование таких параметров, как коэффициент трения, стало стандартной практикой.
Запись людей
Можно фиксировать, как задачи выполняют люди, а затем переносить их движения на робота. Отчасти поэтому так популярны гуманоиды: для робота с человеческим телом записи людей за работой — естественный источник данных.
Варианты:
-
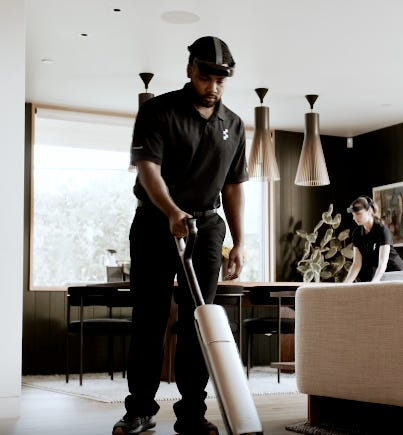
Видео от первого лица (egocentric video) — съёмка камерой, закреплённой на голове. Figure AI запустила программу Index и рассылает людям налобные камеры. Компания может даже направить к вам команду, которая возьмёт на себя домашние дела и заодно запишет весь процесс.
-
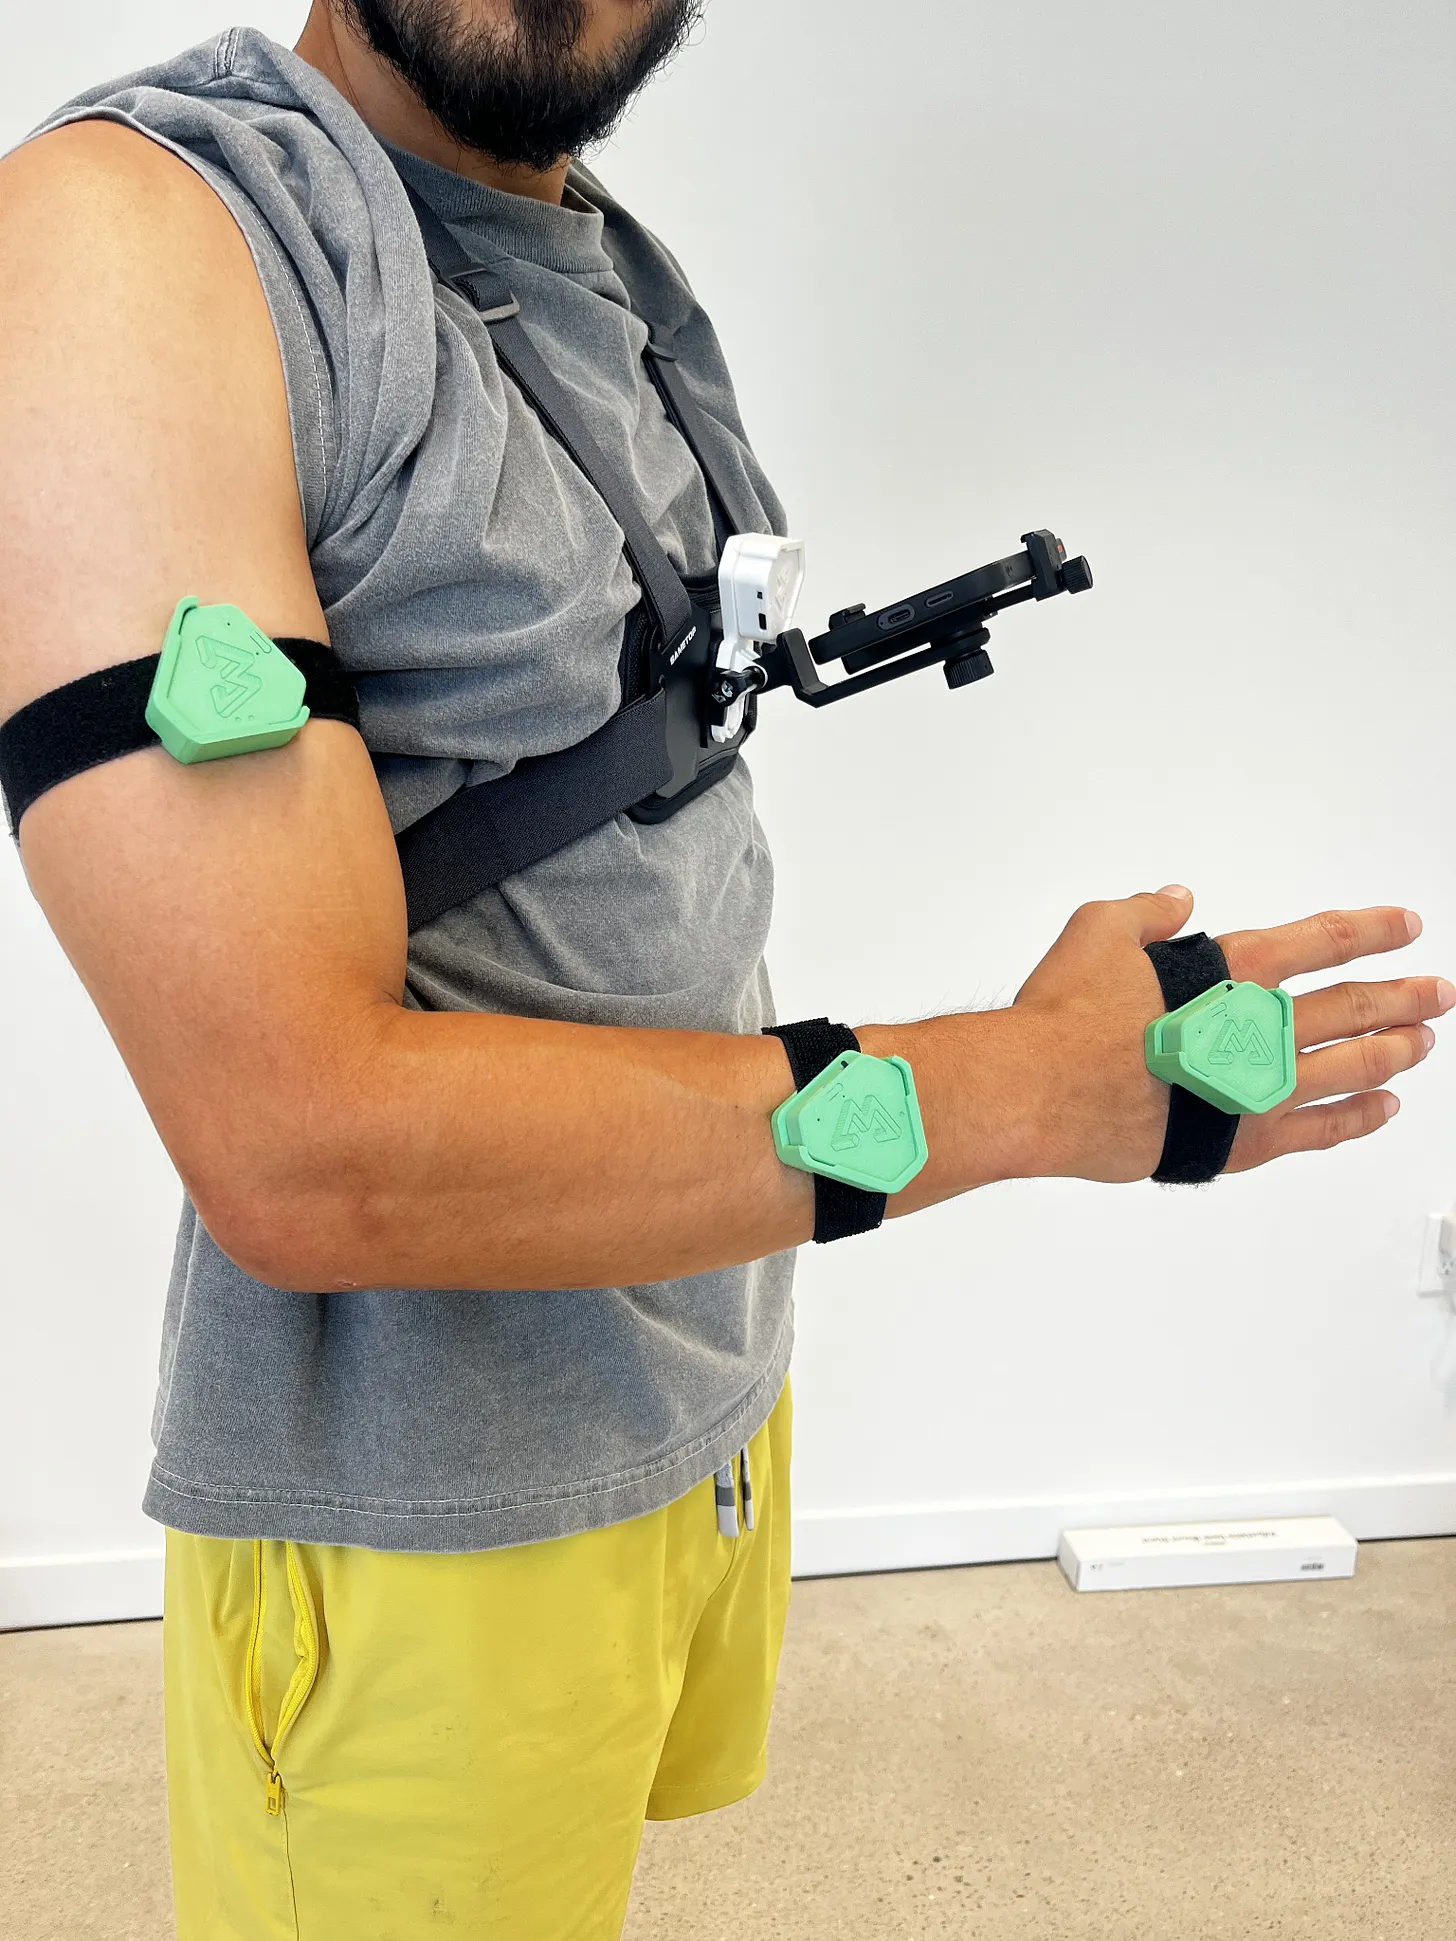
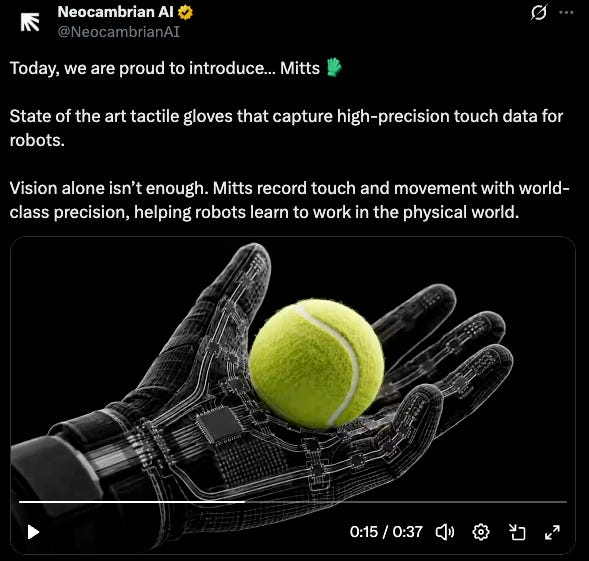
Дополнительные датчики. Закрывшийся стартап Eidon AI закреплял датчики на руках, чтобы фиксировать положение суставов. Neocambrian AI представила Mitts — тактильные перчатки, которые с высокой точностью записывают данные о прикосновениях.
-
UMI (Universal Manipulation Interface) — ручные манипуляторы с камерами и захватом-«клешнёй» (встречаются и многопалые варианты). Человек работает ими так, как работал бы робот, а полученное видео затем используют для обучения роботов с похожими захватами. Именно так в основном собирают данные Generalist AI и Sunday Robotics.
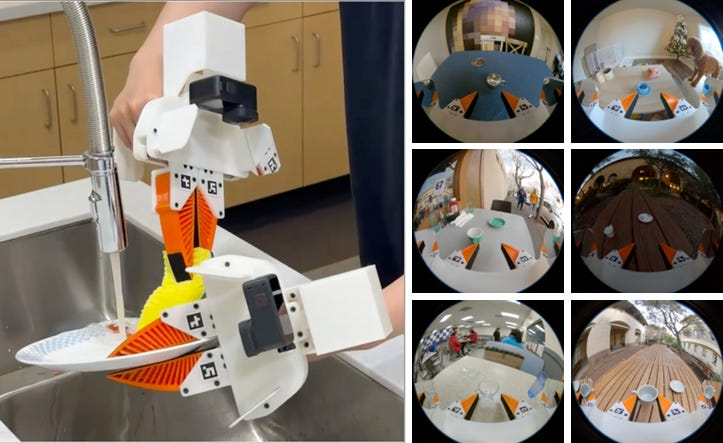
Плюсы: заметно дешевле телеуправления, ведь нужна камера, а не робот. Проще набрать разнообразные задачи. Физика настоящая, а не смоделированная.
Минус: человек — не робот, и его движения не полностью соответствуют возможностям машины. В случае UMI это расхождение минимально. Модели, стоящие за многими из самых впечатляющих демонстраций (например, у Generalist AI), обучены именно на таких данных.
Видео из интернета и сочетание подходов
Модели Vision-Language-Action (VLA) создаются на базе моделей Vision-Language, обученных на текстах и изображениях. Роликов на YouTube и TikTok великое множество, поэтому многие ищут способ учить роботов и на них. Один из примеров — Nvidia Cosmos, фундаментальная модель, обученная именно на таких видео. Её можно использовать как основу (backbone) для модели управления роботом.
На практике подходы часто комбинируют. Digit от Agility Robotics ходит благодаря небольшой нейросети на 1 млн параметров, обученной с подкреплением в симуляции. Манипуляциям его, судя по всему, обучали клонированием поведения. Dyna Robotics, похоже, объединила симуляцию и видео с людьми.
|
Способ |
Сильные стороны |
Слабые стороны |
|---|---|---|
|
Телеуправление |
Данные в точности соответствуют конкретному роботу |
Дорого, плохо масштабируется, нет тактильной обратной связи |
|
Реальные роботы |
Потенциально крупнейший источник |
Роботов мало, данные однообразны |
|
Симуляция |
Недорого, быстро, легко масштабируется |
Sim-to-real gap, особенно в манипуляциях |
|
Запись людей (видео, перчатки, UMI) |
Недорого, разнообразно, реальная физика |
Движения человека не совпадают с движениями робота |
|
Видео из интернета |
Колоссальный объём |
Способы его применения ещё предстоит найти |
Сколько данных уже накоплено
Датасеты для роботов стремительно растут:
-
Open X-Embodiment (Google DeepMind, 2023) объединяет несколько десятков датасетов: более 1 млн траекторий, свыше 160 000 задач и около 4000 часов записей;
-
Pi 0 (Physical Intelligence, октябрь 2024) обучен на 10 000 часов данных с роботов;
-
GEN 1 (Generalist AI, 2026) обучен примерно на 500 000 часов данных UMI;
-
Dyna Robotics и Nature Will заявляют о более чем 1 млн часов видео от первого лица;
-
Figure AI через Index получает 30 минут видео ежесекундно, то есть 43 000 часов в сутки.
По одной из оценок, вся индустрия в совокупности набирает около 500 000 часов обучающих данных в месяц.
Почему сравнивать с текстом непросто
Во-первых, данные неравноценны. Записи телеуправления и UMI ценнее обычного видео от первого лица, а разнообразный датасет полезнее однообразного. Во-вторых, видео беднее текста по информативности, поскольку соседние кадры почти не отличаются друг от друга. Робототехник Крис Пакстон (Chris Paxton) подчёркивает: чем ближе обучающая выборка к независимой и одинаково распределённой (iid), тем эффективнее работает машинное обучение. Интернет-материалы этому идеалу соответствуют не вполне, а записи с роботов — и подавно.
Разрыв в 100 000 лет
Грубое сопоставление всё же возможно. Исследователь Physical Intelligence Кевин Блэк и профессор робототехники Кен Голдберг предлагают пересчитать текстовые датасеты в часы, которые потребовались бы человеку на их прочтение:
|
Датасет или модель |
Год |
Тип данных |
Тыс. часов |
|---|---|---|---|
|
OXE |
2023 |
Роботы: телеуправление + автономная работа |
4 |
|
Pi 0 |
2024 |
Роботы: телеуправление |
10 |
|
GPT-1 |
2018 |
LLM |
69 |
|
GPT-2 |
2019 |
LLM |
475 |
|
GEN 1 |
2026 |
Роботы: UMI |
500 |
|
Dyna-2 |
2026 |
Роботы: видео от первого лица |
1 000 |
|
Natura-1 |
2026 |
Роботы: видео от первого лица |
1 000 |
|
GPT-3 |
2020 |
LLM |
26 000 |
|
GPT-4 |
2023 |
LLM |
685 000 |
Самые крупные датасеты для роботов составляют около 1 млн часов. Получается, что даже модели, вышедшие несколько лет назад, обучались примерно на порядки больше — в 1000 раз большем объёме данных. Голдберг называет это «разрывом в 100 000 лет».
Пакстон в блоге «It Can Think!» подходит к вопросу с другой стороны: он переводит часы видео в токены. Вывод получается схожим:
10 кадров/с × 3600 с  = 36 000 токенов в час (1 кадр ≈ 1 полезный токен)
36 000 / 10           ≈ 3 600 токенов в час (полезна не каждая секунда)
1 млн часов × 3 600   ≈ 3,6 млрд токенов
Это примерно в 5000 раз меньше, чем объёмы датасетов современных ИИ-моделей.
Во сколько обойдётся догнать LLM
Предположим, что данных нужно в 1000 раз больше, чем есть сейчас, то есть порядка
Похожие статьи
 Как проверенные временем паровое и водяное отопление работают в современных небоскрёбах?
 Старые технологии, которые не прижились: странные изобретения прошлого. Часть 5
 Электронный микроскоп: прибор, позволяющий разглядеть атомы
 Как распознать психопата по тексту: тёмные черты личности отражаются в нашей речи
 Как осмыслить резонанс, если мы привыкли воспринимать мир как неподвижный?
 Профессор, калькулятор и 475 миллионов долларов убытка Intel
 Как доктор Живаго выносит приговор целой эпохе
 ИИ-сотрудник за один день разобрал 1072 открытые задачи теории групп, и одна из них, похоже, поддалась