Как школьная алгебра за 7 класс спасает softmax от затухания градиентов
Вообразите ситуацию: нейросеть практически безошибочно освоила верный ответ. Функция потерь ещё фиксирует погрешность, однако градиент по логиту правильного класса уже занулился машинной арифметикой. И наоборот: в ином сценарии модель-ученик абсолютно зеркально копирует наставника — но тем не менее генерирует ненулевой сигнал ошибки.
Оба этих казуса напрямую затрагивают привычные нам функции softmax и cross-entropy.
22 октября 2026 года исследователи из Google DeepMind — Джонатан Баррон (Jonathan T. Barron), Дэн Гнанапрагасам (Dan Gnanapragasam) и Майкл Тшаннен (Michael Tschannen) — выпустили препринт A Fix for Softmax and Cross-Entropy. Авторы детально исследовали два вычислительных изъяна (в публикации они получили названия Softmax Collapse и Softmax Cancellation), обнаруженных в базовых библиотеках вроде PyTorch и JAX, и презентовали патчи, полностью сохраняющие изначальную математическую логику.
Означает ли это, что все эти годы нейросети обучались некорректно? Разумеется, нет. Тем не менее кейс крайне любопытный: порой для кардинального изменения динамики обучения достаточно иначе записать банальную школьную дробь. Давайте обратимся к цифрам, графикам и фрагментам кода.
По моему глубокому убеждению, эти материалы достойны включения в академические программы — в один ряд с устойчивым расчетом сигмоиды и защитой от переполнения в том же softmax.
Что мы детально разберем:
-
От задачи классификации к градиенту: наглядный пример с котиками и собаками.
-
Вторая аномалия: ученик полностью скопировал учителя, но градиент остался ненулевым.
-
Практические последствия для обучения и что проинспектировать в собственном коде.
Начнем с базового кейса: учим алгоритм отличать кота от собаки
Допустим, наша модель занимается классификацией изображений. На вход подается снимок кота. В тренировочном датасете эталонная метка известна заранее: кот.
На текущем этапе модель еще может ошибаться, но наша цель — скорректировать её параметры 
Сперва нейросеть выдает пару сырых чисел — логиты 

Преобразование Softmax переводит их в вероятности 

Для нашего конкретного кадра это отрицательный логарифм вероятности кота: чем ближе этот показатель к единице, тем меньше штрафные санкции.
Затем запускается обратный проход.
Мы вычисляем градиент — вектор частных производных функции потерь, отражающий степень изменения штрафа при микроскопической модификации каждого логита.
Опираясь на эти производные и архитектуру самой нейросети, мы находим градиенты по весам, после чего оптимизатор производит обновление коэффициентов
Сами логиты формируются на основе изображения и текущих весов; мы не обучаем изолированно два фиктивных числа «кот» и «собака». Однако любая неточность в производных по логитам неизбежно транслируется дальше, искажая корректировку всей сети.
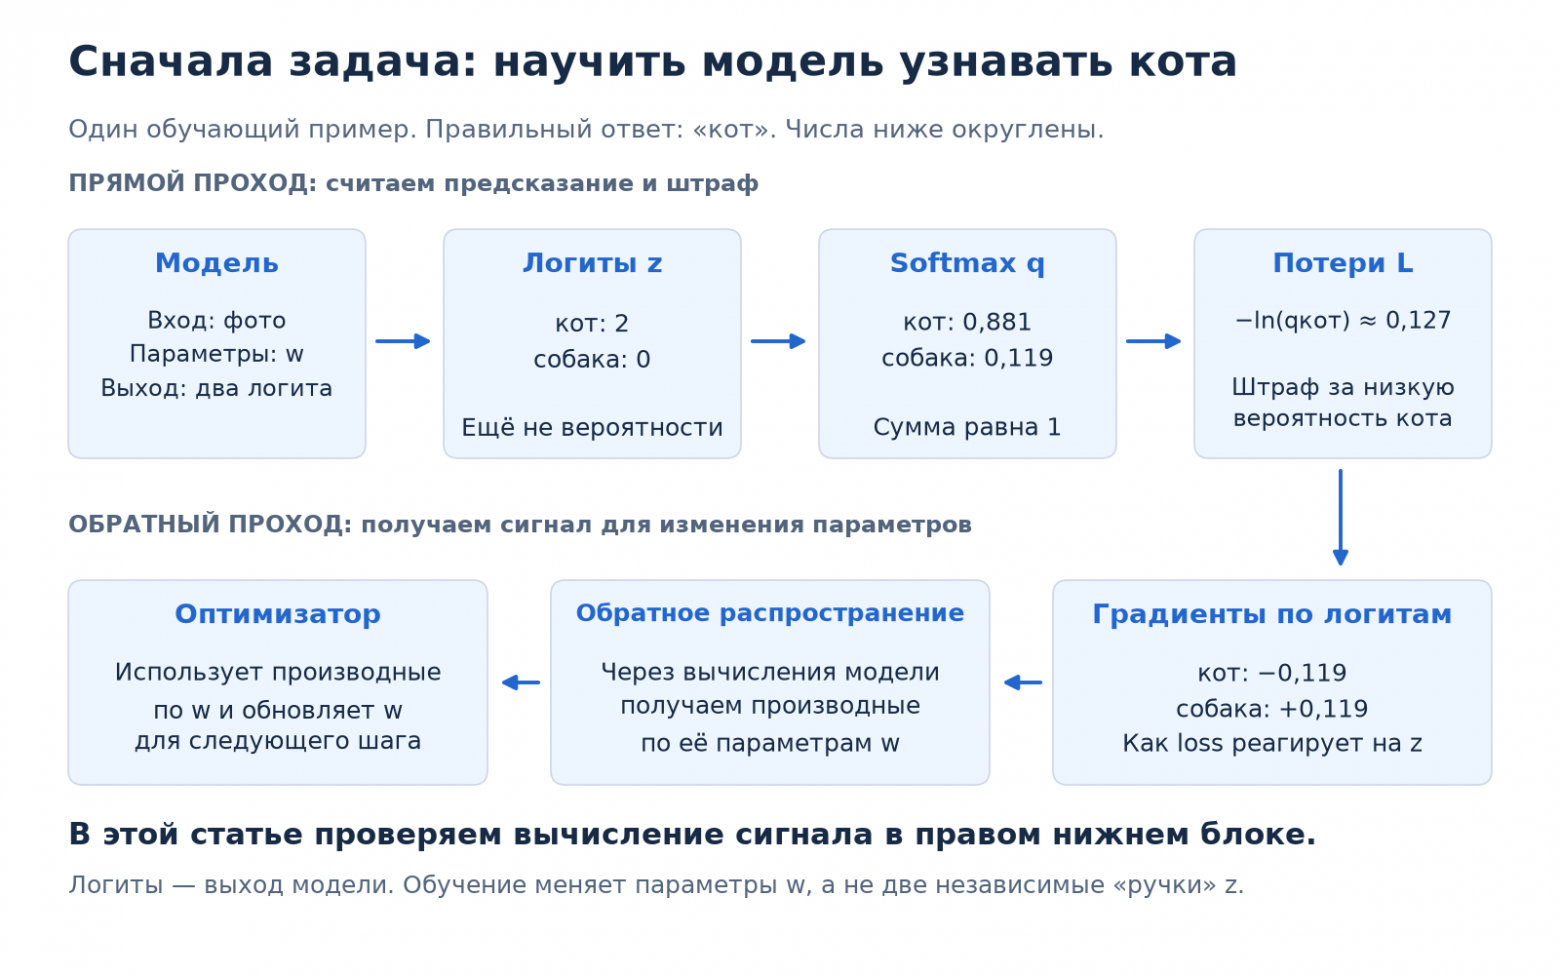
Схема 1. Прямой проход генерирует вероятности и уровень штрафа. Обратный проход вычисляет производные, на базе которых оптимизатор модифицирует веса модели.
Именно в этот момент можно корректно сформулировать главный вопрос статьи: насколько точно вычислительная машина рассчитывает данные производные, если модель демонстрирует абсолютную уверенность в ответе?
Для проверки вовсе не обязательно прогонять тяжеловесную нейросеть. Достаточно зафиксировать готовые логиты и сопоставить ожидаемый математический градиент с тем, что выдает компьютер.
В бинарном частном случае мы получаем хорошо знакомую сигмоиду
Обозначим разницу логитов как 
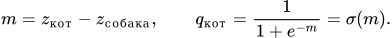
В строгой математике вторая вероятность равна 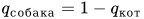

Поскольку верным ответом является кот, формула потерь принимает вид:
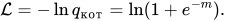
Производная по 
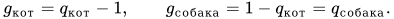
Возьмем стандартный умеренный пример: логиты [2, 0], то есть 
Знаки имеют вполне интуитивную интерпретацию. Если при прочих равных слегка завысить логит кота, штраф снизится, поэтому производная отрицательна. Если же увеличить логит собаки, штраф возрастет — производная положительна. При стандартном градиентном спуске мы движемся против градиента. На этом этапе никаких вычислительных аномалий не наблюдается.
А где же обещанная защита от переполнения?
Она создана для предотвращения совершенно иных проблем. Например, логиты [1020, 1000] дают ровно такую же разницу в 20 единиц, что и [20, 0]. Однако попытка напрямую вычислить 

float32: вместо конечных чисел возникнут бесконечности, а последующая нормировка выдаст NaN.
Общепринятый трюк — предварительное вычитание максимума из всех логитов перед экспоненцированием. Из набора [1020, 1000] мы получаем [0, −20], а экспоненты составят 1 и примерно 2.06·10⁻⁹. Обе величины прекрасно укладываются в рамки float32.
Почему это допустимо? Мы делим каждую экспоненту на один и тот же коэффициент пропорциональности, благодаря чему их относительные доли в общей сумме остаются неизменными. Для двух классов формула выглядит так:
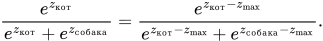
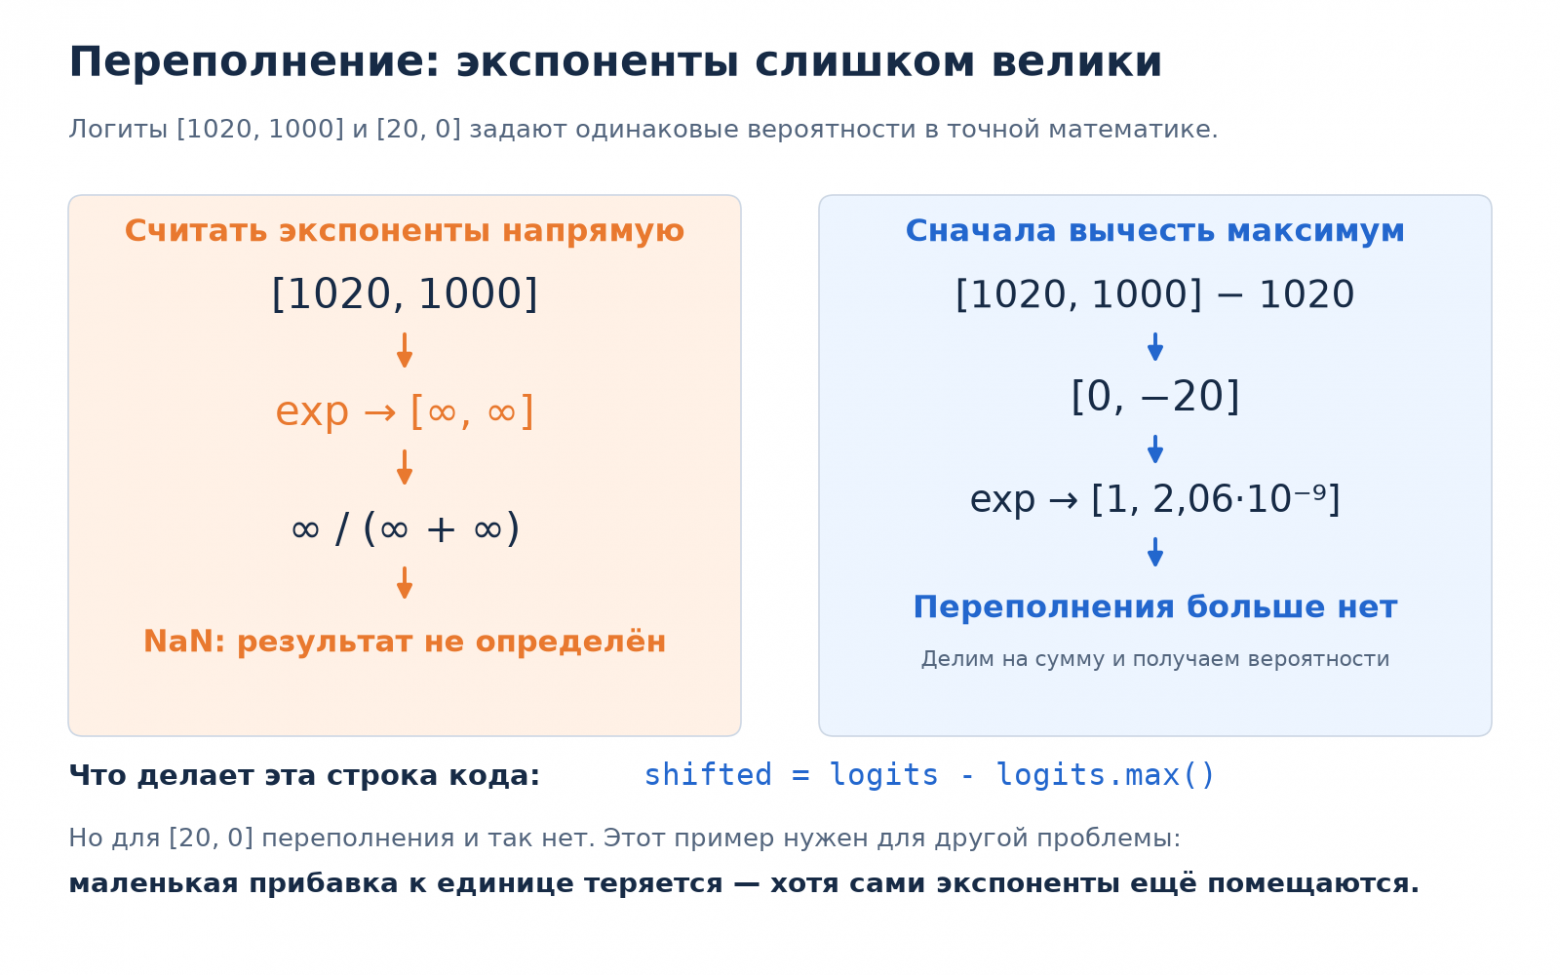
Схема 2. Смещение [1020, 1000] → [0, −20] сохраняет корректность вероятностей и позволяет рассчитать экспоненты без экстремального переполнения.
Общая проблематика уже освещалась на SE7ENе в материале «Откуда в обучении берётся nan: численная нестабильность в ML и почему всё считают в логарифмах» за авторством экспертов OTUS. Там основное внимание уделено переполнениям, возникновению NaN и переходу к логарифмическим вычислениям.
В нашем тестовом сценарии [20, 0] никакой угрозы переполнения не существует: даже 
float32. Мы всё равно применяем стандартную защиту с вычитанием максимума, однако она абсолютно бессильна против другого фундаментального изъяна — нивелирования микроскопической прибавки на фоне единицы.
Первая аномалия: исчезновение одной из компонент градиента
Представим, что наша модель стала ещё более самоуверенной: логиты составляют [20, 0], правильным ответом по-прежнему числится кот. Зафиксируем малый относительный вес второго класса через параметр 
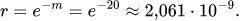
Тогда вероятность 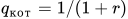
Давайте проанализируем стандартный расчет первой компоненты:
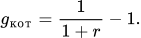
Формат float32 оперирует примерно семью значащими десятичными знаками. Сама величина 

Вероятность собаки Softmax вычисляет отдельно в виде 
Решение этой проблемы заимствовано из школьного курса алгебры. Приведем дроби к единому знаменателю:
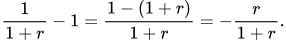
Теперь миниатюрное число оказывается в числителе. Даже если знаменатель округлится до единицы, итоговое значение будет эквивалентно 
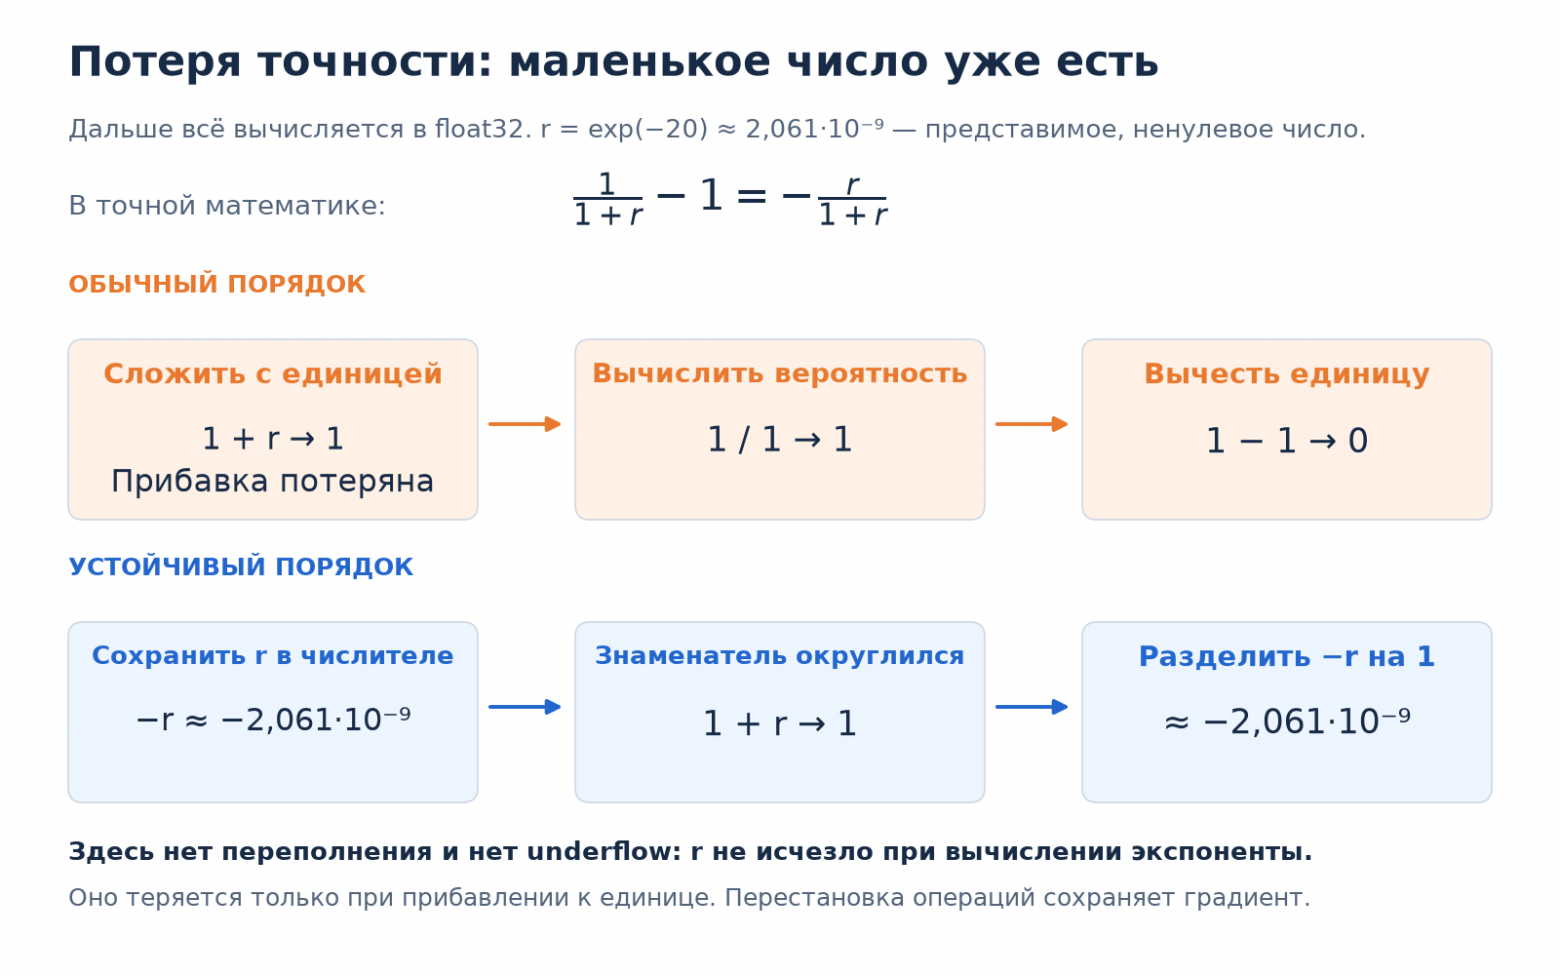
Схема 3. Традиционная запись теряет r в операции 1 + r, в итоге давая ноль. Эквивалентная дробь −r / (1 + r) успешно сохраняет крошечную отрицательную компоненту.
Протестируем это на Python
Мы четко понимаем, что именно тестируем и какой результат ожидаем увидеть. В нашем скрипте первый класс соответствует коту, второй — собаке; target = 0. Инструкция shifted = logits - logits.max() реализует ту самую страховку от переполнения. Затем вычисляются вероятности через softmax, а из вероятности правильного класса вычитается единица:
import numpy as np

logits = np.array([20.0, 0.0], dtype=np.float32)

# Стандартная схема softmax с защитой от переполнения.
shifted = logits - logits.max()
e = np.exp(shifted)
probs = e / e.sum()

# Производные cross-entropy по логитам, target = 0.
grad = probs.copy()
grad[0] -= np.float32(1.0)

print(f"Вероятности: {probs}")
print(f"Градиент:    {grad}")
print(f"Сумма градиентов: {grad.sum():.6e}")
Вероятности: [1.0000000e+00 2.0611537e-09]
Градиент:    [0.0000000e+00 2.0611537e-09]
Сумма градиентов: 2.061154e-09
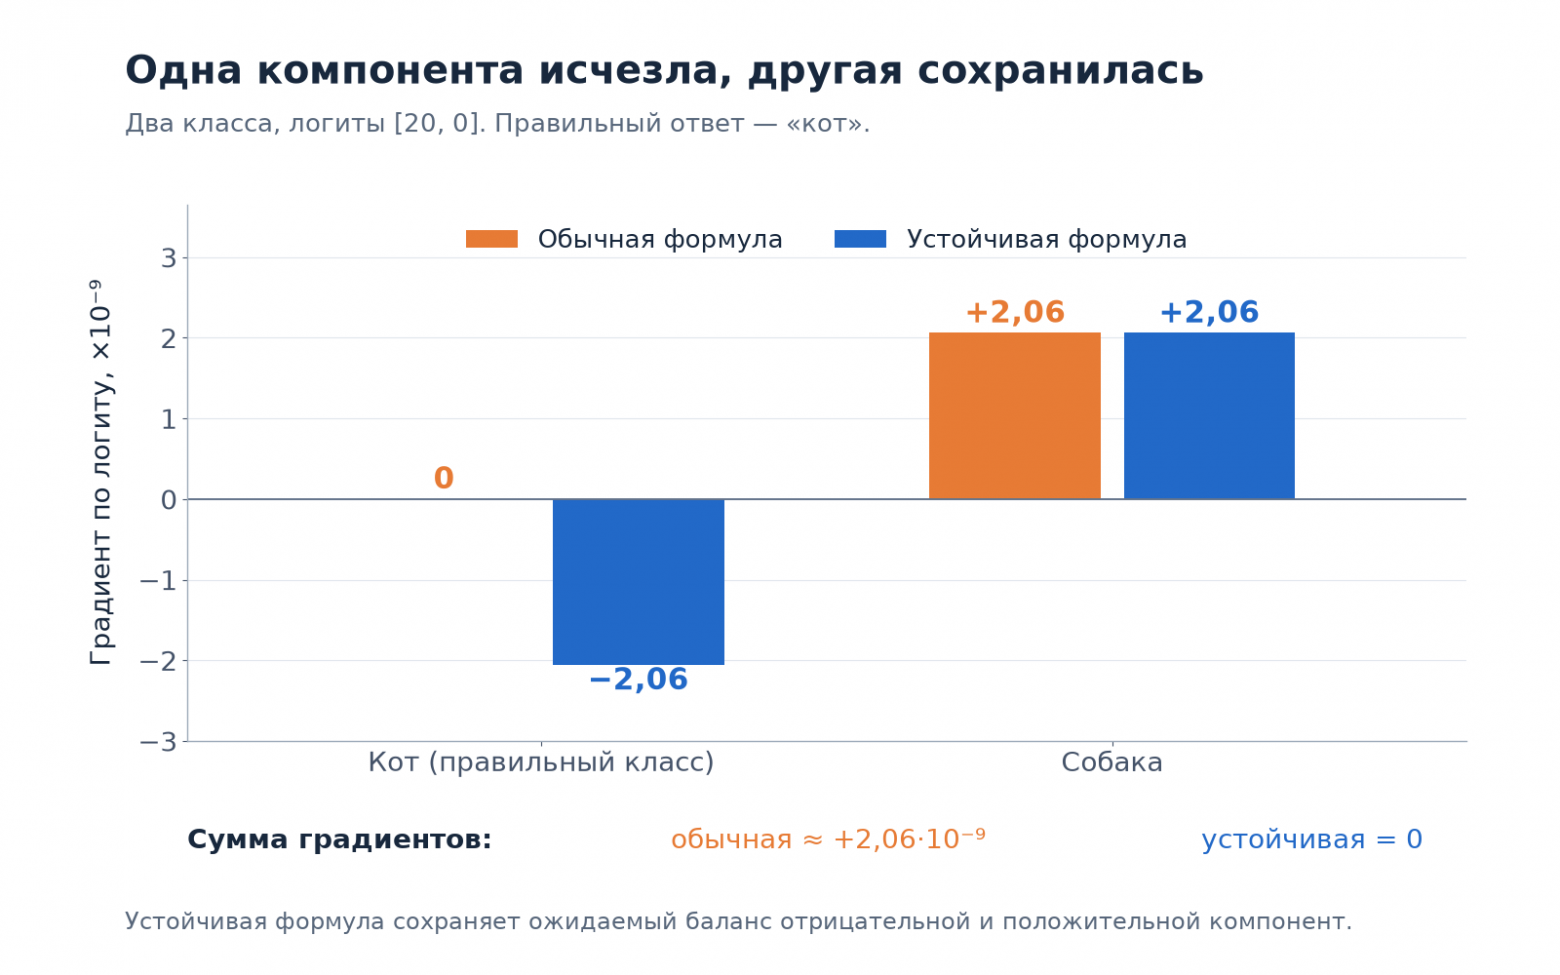
Рис. 1. Для логитов [20, 0] корректный градиент включает две противоположные компоненты. При обычном расчете в float32 отрицательная составляющая исчезает, а положительная сохраняется. Собственный численный пример; цифры округлены для читаемости.
Для кота ожидалось значение порядка −2.06·10⁻⁹, а на выходе получился ровно ноль. У собаки положительная компонента уцелела. Перед нами классический пример Softmax Collapse. Исчезновение одной составляющей не означает немедленную остановку обучения всей нейросети: сигналы от остальных классов продолжают поступать в обратном направлении, но они уже искажены.
Сумма производных здесь выступает удобным инструментом проверки корректности вычислений, а не самоцелью обучения. В идеальной математике она равна нулю: добавление константы ко всем логитам не меняет ни вероятностей, ни потерь. В нашем эксперименте ожидаемые плюс и минус должны взаимно компенсироваться, однако машинный ноль и положительное число уже не гасят друг друга.
Данный тест демонстрирует особенности вычислительного конвейера NumPy. Поведение вашего бэкенда в PyTorch или JAX требует профилирования в вашей среде выполнения. А вопрос о том, способны ли столь микроскопические погрешности заметно влиять на процесс обучения, мы обсудим чуть ниже на основе данных авторов.
Если классов больше двух
В реальных задачах вместо собаки могут выступать тысячи альтернативных классов. Обозначим правильный класс индексом 


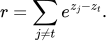
Формулы остаются неизменными: 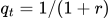
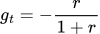
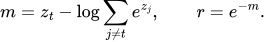
В бинарном сценарии мы получаем прежнюю разницу двух логитов. При наличии множества классов отрыв рассчитывается относительно всей массы конкурентов одновременно, а не только по отношению к ближайшему сопернику. Чем выше
Где пролегает критическая точка срыва
Тип данных float32 выделяет 23 явно хранимых бита под дробную часть плюс один неявный ведущий бит для нормализованных чисел. Шаг дискретизации между единицей и следующим представимым числом составляет 

Для данной архитектуры вычислений ориентировочный порог можно записать следующим образом:
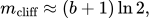
где 
|
Формат вычислений |
Битов в мантиссе |
Порог срыва |
|---|---|---|
|
bfloat16 |
7 |
≈ 5.54 |
|
float16 |
10 |
≈ 7.62 |
|
float32 |
23 |
≈ 16.63 |
|
float64 |
52 |
≈ 36.74 |
Здесь указаны пороги арифметики конкретной операции. Использование весов в формате bfloat16 вовсе не гарантирует, что функции Softmax и Loss обсчитываются в нём же: механизмы смешанной точности часто выполняют чувствительные расчеты в float32. Кроме того, данная таблица не отменяет необходимости профилирования библиотечного ядра.
Как потеря градиента выглядит графически
Сопоставим традиционную формулу 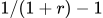

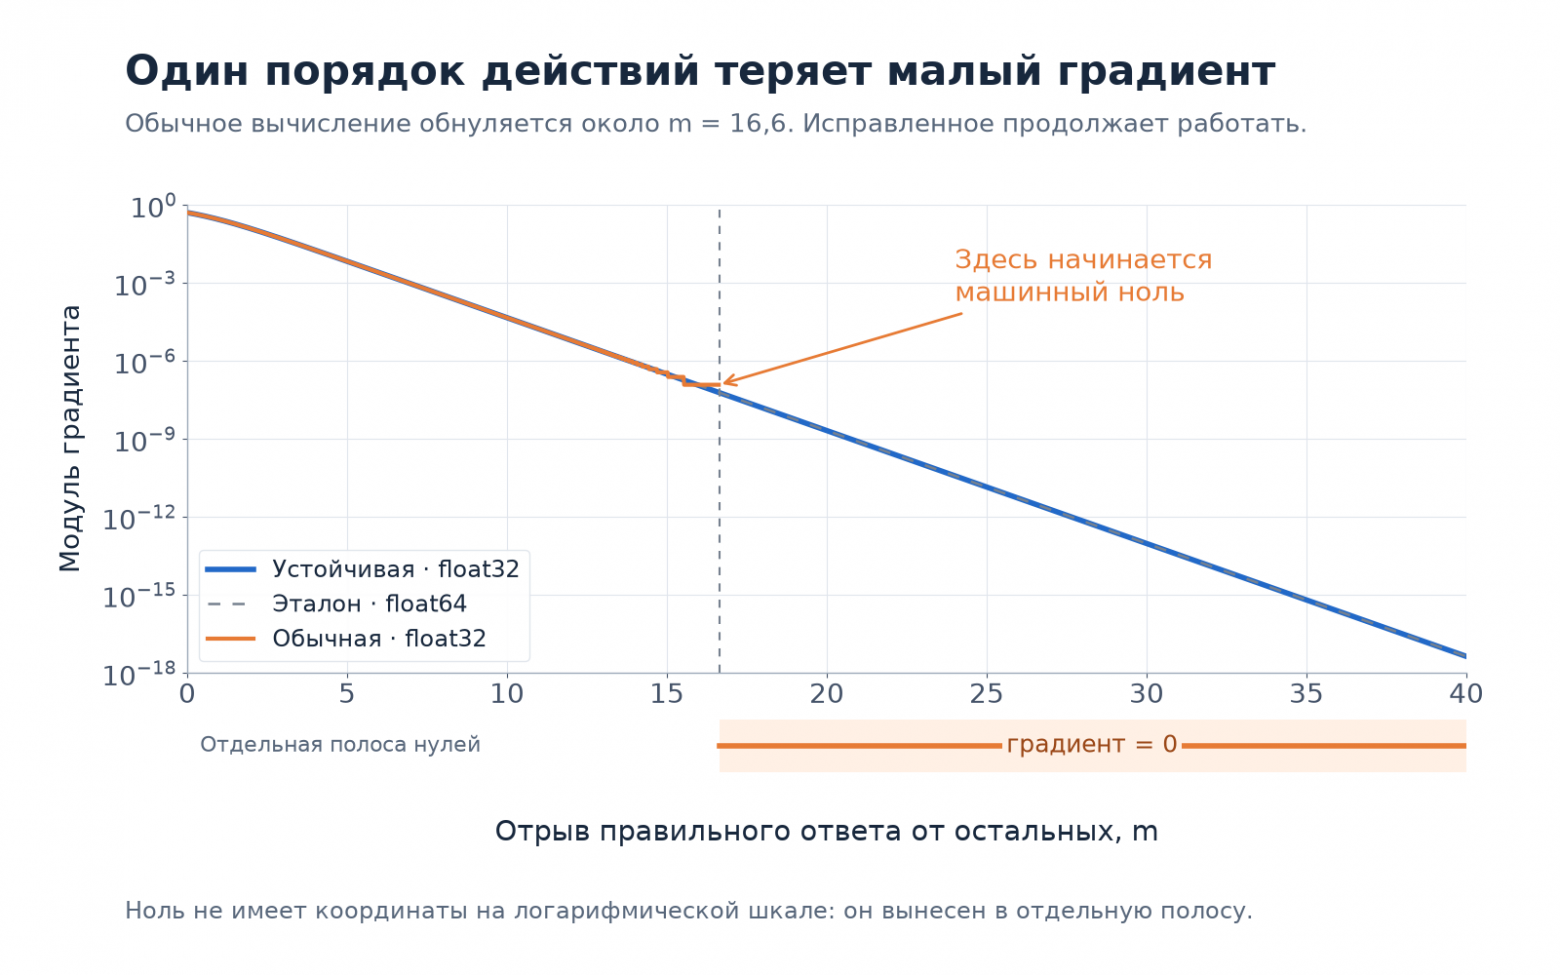
Рис. 2. Зависимость модуля градиента верного класса от маржи m. В классической схеме float32 градиент обнуляется приблизительно при m = 16.6. Устойчивый вариант продолжает плавно уменьшаться синхронно с эталоном. Машинный ноль вынесен отдельно: в логарифмическом масштабе он не имеет конечной координаты.
Проверим ряд контрольных точек по графику:
import numpy as np

m = np.array([10, 15, 16, 17, 20, 30], dtype=np.float32)
one = np.float32(1.0)
r = np.exp(-m)

usual = one / (one + r) - one
fixed = -r / (one + r)

for margin, a, b in zip(m, usual, fixed):
    print(f"m={margin:2.0f}: usual={a: .6e}, fixed={b: .6e}")
m=10: usual=-4.541874e-05, fixed=-4.539786e-05
m=15: usual=-3.576279e-07, fixed=-3.059022e-07
m=16: usual=-1.192093e-07, fixed=-1.125352e-07
m=17: usual= 0.000000e+00, fixed=-4.139937e-08
m=20: usual= 0.000000e+00, fixed=-2.061154e-09
m=30: usual= 0.000000e+00, fixed=-9.357623e-14
Бесконечной точности это, разумеется, не гарантирует. Если экспонента окажется слишком малой для выбранного типа данных, произойдет underflow — округление до нуля у нижней границы представимых чисел. Предлагаемый патч устраняет преждевременную потерю сигнала при сложении с единицей, однако он не способен расширить аппаратный диапазон чисел процессора или ускорителя.
Вторая аномалия: Softmax Cancellation
Теперь слегка изменим условия задачи. В процессе дистилляции знаний (knowledge distillation) мы тренируем модель-ученика имитировать предсказания замороженной модели-учителя. Предположим, учитель выдает для фотографии 70% уверенности в коте и 30% в собаке. Наша задача — заставить ученика воспроизвести именно это распределение вероятностей, а не обязательно доводить вероятность кота до абсолютной единицы.
Здесь 


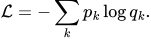
А её производная по логиту ученика выглядит так:
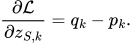
Когда ученик в точности повторяет распределение учителя, стимулы для дальнейшей корректировки отсутствуют: градиент обязан обратиться в ноль. При этом сама кросс-энтропия обычно не равна нулю — она эквивалентна энтропии распределения учителя. В момент полного совпадения нулевыми становятся именно градиент и KL-дивергенция (мера расхождения двух распределений).
Тем не менее вероятности могут вычисляться по разным алгоритмам: например, для учителя — через деление экспонент, а для градиента ученика — через экспоненту от результата log_softmax. В строгой математике результаты тождественны, но из-за округлений младшие биты могут расходиться.
Для численного тестирования возьмем три класса и идентичные логиты учителя и ученика [2, 1, 0].
import numpy as np

z = np.array([2.0, 1.0, 0.0], dtype=np.float32)
shifted = z - z.max()
e = np.exp(shifted)

p = e / e.sum()                         # путь через softmax
q = np.exp(shifted - np.log(e.sum()))   # через log_softmax

noise = q - p
print(noise)
print(f"Норма: {np.linalg.norm(noise):.6e}")
[ 0.0000000e+00  1.4901161e-08 -1.4901161e-08]
Норма: 2.107342e-08
Логиты совпали тютелька в тютельку, а посчитанный градиент — нет. Это не означает, что компьютер способен сгенерировать ненулевой итог из операции x - x: здесь происходит вычитание чисел, которые уже успели микроскопически разойтись из-за применения различных вычислительных веток.
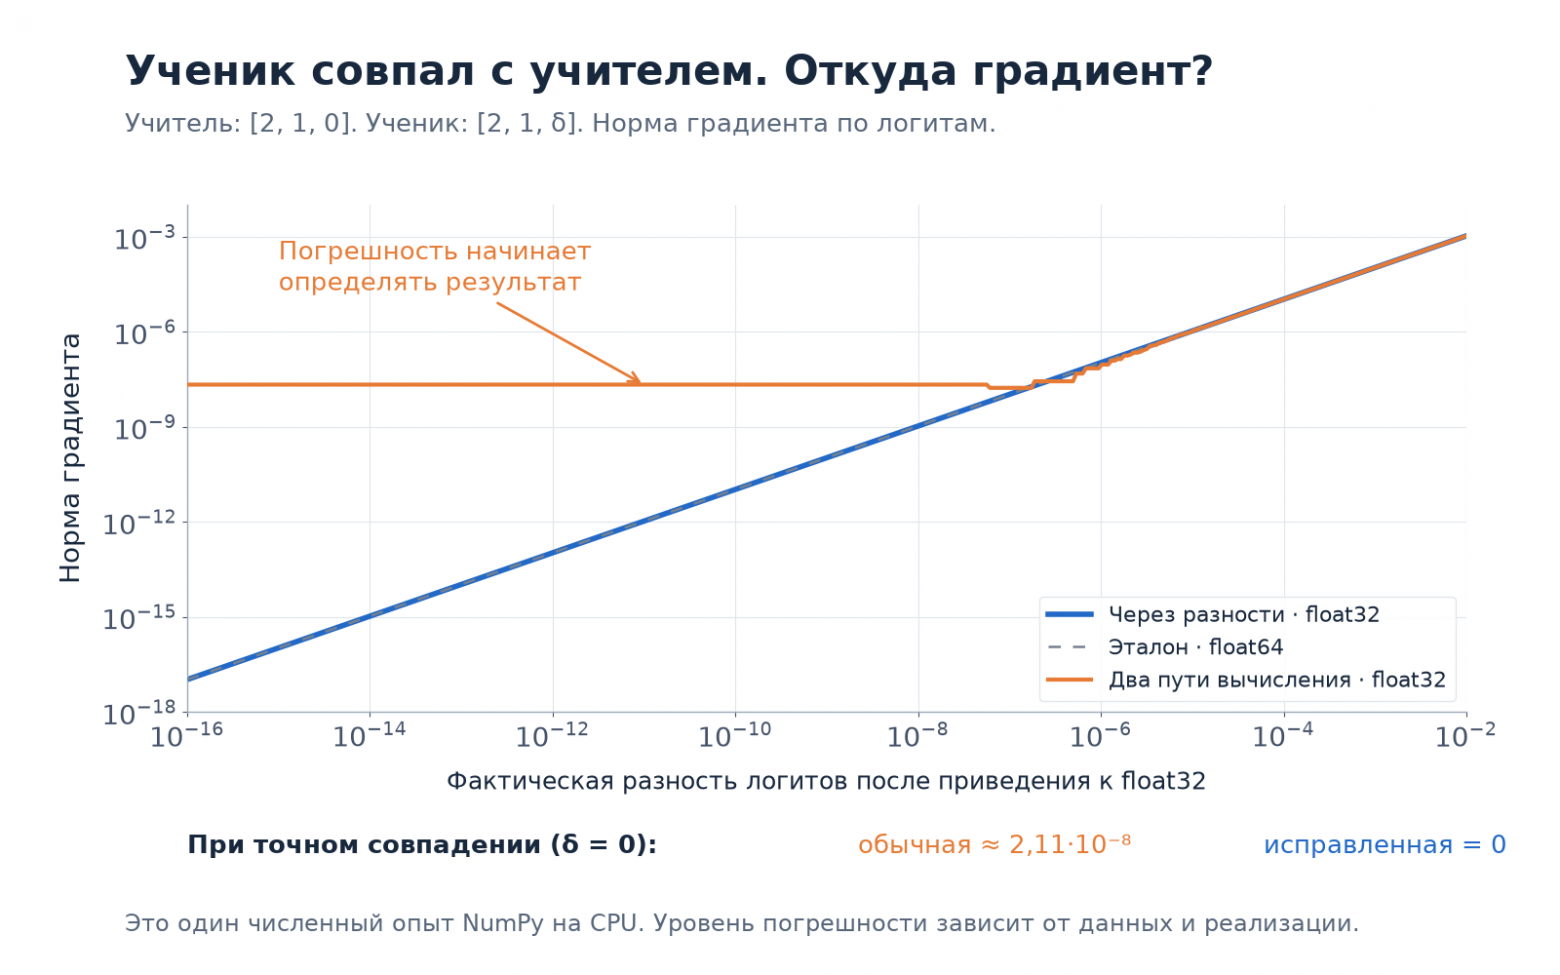
Рис. 3. Логиты учителя составляют [2, 1, 0], а ученика — [2, 1, δ]. По горизонтали отложено минимально представимое в float32 расхождение логитов; по вертикали — норма градиента. По мере сближения моделей погрешность стандартного расчета начинает доминировать в результате. Точное математическое совпадение показано изолированно. Масштаб ошибки зависит от данных, разрядности и особенностей реализации.
Предложенный патч: предварительное сравнение логитов
Авторы исследования рекомендуют вычислять малую разницу вероятностей напрямую через разницу логитов. Пройдем этот алгоритм по шагам, чтобы нагромождение символов не превратилось в нечитаемую стену.
Шаг 1. Находим расхождение между учеником и учителем.
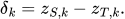
Шаг 2. Вычитаем среднее расхождение, взвешенное вероятностями учителя. Полученные промежуточные величины обозначим как 
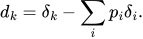
Шаг 3. Рассчитываем миниатюрную поправку к вероятности. Для удобства обозначим общий нормирующий член буквой 
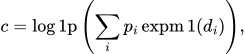
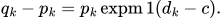
Функция expm1(x) вычисляет выражение 
log1p(x) возвращает 
x, тогда как прямой расчет с явным добавлением или вычитанием единицы безвозвратно теряет значащие разряды.
В строгой математике мы получаем ровно ту же разность 


expm1(0), выдав чистый машинный ноль.
Тест исправленного алгоритма при идентичных логитах: короткий листинг на NumPy
import numpy as np

teacher = np.array([2.0, 1.0, 0.0], dtype=np.float32)
student = teacher.copy()

e = np.exp(teacher - teacher.max())
p = e / e.sum()

delta = student - teacher
d = delta - np.sum(p * delta)
c = np.log1p(np.sum(p * np.expm1(d)))
gradient = p * np.expm1(d - c)

print(gradient)  # [0. 0. 0.]
Это локальная демонстрация для близких логитов, а не готовый пайплайн обучения. При значительных расхождениях потребуются дополнительные меры стабилизации; полноценную реализацию лучше подсмотреть в первоисточнике.
Почему даже незначительная погрешность способна влиять на обучение
Может показаться: кому есть дело до градиента порядка одной стомиллионной доли? Однако величина шага оптимизации определяется не только самим градиентом, но и структурой оптимизатора.
В качестве примера возьмем алгоритм Adam, который нормирует накопленный сигнал относительно оценки его недавнего масштаба:
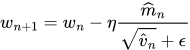
Здесь 


В условиях Softmax Collapse искаженный градиент по логитам распространяется по сети, влияя на производные по весам. Последствия зависят от конкретной архитектуры, остальных примеров в батче и текущего состояния оптимизатора. Один лишь искусственный пример на двух числах не доказывает фатального изменения динамики обучения — здесь требуются масштабные эксперименты.
Авторы связывают подобную асимметрию с эффектом Slingshot («рогатка»): после длительных периодов низких потерь в процессе обучения неожиданно возникают резкие скачки loss. В тестах исследователей замена численной схемы полностью устраняет эти всплески и меняет дальнейшую траекторию оптимизации.
На иллюстрации ниже сопоставляются два экспериментальных режима. Weight decay — это регуляризация, плавно уменьшающая веса модели; в верхнем эксперименте она задействована, а в нижнем отключена.
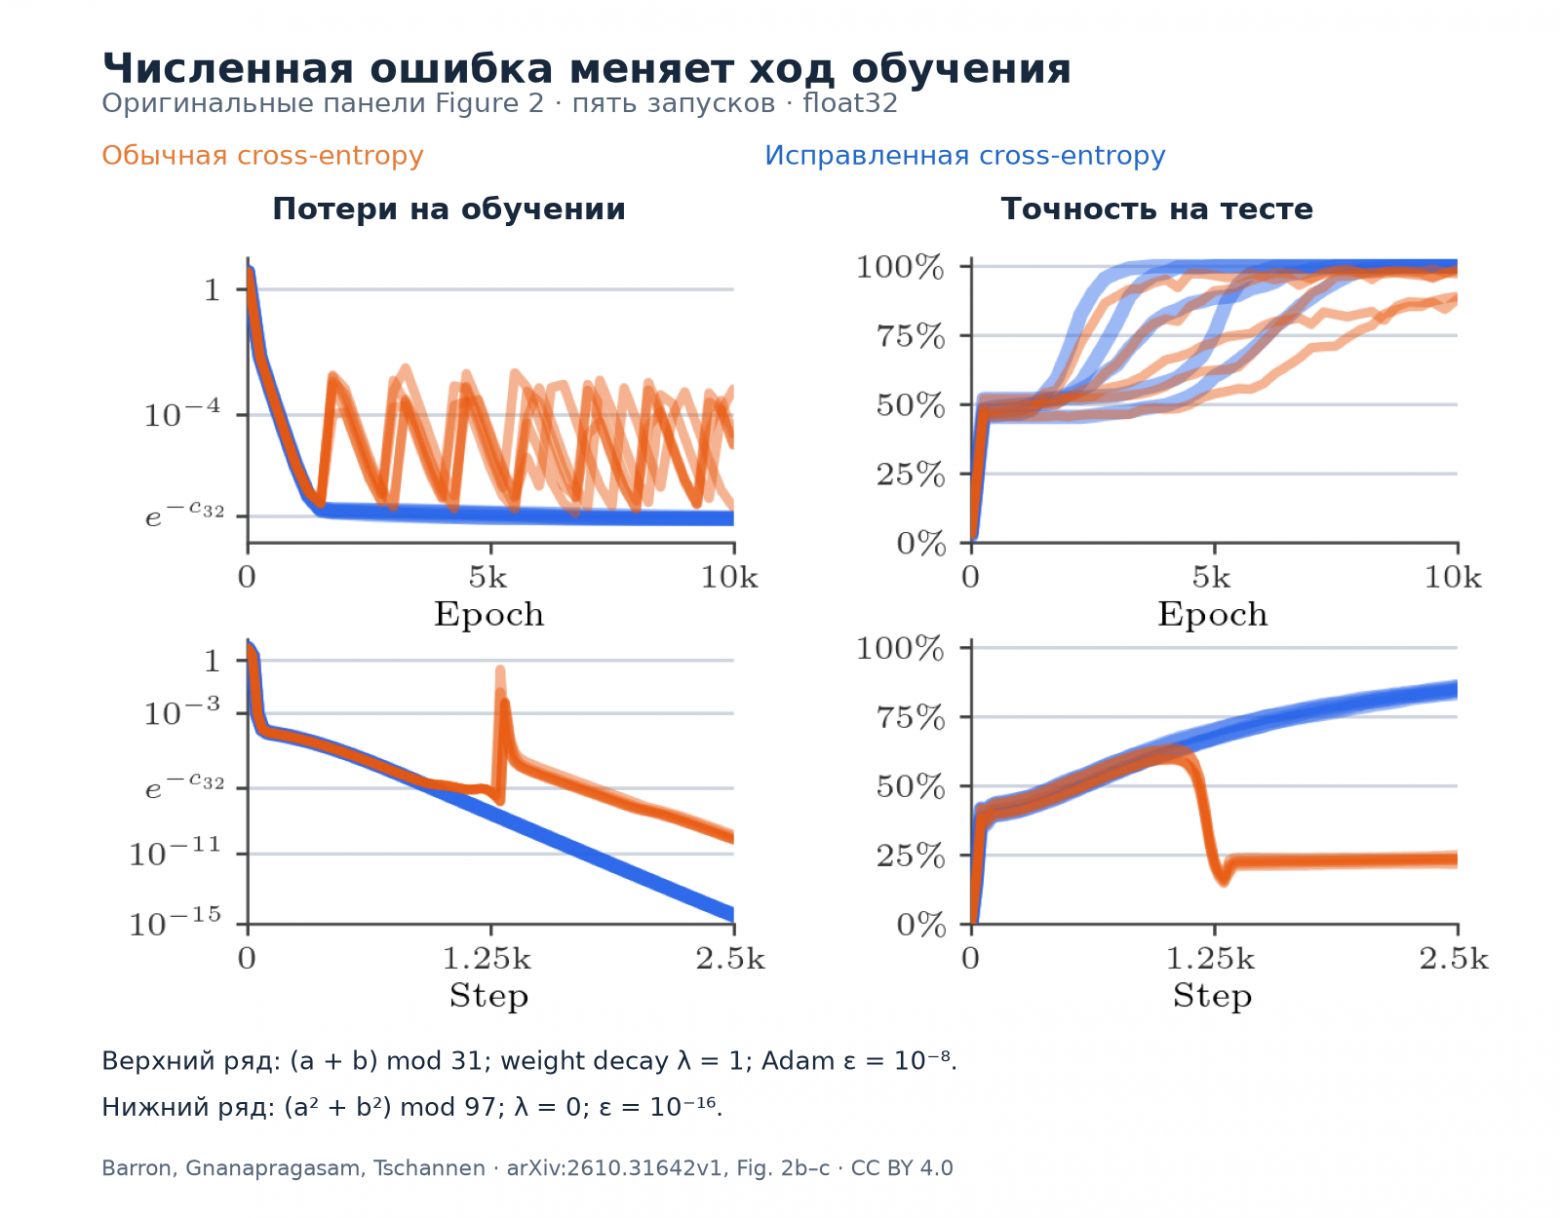
Рис. 4. Оригинальные графики Figure 2b,c из работы Баррона, Гнанапрагасама и Тшаннена с русскоязычными пояснениями. Слева отражен уровень потерь, справа — тестовая точность. Сверху: сложение по модулю 31, weight decay λ = 1, Adam ε = 10⁻⁸. Снизу: (a² + b²) mod 97, λ = 0, ε = 10⁻¹⁶. Расчеты выполнены в float32, сделано пять запусков с различными случайными сидами. Термин Epoch обозначает эпохи, Step — шаги оптимизации, а c₃₂ ≈ 16.6 соответствует порогу срыва. Источник: секция 4 препринта, CC BY 4.0. Перед нами исходные эмпирические данные авторов, а не наша симуляция процесса обучения.
Это гораздо более весомый результат, чем пара изолированных цифр в скрипте. Тем не менее он не доказывает, что абсолютно любой внезапный всплеск loss в любой современной языковой модели обусловлен исключительно softmax. В статье рассмотрены конкретные архитектуры и задачи; экстраполяция выводов на вашу собственную систему требует независимого тестирования.
Как переписать функцию потерь для сохранения миниатюрных величин
Для единичного примера с правильным классом
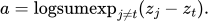
Здесь logsumexp означает «логарифм суммы экспонент», реализованный численного устойчивым методом. Следом определяем loss:
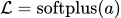
Функция softplus(a) представляет собой стабильную программную реализацию 
Ниже представлена учебная реализация для нашего частного случая: правильный класс обладает максимальным логитом. Код возвращает и потери, и явный градиент по логитам для последующей валидации. Данный фрагмент не заменяет библиотечный механизм autograd, не покрывает все возможные вариации cross-entropy и не решает задачи дистилляции.
Проверенный пример на NumPy для ситуации с уверенным верным ответом
import numpy as np

def confident_hard_ce(z, target):
    z = np.asarray(z)
    if z.ndim != 1 or z.size < 2 or z.dtype not in (np.float32, np.float64):
        raise ValueError("Требуется 1D-массив float32/float64, K >= 2")
    if not np.isfinite(z).all():
        raise ValueError("Все логиты должны быть конечными числами")
    if not isinstance(target, (int, np.integer)) or not 0 <= target < z.size:
        raise ValueError("target должен быть целым в диапазоне от 0 до K - 1")
    target = int(target)
    if z[target] != z.max():
        raise ValueError("В рамках этого примера целевой класс должен быть лидером")

    other = np.arange(z.size) != target
    d = z[other] - z[target]
    if not np.isfinite(d).all():
        raise ValueError("Разности вышли за пределы допустимого диапазона формата")

    log_r = np.logaddexp.reduce(d)       # log(sum(exp(d)))
    zero = np.zeros((), dtype=z.dtype)
    loss = np.logaddexp(zero, log_r)    # softplus(log_r)

    grad = np.zeros_like(z)
    grad[other] = np.exp(d - loss)
    grad[target] = -grad[other].sum()  # избегаем вычисления q_t - 1
    return loss, grad

z = np.array([20.0, 0.0], dtype=np.float32)
loss, grad = confident_hard_ce(z, target=0)
print(loss)        # 2.0611537e-09
print(grad)        # [-2.0611537e-09  2.0611537e-09]
print(grad.sum())  # 0.0
Вызов np.logaddexp(a, b) производит устойчивое вычисление логарифма от суммы двух экспонент. Метод reduce последовательно агрегирует весь массив конкурентов. Градиенты конкурирующих классов вычисляются на основе малых экспонент, а градиент целевого класса формируется как их инвертированная сумма.
Ограничение на максимальное значение целевого логита введено намеренно. Данный фрагмент иллюстрирует конкретный частный режим работы; для обработки произвольных ответов, батчей, весовых коэффициентов классов и автоматического дифференцирования необходим полноценный фреймворк.
На странице проекта авторы опубликовали репозиторий с кодом на JAX и интерактивным демо. Для внедрения подобных патчей в продакшен я бы начинал с глубокого профилирования вычислительного конвейера и оценки его поведения в целевой экосистеме, а не с простого копирования одной дроби в рабочий кодовая база.
Неужели этого никто не замечал раньше?
Замечали. Более того, публикация DeepMind ссылается на ряд предшествующих работ.
Так, Прието с соавторами на конференции ICLR 2025 исследовали феномен Softmax Collapse и презентовали альтернативную функцию StableMax, модифицирующую само преобразование. В рассматриваемой же статье авторы сохраняют канонические функции Softmax и Cross-Entropy в неизменном виде, оптимизируя исключительно порядок выполнения арифметических операций.
Кроме того, Лю с коллегами в мае 2026 года изучали нарушение свойства нулевой суммы градиентов и его корреляцию с эффектом Slingshot. Еще раньше вопросы вычислительной устойчивости softmax и log-sum-exp систематически разбирали Бланчард и Хайэм.
Новизна свежей работы заключается в точечном исправлении двух конкретных дефектов и глубоком анализе их влияния на динамику обучения. Это далеко не первое открытие факта, что компьютер округляет действительные числа с некоторой погрешностью.
Стоит ли сломя голову бежать переписывать код в продакшене?
Я бы посоветовал начать с измерений и профилирования. Пристального внимания заслуживают сценарии дистилляции знаний с практически сливающимися распределениями, задачи с высокой уверенностью предсказаний, а также затяжное обучение моделей после полного заучивания обучающей выборки. В последнем случае нередко наблюдается эффект grokking: способность к обобщению проявляется спустя огромное число эпох после достижения 100% точности на train-датасете.
Однако ни колоссальный объем словаря LLM, ни используемый формат весов сами по себе не дают ответа на вопрос о наличии проблемы в вашем пайплайне. Требуется точное понимание распределения маржинальных отрывов и реальной разрядности чувствительных операций.
Прием Label smoothing (сглаживание меток) принудительно снижает давление в сторону бесконечной уверенности, заставляя целевой класс принимать вероятность чуть ниже единицы. Это способно уменьшить вероятность попадания в критическую зону, но само по себе не исправляет изъян в формуле. Изменение температуры тоже влияет на уверенность: при фиксированных логитах высокая температура сглаживает распределение, а низкая делает его более резким. Универсальной панацеей это не является.
Практическую проверку я бы выстроил по следующему алгоритму:
-
Подать на вход уверенный правильный ответ — например,
[20, 0]в форматеfloat32. Зафиксировать потери, все компоненты градиента и их суммарное значение. -
Для сценария дистилляции подать на вход модели-ученику и замороженному учителю одинаковые логиты. Убедиться в нулевом значении градиента, а не кросс-энтропии.
-
Протестировать поведение системы на предельно близких логитах. Сопоставить результаты с расчетами повышенной точности, проконтролировав сохранение микродобавки уже на входе.
-
Задокументировать версии используемых библиотек, тип железа и фактический dtype операций. Отдельно протестировать нужные режимы смешанной точности (mixed precision) и компиляции графов.
-
При внедрении патча сравнить метрики качества, стабильность и время обучения в идентичных условиях. Более точная математическая формула далеко не всегда оказывается быстрее оптимизированного библиотечного ядра.
Заключение
Лично меня в этой истории привлекает сочетание масштабности контекста и потрясающей простоты сути. Мы обсуждаем фронтирные нейросети из миллиардов параметров, а ключ к устранению серьезного математического изъяна кроется в элементарном преобразовании школьной дроби.
Математически эквивалентные выражения могут давать совершенно разные результаты в машинной арифметике. В одном случае миниатюрная величина бесследно растворяется при сложении с единицей, в другом — успешно сохраняется в числителе. Для дистилляции помогает тот же фундаментальный принцип: вычисление микроскопической поправки напрямую до того, как процедура округления уничтожит ценную информацию.
Это отличный повод проинспектировать ряд численных инвариантов в собственных проектах. И этот вывод выглядит гораздо более взвешенным и конструктивным, чем паническое утверждение о том, будто «все нейросети до сегодняшнего дня обучались неправильно».
А доводилось ли вам сталкиваться с необъяснимыми всплесками loss или дрейфом модели-ученика при дистилляции? Особенно интересны воспроизводимые кейсы с указанием версий библиотек, железа и форматов вычислений.
Источники и воспроизводимость
-
Barron, Gnanapragasam, Tschannen. A Fix for Softmax and Cross-Entropy, arXiv v1, 22 октября 2026 года, CC BY 4.0.
-
Страница проекта: формулы, код на JAX и интерактивный симулятор. Код репозитория может обновляться независимо от текста первой версии препринта.
-
Prieto et al. Grokking at the Edge of Numerical Stability, ICLR 2025.
-
Liu et al. Исследование эффекта Slingshot и нулевой суммы градиентов, 2026.
-
Blanchard, D. J. Higham, N. J. Higham. Accurately computing the log-sum-exp and softmax functions.
Все пять примеров на NumPy протестированы в среде CPU: Python 3.12.1, NumPy 2.5.1, с явным заданием float32. Три схемы призваны наглядно разъяснить логику вычислений. Графики 1–3 созданы авторами статьи как самостоятельные иллюстрации, а на графике 4 использованы результаты оригинального исследования с надлежащим указанием авторства.
Похожие статьи
 Как Анри Беккерель совершенно случайно обнаружил радиоактивность
 Создаём энергоэффективную систему визуального мониторинга морской акватории
 Парадокс голосования обрёл геометрию: он оказался бутылкой Клейна
 Шесть версий, шесть неудач: почему программа не понимает, что пульт отключён?
 Динамика 12 индексов риска и их слепые зоны
 Как мы проверяли, насколько предсказания LLM соответствуют нормам профессиональных кодексов
 Как человечество изобретало красоту: атлас из 195 визуальных стилей, от пещеры Ласко до уирдкора
 Многогранник смыслов