Как работает открытый индекс риска глобального конфликта: 46 критериев и модель Jev
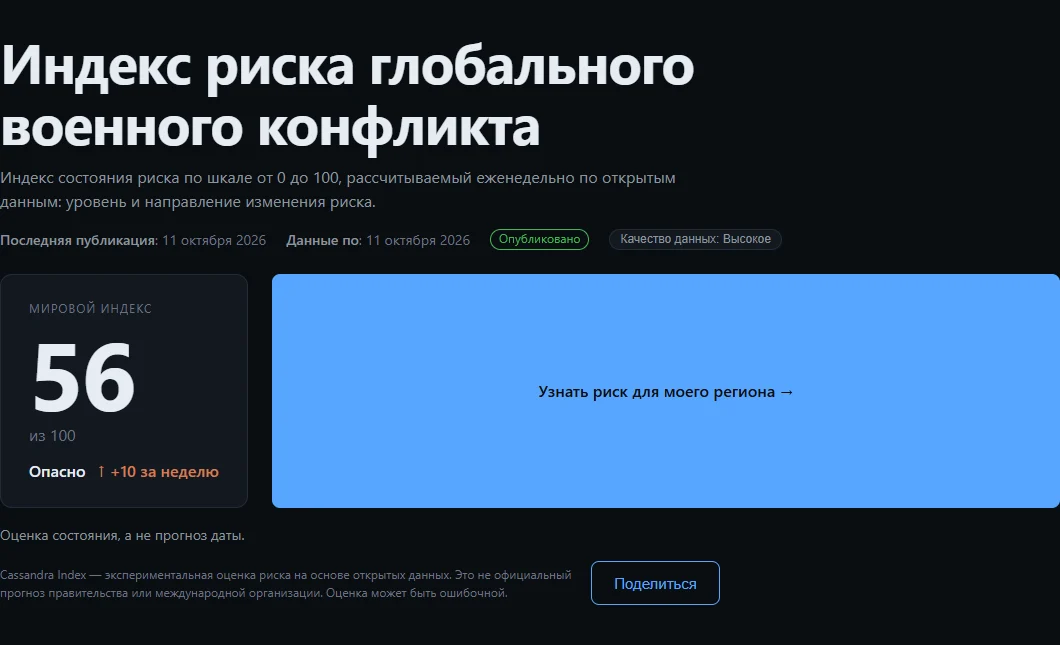
Главная: мировой индекс и региональный контекст — именно это видит человек, который открыл сайт, не разобравшись в происходящем.
Всем привет, SE7EN!
Новостной поток захлёстывает: одни источники утверждают одно, другие — прямо противоположное, и разобраться, где правда, почти невозможно. Информации слишком много, а инструмента, который показывал бы, как меняется риск с течением времени, и опирался бы на открытые данные, а не на громкость заголовков, я так и не нашёл. Пришлось сделать его самому.
Так появился Индекс Кассандры — еженедельный сервис, который оценивает уровень и динамику риска глобального конфликта. Он работает без регистрации, трекеров и подписок. Код, методика, данные и тесты опубликованы на GitHub, а сам сайт статический и размещён на GitHub Pages.
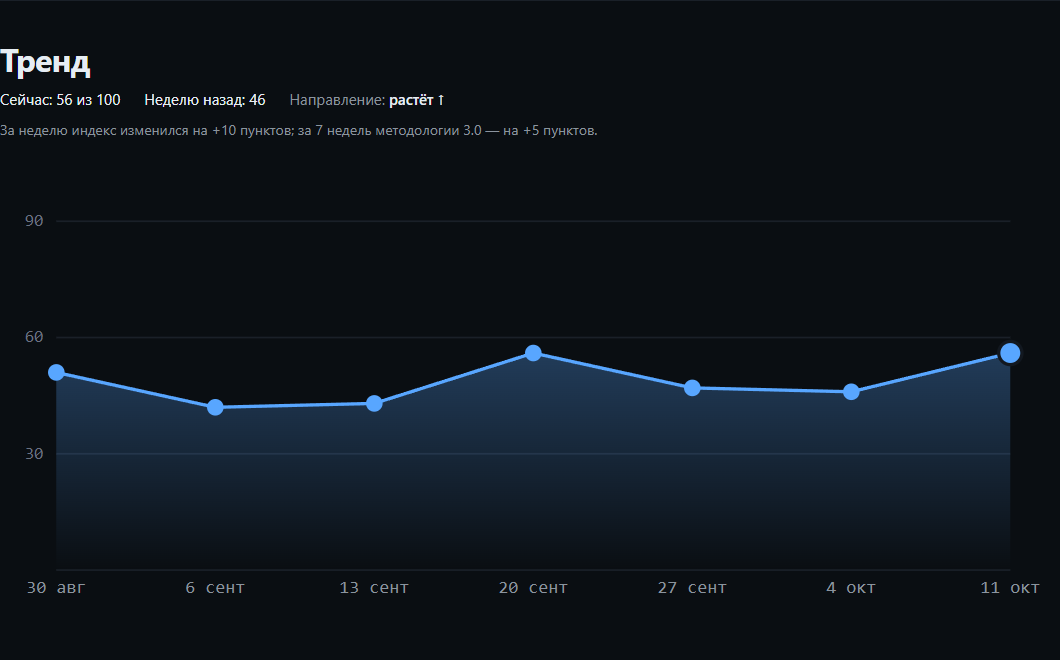
Значение за свежую неделю (11 октября 2026 года): 56, что на 10 пунктов выше предыдущего показателя (46). Ниже расскажу, как складывается это число и как в расчёт вошла новая модель-классификатор Jev.
Это рассказ об инженерной задаче: как устроен расчёт, как его результаты проверяются и какую пользу приносит машинная классификация. Здесь нет ни политических оценок, ни агитации — только измерение сигналов и сам метод.
Почему именно Кассандра
Кассандра получила дар предвидения и одновременно проклятие: ей никто не верил. Она предупреждала о гибели Трои и о коварстве троянского коня, но её слова оставались неуслышанными. Ошибалась ли она? Нет. Ей просто нечем было подтвердить свою правоту.
Этот проект о том же. Вместо призыва «поверьте мне» здесь представлены сигналы, ссылки на источники и формула, превращающая их в число. Любое предупреждение можно перепроверить — потому индекс и носит её имя. Мало знать: нужно ещё показать, на чём это знание основано.
Роль ИИ в проекте
Без искусственного интеллекта не обошлось: модель помогала писать код, а теперь ещё и классифицирует источники — об этом подробнее в разделе ниже. При этом критерии, агрегация, работа с нехваткой данных, калибровка параметра на исторических якорях и ворота целостности — решения человеческие. Все числа я сверил со снапшотами, а утверждения — с источниками; за текст отвечаю лично я.
Проверить всё просто: откройте сайт. Если картина понятна человеку без технической подготовки, значит, инструмент справляется со своей задачей.
Что выдаёт сервис
Раз в неделю публикуются четыре вещи:
-
уровень риска — число;
-
направление — рост, снижение или отсутствие изменений;
-
состояние — описание понятным языком, без метафор вроде «на грани»;
-
источники — ссылки на материалы, из которых взяты сигналы.
К ним добавляются недельный тренд, региональные срезы и список критериев с пояснениями. Отдельный блок посвящён качеству данных: какую долю сигналов удалось охватить за неделю, насколько можно доверять результату и на сколько пунктов индекс меняется при замене источников. Для 11 октября покрыто 7 из 9 драйверов, а чувствительность нулевая.
Устройство индекса: 9 драйверов и 46 критериев
Риск складывается из 9 драйверов, которые вместе опираются на 46 критериев. Каждый критерий — это сигнал определённого типа: военный, экономический, дипломатический или внутриполитический.
Что фиксируется по каждому критерию за неделю? Его значение, наличие подтверждающих источников и сами ссылки.
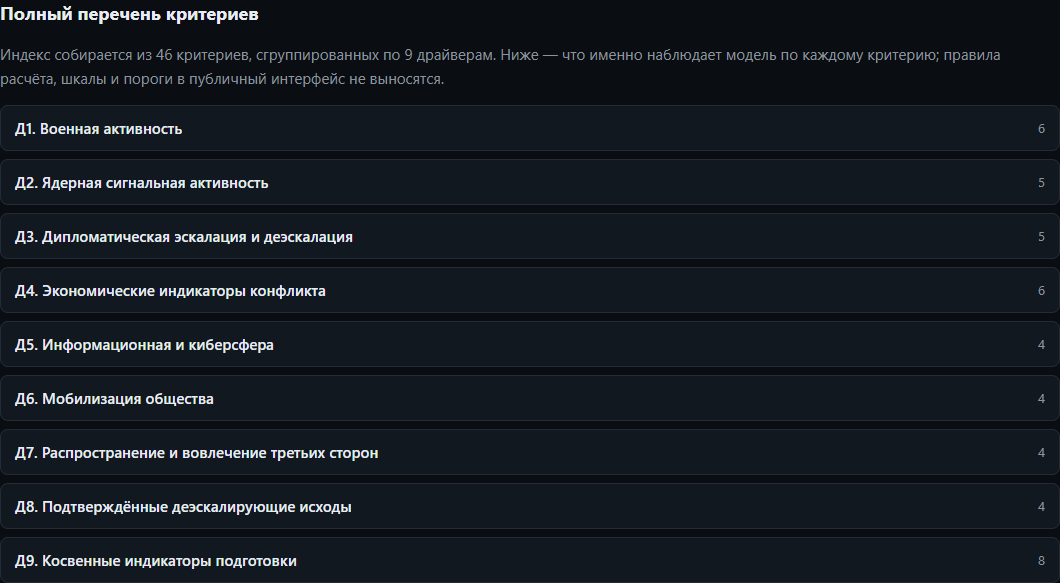
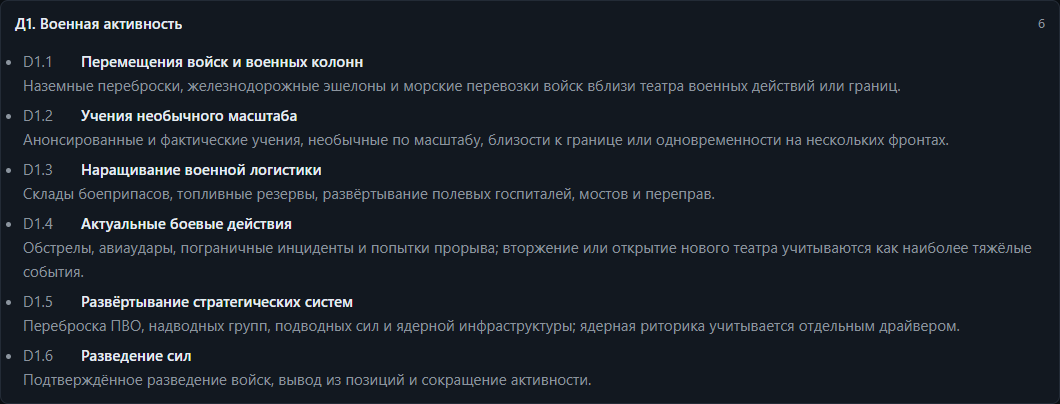
Оценка каждого драйвера считается отдельно, после чего результаты агрегируются по открытой методике. Никакого машинного обучения и «умных прогнозов»: это детерминированный движок на чистых функциях.
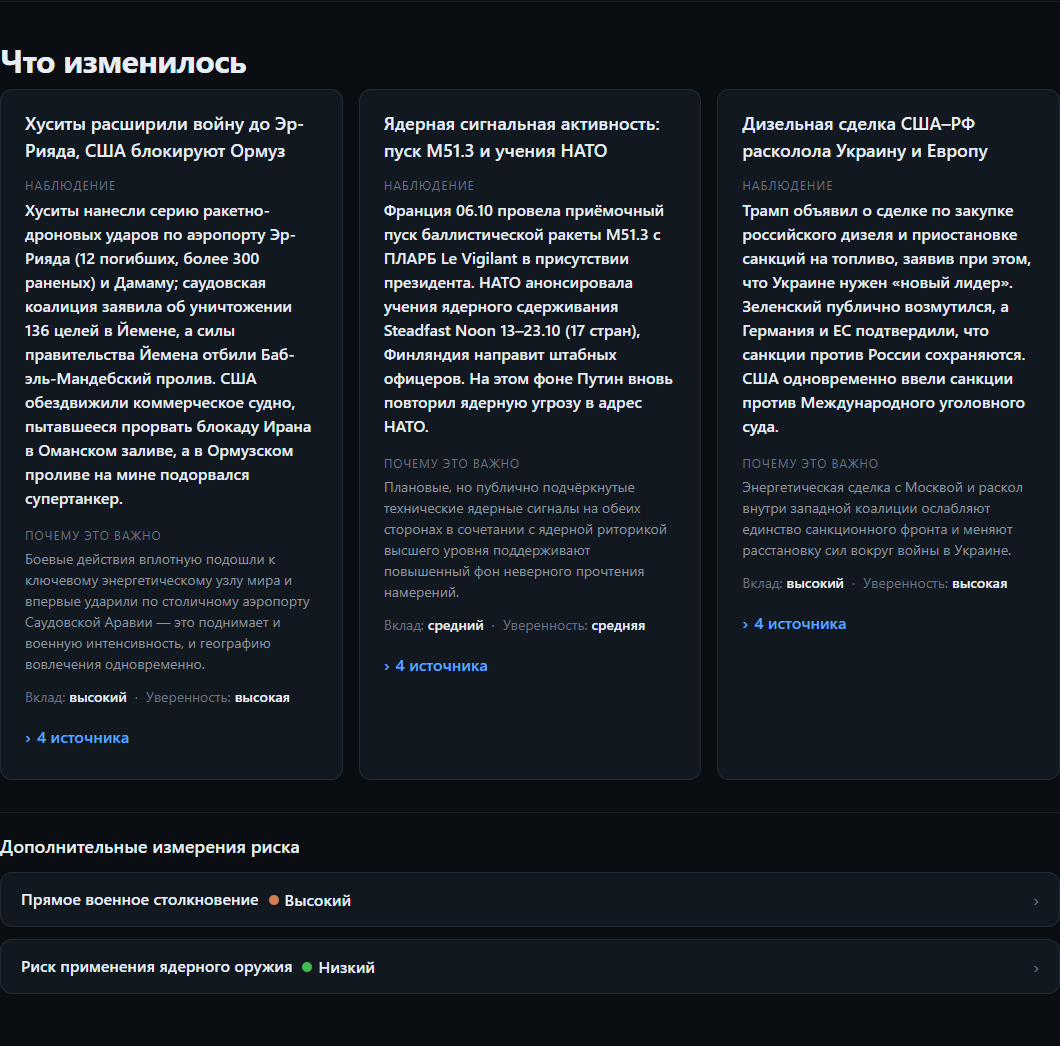
Что изменилось в методологии по сравнению с первой версией статьи:
-
методология 3.0 и пересчитываемая цепочка. Демонстрационные недели перенесены в архив, который не пересчитывается. Зато вся остальная цепочка пересчитывается целиком — сейчас это семь недель подряд (начиная с 30 августа), так что историю можно воспроизвести с самого начала;
-
параметр
k = 1.95. Он больше не подбирается «на глаз»: проведена калибровка на 10 якорных профилях (7 отборочных и 3 проверочных) и проверка устойчивости к изменению на ±20%. Весь путь зафиксирован в журнале; -
классификация публикации по покрытию. Если данных мало, неделя не превращается тихо в «средний» индекс, а получает состояние
insufficientилиreducedс указанием причины. Пороги заданы вcalc/params.js, логика — вcalc/calc.js; -
throughсовпадает с датой самой недели. Окно сигналов охватывает период W−7…W включительно; -
региональная атрибуция и слепые регионы. Критерий может быть привязан к регионам. Регион, по которому есть сигналы, считается по ним; регион без сигналов сохраняет последнее отклонение от глобального фона, а сайт помечает его как фон («индекс отражает глобальный фон») и не выдаёт глобальную дельту за региональную. Механизм уже работает на реальных данных: недели 3.0 смешанные — часть регионов считается по собственным сигналам, часть помечена как фон;
-
тренд строится только по версии 3.0. Точки более ранней серии на график не попадают.
Кроме того, в октябре появились два новых механизма:
-
ворота независимости источников (с 11 октября). Каждый покрытый критерий недели должен опираться как минимум на два разных кластера источников или хотя бы на один первичный/OSINT-источник. Это правило значилось в методологии, но в коде прежде не применялось — теперь оно стоит воротами перед расчётом. Его ввели «вперёд», без пересчёта уже опубликованных недель;
-
метрика чувствительности недели. Автоматически проверяется, насколько сместится индекс, если по очереди убрать самый влиятельный домен и целый кластер источников. Для недели 4 октября сдвиг составил 5,4 пункта (из-за одного домена-монополиста), для 11 октября — ноль. Если сдвиг превышает 5 пунктов, сайт отмечает такую неделю.
Так я отвечаю на частый упрёк в адрес подобных индексов: «источники выбираете вы, значит, можно нарисовать что угодно». Теперь у критерия не может быть единственного рупора, а субъективность выбора выражается числом. Есть и ориентир по ядру (девять доменов из кластеров A/B/C/F), и red team-чек-лист из семи вопросов перед каждой публикацией — он носит рекомендательный характер, но след в журнале аудита остаётся.
И ещё одно. Критерий может остаться непокрытым: если за неделю нет надёжных данных, он помечается «слепым» и считается отдельно от покрытых. Это честнее, чем молча подставлять ноль.
Отдельно о рыночном критерии. Он наконец введён: в методологии 3.0 появился 46-й критерий — стресс рынков (сырьевые биржи и рынки облигаций реагируют раньше остальных сигналов). Он нарушает сопоставимость ряда, поэтому его приняли не задним числом, а в составе новой версии методики — с перекалибровкой k на десяти якорях (включая новый критерий) и версионным разрывом на тренде. Вся цепочка недель перевыпущена под 3.0, а сайт работает на 46 критериях.
Jev: модель-классификатор, которая читает источники за вас
Самое узкое место такого индекса — сбор входных данных. 46 критериев, десятки статей, и всё вручную. Идея «пусть LLM всё разметит» обычно заканчивается галлюцинациями, поэтому классификатор я подключал с единственной целью: ускорить работу человека, а не подменить его решение.
Что такое Jev. Это модель-классификатор из TypeSafe (System One). Длинных текстов она не пишет, а выдаёт атомарные типизированные суждения: классификацию, оценку по шкале, вероятность, вердикт с уровнем доверия.
Подключается она по MCP: jev_classify, jev_score, jev_check, jev_gate, jev_decide.
В чём удобство? Такой ответ легко проверить программно. На входе — состояние и вопросы со схемой, на выходе — типизированный результат, который можно сравнить с порогом.
Принцип разделения труда
Правилами владеет код, а Jev даёт суждения:
-
Классификация (Jev). Текст раскладывается по критериям D1…D9. Релевантен ли он критерию? Какое значение поставить —
value, а для счётных критериев — массивevents[]с весами? Это событие окна W−7…W или затянувшийся фон? Не продублировано ли одно событие в нескольких критериях? Каждое значение больше нуля обязано сопровождаться дословной цитатой и ссылкой. Нет цитаты —not_found. Правило жёсткое. Полеcoveredклассификатор не выставляет вовсе: вопрос о «слепоте» критерия решает только редактор. -
Верификация (человек). Редактор видит черновик: значение, цитату, ссылку. Он подтверждает, исправляет или отбрасывает спорное. Решение о переносе критерия с прошлой недели всегда остаётся за человеком.
-
Детерминированный расчёт (код). Дальше работает только
calc/engine.js. В формулах нет никакого ИИ. Jev не сдвигает индекс ни на пункт: он ускоряет подготовку входных данных, а считает чистая математика.
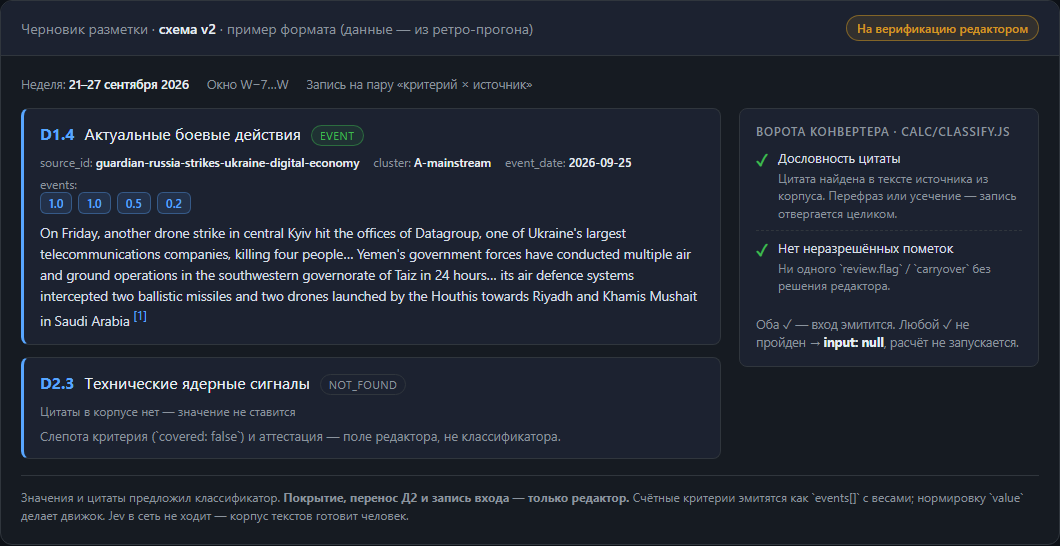
Механический шов вместо «верьте на слово». Jev — внешний MCP, а в репозитории по-прежнему ноль зависимостей, поэтому модель из кода не вызывается. Между черновиком и расчётом стоит чистый конвертер calc/classify.js — без сети и без обращения к Jev — с двумя жёсткими воротами:
-
дословность цитаты проверяется машинно. Конвертер ищет цитату в тексте источника из корпуса; он нормализует пробелы, дефисы и кавычки, но перефразирования и усечения не прощает: не нашёл — запись отвергается целиком, а не отправляется «на ревью»;
-
неразрешённая пометка блокирует эмиссию. Пока в черновике остаётся хотя бы один флаг «на ревью» или незакрытый кандидат на перенос Д2, вход в расчёт вообще не формируется: спорное — долг редактора, а не значение.
Черновик перешёл на схему v2: запись на пару «критерий × источник», тип event / background / not_found, а для счётных критериев — массив events[] с весами вместо свёрнутого значения (нормирует уже движок). Сам Jev в сеть не ходит: корпус текстов ему готовит человек. Поэтому прогон воспроизводим, а количество статей, которые реально получила машина, видно напрямую: нет текста — нет и значения.
Почему я этому доверяю
Перед подключением Jev я провёл слепые ретро-прогоны по уже опубликованным неделям (27 и 20 сентября 2026 года). Классификатор не видел ни человеческого входа, ни результатов. Итоги получились не самыми приятными.
-
Ноль выдуманных фактов на двух прогонах подряд: каждое значение больше нуля подкреплено проверяемой цитатой, ни одного «лишнего» покрытия не найдено;
-
система цитат работает, но излишне консервативна, когда статьи недоступны. Из 74 URL классификатор добрался примерно до трети. Узкое место пилота — не классификация, а доставка текстов: Reuters отвечает ботам кодом 401, часть сайтов закрыта Cloudflare;
-
итоговый индекс разошёлся с ручной разметкой на 6 и 17 пунктов. В обоих случаях причина — в покрытии. Там, где текст был доступен, оценки не расходились.
Статус на момент публикации: Jev подключён как классификатор. Схема гибридная: недоступные новости добавляет человек. Далее Jev классифицирует, а человек верифицирует.
Схема черновика v2 и конвертер с двумя машинными воротами уже готовы. Форвард-прогон описан заранее и пока не проведён: метрика ±2 (сырой черновик прогоняется без записи и сверяется с верифицированным входом той же недели) и посегментный хронометраж против контрольной ручной недели, выполненной той же рукой. Цифры экономии времени и степени совпадения появятся только после него — не раньше.
Критерии успеха зафиксированы заранее, в журнале пилота: индекс в пределах ±2 при том же статусе и экономия времени редактора не менее 50%. Отчитаюсь по факту, а не по обещаниям.
Вся логика изложена в документах проекта; статья лишь пересказывает их, а не наоборот. docs/jev‑classification.md (версия 0.2: роли, схема v2, правила, ворота § 6.1, статус пилота) и docs/adr/0018-jev‑source‑classification.md (почему выбрано именно такое разделение труда; дополнение от 11 октября — про конвертер). docs/governance.md § 10.1 — правила машинной разметки, обязательные для всех прогонов.
Чего Jev не делает. Он не предсказывает будущее, не «разбирается в геополитике» и не пишет тексты для сайта. Он классифицирует — и за каждое суждение предоставляет цитату и уровень доверия, которые я вправе отклонить.
Стек: ноль зависимостей и пока никакой базы данных
Архитектура выглядит так:
-
чистые HTML/CSS/JS без фреймворков;
-
расчётный пайплайн на Node.js, только со стандартной библиотекой;
-
фронтенд собирается собственным мини-бандлером в пару файлов;
-
данные хранятся статическими снапшотами, которые браузер читает даже с
file://; -
Jev подключается извне по MCP — в репозитории по-прежнему ноль npm-зависимостей;
-
конвертер черновика (
calc/classify.js) — тоже чистый модуль: ни сети, ни вызовов модели, только проверка формата, дословности цитат и очереди ревью.
Отдельно о базе данных: её нет, и пока она не нужна.
Зачем хранилище еженедельному индексу, который пересчитывается целиком? Снапшоты на диске уже дают и историю, и версионирование, и воспроизводимость.
Тем не менее на рост я рассчитывал. Когда появятся новые индексы — по регионам, отдельным типам риска, экономическим сценариям, — тогда база для длинной истории, агрегаций и API действительно понадобится. Сейчас же серверной логики нет вовсе, как и зависимостей — так и было задумано.
Как обеспечивается целостность
Прежде чем попасть в публикацию, неделя проходит несколько ступеней проверки.
-
Ворота независимости источников. Каждый покрытый критерий опирается минимум на два разных кластера или на первичный/OSINT-источник. Не прошёл проверку — неделя не считается.
-
Проверка источников. Каждая ссылка реально открывается и классифицируется:
ok/blocked(401/403/406 — предупреждение, не отказ) /broken(404 и далее — запись отклоняется). Битая ссылка до сайта не доберётся. -
Контракт данных. Готовый снапшот проверяется по схеме: ровно 12 точек тренда, ровно 3 драйвера в разборе, корректные состояния, флаг регионального фона и так далее. При провале любых ворот диск остаётся нетронутым.
-
Метрика чувствительности. Автоматический пересчёт без каждого домена и каждого кластера. Сдвиг более 5 пунктов — публичная пометка недели.
К этому добавляются 38 тест-файлов на чистое ядро (359 проверок проходят без сети, на синтетических данных) и red team-чек-лист из семи вопросов перед каждой публикацией. Конвертер черновика тоже покрыт тестами, включая сквозной позитивный сценарий: собранный из черновика вход проходит валидацию движка и отображается на 9 драйверов.
Все калибровки, пересчёты и ответы red team записываются в журнал аудита (data/audit.jsonl, hash-цепочка). У каждого числа есть дата, причина и версия методологии.
Черновик Jev проходит те же ворота, что и ручной ввод: независимость источников, контракт данных и проверку ссылок. Никаких поблажек.
Любую неделю можно пересчитать из входных данных и сверить с опубликованным снапшотом.
Чего сервис намеренно НЕ делает
-
не предсказывает даты каких-либо событий;
-
не является вероятностью войны — это индекс уровня риска по открытым сигналам;
-
не заменяет профильную экспертизу;
-
не занимает политическую сторону и не агитирует: это измерение сигналов по открытым данным, а не оценка действий государств;
-
не отдаёт расчёт на откуп классификатору — Jev готовит черновик разметки, а решение и математика остаются проверяемыми.
Цель — показать динамику в одном месте и дать возможность вернуться к любому числу с вопросом: «Откуда это взялось?»
Главное — обычные люди
Это не проект для аналитиков.
Он для человека, который открыл новости, растерялся и хочет понять, что происходит. Для моих родителей, которым вовсе не обязательно разбираться в формулах. Для всех, кому нужна не «эк
Похожие статьи
 Основы глубинного обучения. Часть 4
 Как мы воссоздали Обнинскую АЭС в браузере и с какими проблемами столкнулись
 Джозеф Нидэм об эволюции и термодинамике
 Проверить, ускоряет ли ИИ работу разработчиков, уже невозможно: без него они работать не соглашаются
 ESP32 для новичков: от логических микросхем до умных устройств
 Создатели правил игры: семь экономистов, изменивших мир
 ИИ воскрешает мёртвых: благо это или зло?
 Мои ИИ-агенты нашли неизвестное поселение майя