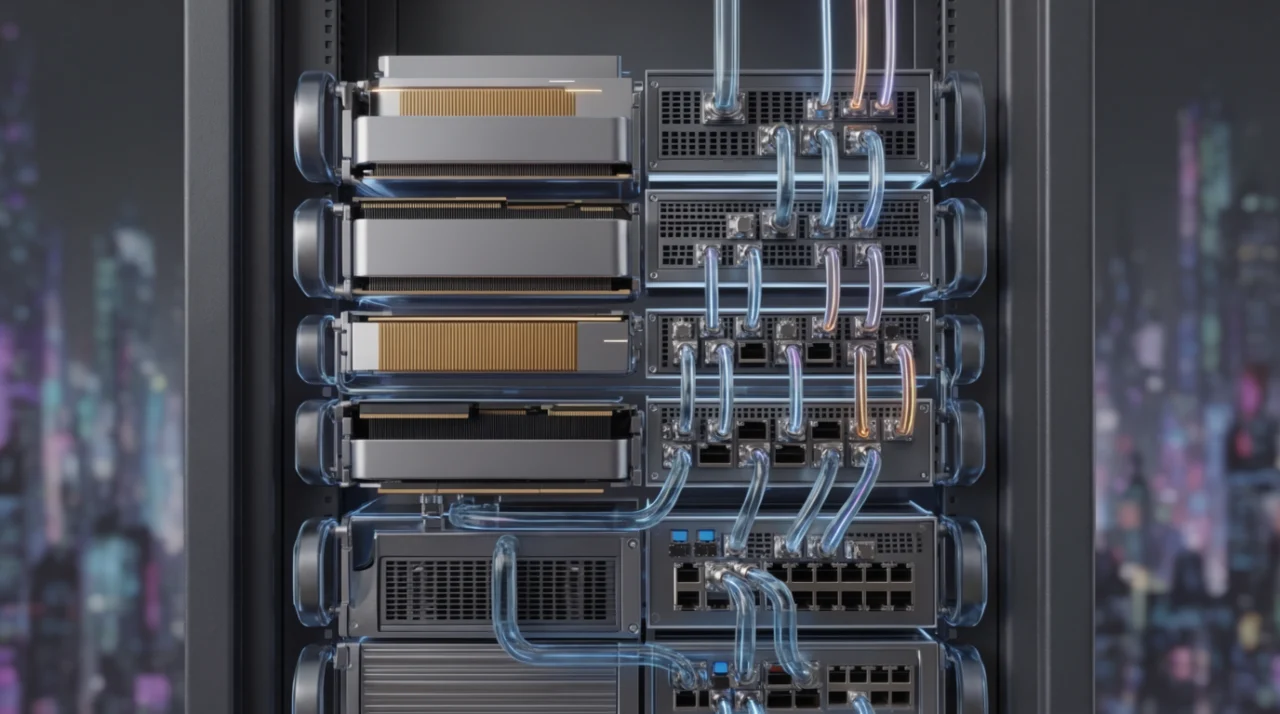
Как искусственный интеллект трансформирует ИТ-инфраструктуру?
Если кратко ответить на вопрос из заголовка, то правильным вариантом будет — «всё». Но давайте разберем это утверждение подробнее.
Привет, SE7EN!
Меня зовут Владислав Шершульский, я занимаю должность советника генерального директора Группы Rubytech по вопросам инноваций и искусственного интеллекта.
Новые приоритеты
Прежде всего, трансформируются ключевые метрики. Если раньше при оценке дата-центров оперировали пиковой производительностью в FLOPS, емкостью хранилищ в терабайтах, показателем энергоэффективности PUE и стоимостью вычислений, то для сферы ИИ этого уже недостаточно. На первый план выходят совершенно другие параметры: количество генерируемых моделью токенов в секунду (tokens/s), время отклика до первого токена (time-to-first-token), скорость выдачи последующих токенов (time-per-output-token), энергоэффективность в расчете на Ватт (tokens/W), а также себестоимость генерации единицы текста ($/token).
Теперь нас интересует не абстрактная вычислительная мощность, а реальная результативность конкретной нейросети на определенной аппаратной базе.
Новые процессоры
Существенные изменения происходят и с процессорной архитектурой. После многолетнего затишья и безоговорочного лидерства систем x64 мы наблюдаем настоящий инженерный ренессанс. Пока на рынке лидирует Nvidia, которая в свое время удачно адаптировала графические чипы сначала под майнинг, а затем и под задачи машинного обучения.
Однако параллельно развиваются альтернативные решения: китайские разработки Huawei Ascend, Cambricon MLU, Biren и прочие, а также собственные ускорители технологических гигантов из США — Google TPU, Amazon Trainium с Inferentia, Microsoft Maia и Meta MTIA. К слову, наша команда успешно работает с китайскими графическими процессорами, умеет их программировать и интегрирует в отечественные программно-аппаратные комплексы «Машина Искусственного Интеллекта Скала^р».
Встречаются и уникальные инженерные проекты, например, разработка компании Cerebras. Вместо разделения кремниевого вафера на отдельные кристаллы они создают единый суперчип огромного размера (попытки реализовать концепцию wafer-scale computing предпринимались давно, но именно Cerebras сумела довести ее до коммерческого продукта).
Подобный всплеск инноваций заставил IT-гиганты активно привлекать к работе академических математиков в надежде оптимизировать алгоритмы на уровне кремния.
Память и интерконнекты
Современным масштабным моделям требуются колоссальные объемы памяти — от сотен гигабайт до терабайтов под веса и кэш, причем эти данные должны передаваться на вычислительные модули мгновенно. Именно поэтому сформировалась сложная иерархия памяти и каналов связи.
Внутри микросборок чиплеты объединяются интерфейсом UCIe, а рядом с GPU располагается сверхбыстрая память HBM. Новые спецификации PCIe 6.0/7.0 гарантируют высокоскоростной обмен между ускорителями, сетевыми адаптерами и дисками, тогда как стандарт CXL дает возможность динамически объединять дополнительную память в общие пулы. Когерентные интерфейсы вроде NVLink-C2C и AMD Infinity Fabric стирают границы между CPU и GPU в работе с оперативной памятью (подобные подходы использовались в суперкомпьютерах сорок лет назад, но на скоростях, отличающихся на порядки). Для связи десятков ускорителей применяются NVLink/NVSwitch и UALink, а серверы и стойки объединяются сетями InfiniBand и Ultra Ethernet. Благодаря технологии RDMA обращения к удаленной памяти происходят напрямую, минуя лишнее копирование через центральный процессор.
Грань между сетевыми технологиями и памятью постепенно стирается: общая производительность всей инфраструктуры все сильнее зависит от скорости перемещения данных между узлами.
Определения используемых терминов
-
Чиплет — функциональный модуль сложного процессора, реализованный на отдельном полупроводниковом кристалле. Чиплеты бывают как стандартными, так и заказными, интегрируемыми в единую микросборку для решения узкоспециализированных задач.
-
Микросборка — компактный модуль, объединяющий несколько чиплетов или компонентов на общей подложке ради достижения конкретной технологической цели.
-
UCIe — открытая спецификация для сверхскоростного обмена данными между чиплетами внутри общего корпуса.
-
HBM-память — многоуровневая оперативная память высокой пропускной способности (High Bandwidth Memory), размещаемая в непосредственной близости от вычислительного ядра GPU.
-
PCIe — стандартная высокоскоростная шина для интеграции периферийных плат с процессором. В настоящее время индустрия переходит от пятой версии к стандартам PCIe 6.0/7.0 с улучшенным кодированием и возросшей пропускной способностью.
-
CXL — открытый стандарт кэш-когерентного интерфейса для интеграции памяти, ускорителей и формирования единых пулов ресурсов.
-
Когерентный интерконнект — технология синхронизации кэш-памяти между различными процессорами, графическими чипами и специализированными модулями.
-
NVLink-C2C — фирменный проприетарный интерфейс Nvidia для взаимодействия процессоров, графических чипов и чиплетов.
-
AMD Infinity Fabric — масштабируемая шина компании AMD для связи вычислительных ядер, графики, чиплетов и памяти.
-
InfiniBand — высокоскоростная коммутируемая сеть с минимальными задержками, традиционно востребованная в дата-центрах и суперкомпьютерах. После поглощения компании Mellanox правами на стандарт владеет Nvidia.
-
Ultra Ethernet — перспективный сетевой стандарт на базе Ethernet, создаваемый консорциумом UEC для нужд высокопроизводительных вычислений и инфраструктуры ИИ.
Традиционный электрический Ethernet на скоростях от 800 Гбит/с и выше сталкивается с ограничениями по дальности и колоссальными потерями энергии. По этой причине технологии совместной упаковки оптики (CPO) и кремниевой фотоники переносят оптические интерфейсы прямо к коммутационным микросхемам (switch ASIC).
Стойка как единый суперкомпьютер
Меняется и базовое восприятие вычислительной системы. Раньше отправной точкой был отдельный сервер. Сегодня десятки процессоров и ускорителей в пределах одной стойки связаны настолько быстродействующими интерфейсами, что функционируют как единая неделимая машина. Следующим масштабом выступает группа стоек, а в перспективе — весь дата-центр целиком. Именно поэтому аппаратные компоненты — процессоры, память, сети, системы питания и охлаждения — больше не могут проектироваться изолированно друг от друга. Современные ЦОДы строятся не из разрозненных массовых комплектующих, а в виде монолитных программно-аппаратных комплексов, сбалансированных под конкретные рабочие нагрузки.
Инференс и автономные агенты
Характер вычислительных нагрузок переживает глубокую перестройку. Еще год назад основные ресурсы мощных кластеров уходили на обучение моделей, а их последующее внедрение в бизнес-процессы казалось относительно недорогим этапом. С появлением рассуждающих моделей (reasoning-моделей) и автономных AI-агентов ситуация кардинально изменилась. Каждый пользовательский запрос теперь может инициировать цепочку промежуточных вычислений, обращений к внешним базам данных и сторонним сервисам. В результате именно масштабный инференс — рутинная эксплуатация обученных нейросетей — превращается в главного потребителя вычислительных мощностей. Можно утверждать, что в ближайшем будущем именно ИИ-агенты станут главными клиентами инфраструктуры дата-центров.
Энергопотребление и охлаждение
Масштаб происходящих перемен ярче всего иллюстрируют системы энергоснабжения и теплоотвода. Потребление одной современной ИИ-стойки уже перешагнуло отметку в 100 кВт, а в планах разработчиков маячат показатели в целый мегаватт на стойку. Рассеять такое количество тепла с помощью традиционного воздуха невозможно, поэтому жидкостное охлаждение (direct-to-chip) становится обязательным элементом архитектуры. Параллельно приходится перестраивать системы электроснабжения: огромные токи и многократные преобразования напряжения порождают критические потери. Симптоматично, что в 2026 году ведущие игроки рынка, включая Google, Microsoft и NVIDIA, через инициативу Open Compute Project начали стандартизацию новой архитектуры питания на 800 В постоянного тока (800 VDC) для будущих поколений ИИ-дата-центров.
География и энергетика
Традиционная география размещения ЦОДов также претерпевает изменения. Если раньше локация выбиралась с учетом стоимости недвижимости, каналов связи и близости абонентов, то сейчас главным лимитирующим фактором выступает доступная электрическая мощность. Новые дата-центры возводят вблизи мощных электростанций, дополняют накопителями энергии или даже автономными микросетями.
Идея вынесения ИИ-дата-центров в космическое пространство выглядит крайне амбициозно, но пока остается технологически сложной и дорогой. Для обслуживания всего одной стойки мощностью в один мегаватт на оптимальной солнечно-синхронной орбите потребуется развернуть 5,6 тыс. кв. метров солнечных панелей и 2,5 тыс. кв. метров радиаторов охлаждения. Для сравнения: на МКС функционируют шесть радиаторов массой по тонне каждый, способных рассеять лишь около 70 кВт тепловой энергии.
Лично мне, в силу определенных интересов, ближе подводные ЦОДы. Особенно впечатляет тот факт, что надежность герметичного и правильно спроектированного ПАКа под водой существенно выше, чем в стандартном здании дата-центра (видимо, сказывается отсутствие внешних негативных факторов). Тем не менее, вопросы энергообеспечения и обслуживания таких комплексов по-прежнему остаются крайне сложными.
Наиболее реалистично сегодня выглядят проекты ИИ-дата-центров поблизости от крупных гидроэлектростанций (что дает бонус в виде природного охлаждения), а также площадки, оснащенные компактными ядерными реакторами нового типа или собственными мини-ТЭС на базе газотурбинных установок.
Данные
Наконец, требования к работе с данными выросли многократно. Еще недавно казалось, что концепции Big Data досконально изучены. Оказалось, что наши прежние объемы были слишком малы. Для промышленных ИИ-систем требуются беспрецедентные массивы информации: обучающие тексты, мультимедийный контент, векторные базы документов, логи диалогов с агентами, телеметрия и разнообразный кэш. Судя по всему, у бизнеса больше не осталось «непригодных данных» — современные алгоритмы способны извлекать пользу из любых массивов. По этой причине хранилища класса data lake и lakehouse, потоковые брокеры вроде Kafka, объектные хранилища и быстрые NVMe-кэши сливаются в единую многоуровневую экосистему данных, без которой даже самые передовые графические ускорители окажутся бесполезными.
Управление
Все эти технологические усложнения предъявляют принципиально новые требования к программному управлению инфраструктурой. Базового поиска свободного сервера под запуск приложения уже недостаточно. Требуется учитывать множество факторов: локацию нужной модели, объем свободной видеопамяти, распределение долей GPU под конкретные задачи инференса с учетом таймингов, пропускную способность интерконнекта, расположение кэша и допустимые задержки, а также структуру и скорость извлечения обрабатываемых данных. Именно поэтому классические системы управления дата-центрами дополняются специализированными оркестраторами распределенных ИИ-нагрузок.
В сухом остатке, технологии искусственного интеллекта превращают дата-центр из помещения с парком автономных серверов в единый гигантский распределенный суперкомпьютер. Его аппаратная часть, подсистемы хранения, сети, охлаждение и программный стек должны проектироваться как единое целое. Вот почему оптимальной формой поставки такой инфраструктуры становятся интегрированные программно-аппаратные комплексы (от зарубежных вендоров вроде Nvidia или Dell, а в России — от отечественных производителей вроде Группы Rubytech с линейкой «Скала^р»): попытка вручную собрать сбалансированную ИИ-систему из разрозненных компонентов становится практически невыполнимой задачей.
Похожие статьи
 Как связаны между собой выборы и бутылка Клейна
 Шахматная классика для тех, кто взял 1500 на Lichess: книги, обязательные к прочтению
 Куда исчезают 69 гигабайт с каждого терабайта и почему это стало причиной судов с производителями
 Как школьная алгебра за 7 класс спасает softmax от затухания градиентов
 Как Анри Беккерель совершенно случайно обнаружил радиоактивность
 Создаём энергоэффективную систему визуального мониторинга морской акватории
 Парадокс голосования обрёл геометрию: он оказался бутылкой Клейна
 Шесть версий, шесть неудач: почему программа не понимает, что пульт отключён?