Как добиться десятикратного ускорения A* в условиях пробок
Как добавить учёт пробок в эвристику A*
В три часа ночи A* прокладывает маршрут по Москве в 11 раз эффективнее алгоритма Дейкстры: ему приходится рассматривать в 11 раз меньше перекрёстков. В половине девятого утра на тех же запросах преимущество сокращается до 2,5 раза. Алгоритм не изменился — изменился трафик.
Мне давно хотелось понять, как навигаторы за доли секунды находят путь через огромный город, учитывая дорожную обстановку. Я собрал простую версию на реальной карте Москвы и столкнулся именно с этой проблемой. Тогда я решил проверить, можно ли вернуть A* ночную производительность в час пик. Для этого попробовал две поправки: таблицу из 96 чисел и миниатюрную нейросеть со 169 параметрами. Обе увеличивают преимущество в час пик до 10–12 раз, а полученный маршрут в среднем лишь на 1–2% дольше оптимального. Ниже расскажу об устройстве подхода и результатах на 1800 запросах.
Как работает поиск маршрута
Для навигатора дорожную карту представляют в виде графа. Перекрёстки становятся вершинами, соединяющие их дороги — рёбрами, а каждому ребру назначается время проезда.
Алгоритм Дейкстры исследует граф, постепенно удаляясь от точки старта: сначала рассматривает всё, куда можно доехать за минуту, затем за две, за три и так далее. О направлении к цели он ничего не знает. Прокладывая путь из Тушина в Марьино, он заглянет и в Ховрино, хотя оно находится в противоположной стороне: просто туда можно добраться быстрее.
A* (Hart, Nilsson, Raphael, 1968) прибавляет к уже затраченному времени оценку оставшегося пути. Перекрёстки, ведущие в сторону от цели, получают большую суммарную оценку, поэтому алгоритм рассматривает их позже либо не рассматривает вовсе. Пока эвристика допустима, то есть никогда не завышает оставшееся время, A* гарантированно находит самый быстрый маршрут. Чем точнее оценка, тем меньше лишних вершин приходится проверять.
Для дорожных графов хорошую допустимую оценку даёт метод ALT (Goldberg, Harrelson, 2005). На периферии графа выбирают 16 опорных точек и заранее вычисляют время от каждого перекрёстка до каждой из них. Затем применяют неравенство треугольника: если от опорной точки до цели ехать 30 минут, а до текущего перекрёстка — 10, то оставшийся путь не может занимать меньше 20 минут.
Почему пробки мешают поиску
В навигаторе время проезда участка зависит от момента въезда на него (Kaufman, Smith, 1993). Поэтому запрос включает не только начальную и конечную точки, но и время отправления. Алгоритм Дейкстры с этим справляется: если выехавший позже не может приехать раньше, достаточно рассматривать перекрёстки в порядке времени прибытия. Такую модификацию называют TD-Dijkstra.
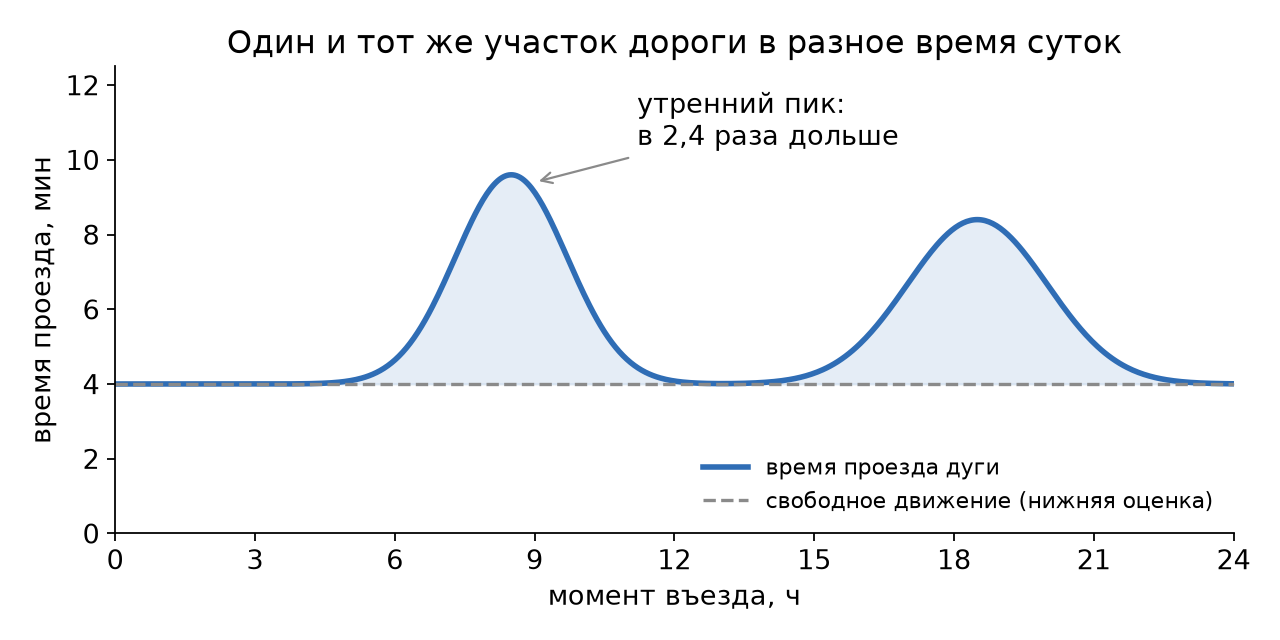
Изменение времени проезда одного участка в течение суток. Пунктиром обозначена оценка, используемая A*.
С эвристикой A* всё сложнее. Чтобы она не завышала время, её рассчитывают для свободных ночных дорог (Delling, Wagner, 2007). Ночью такая оценка близка к реальности. В восемь утра проезд показанного на графике участка занимает в 2,4 раза больше времени, но оценка остаётся прежней. Для A* почти все перекрёстки становятся одинаково привлекательными, и область поиска расползается по городу почти так же, как у алгоритма Дейкстры.
Условия эксперимента
Я использовал данные OpenStreetMap для Москвы внутри МКАД: 19 473 перекрёстка и 40 229 участков, доступных автомобилям. Ночная скорость определяется типом дороги: от 90 км/ч на магистралях до 25 км/ч во дворах. Загруженность каждого участка зависит от типа дороги, расстояния до центра и направления движения: утром основной поток едет в центр, вечером — обратно.
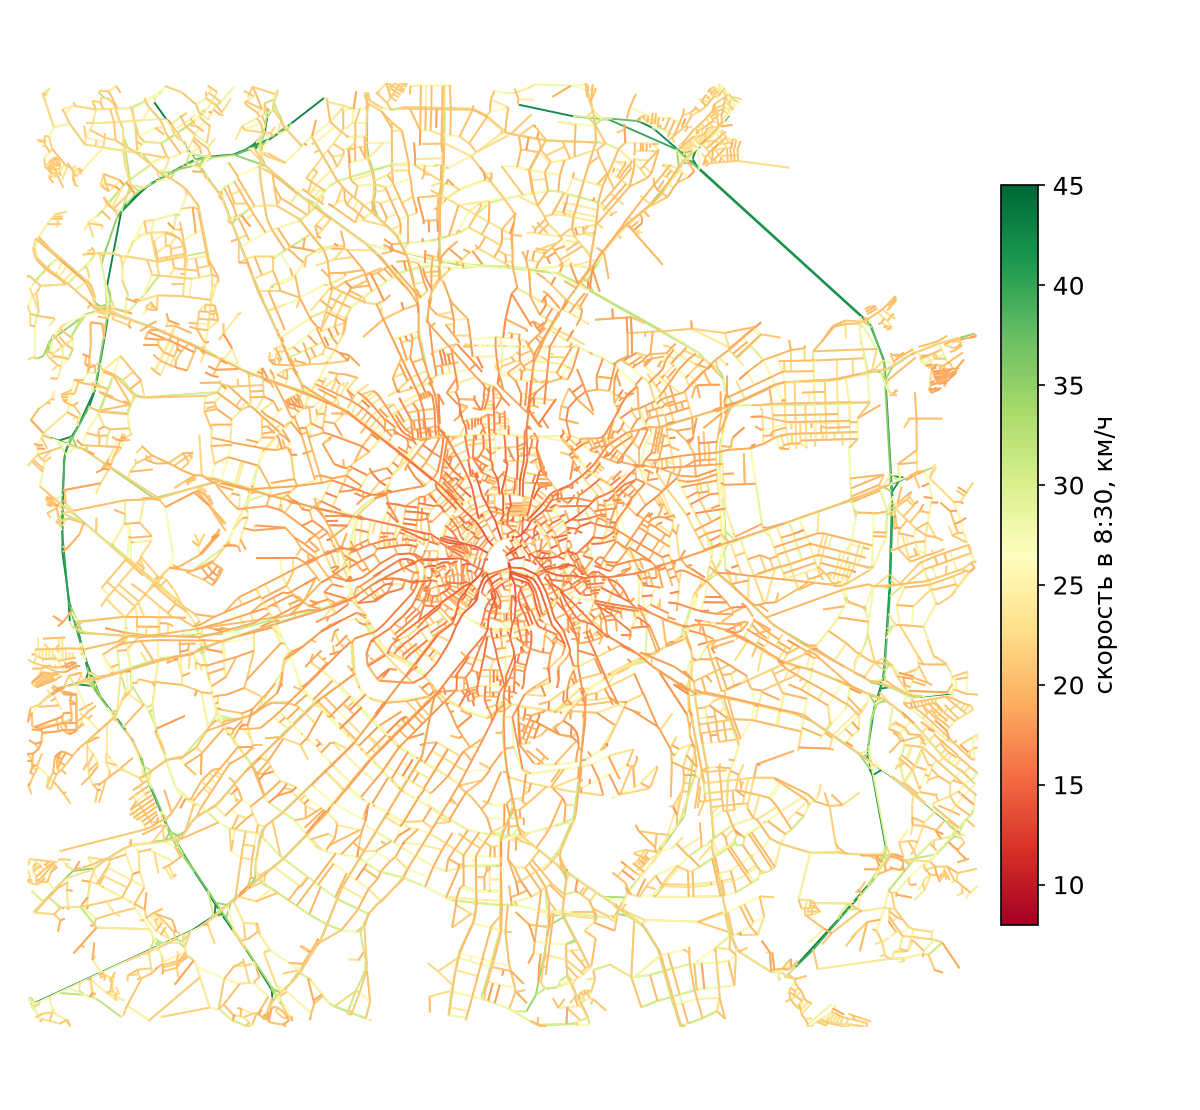
Город в 8:30 согласно моей модели. Самое медленное движение — в центре и на радиальных улицах, самое быстрое — на МКАД.
Профили скоростей я подбирал по открытым данным. В моей модели скорость на магистралях у МКАД в утренний пик составляет 38 км/ч, по данным Яндекса на МКАД утром — 37 км/ч. На главных улицах возле Садового кольца модель показывает 24 км/ч, а Яндекс для самого кольца — 27 км/ч. Средняя скорость по городу в вечерний пик получилась равной 21,8 км/ч; Дептранс сообщает о 21 км/ч.
Для проверки нужны поездки разной длины: от короткой дороги в магазин до пересечения всего города. Поэтому я запускал TD-Dijkstra из случайного перекрёстка и выбирал целью 64-й по порядку обхода перекрёсток, затем 128-й, 256-й и так далее вплоть до 16 384-го. По 50 стартовых точек для каждого из четырёх моментов времени — 3:00, 8:30, 13:00 и 18:30 — дали 1800 запросов. В часы пик продолжительность поездок составляла от двух минут до полутора часов. Все алгоритмы используют один и тот же код и различаются только эвристикой. Для каждого запроса я записывал число рассмотренных перекрёстков, время поиска и отклонение маршрута от самого быстрого.
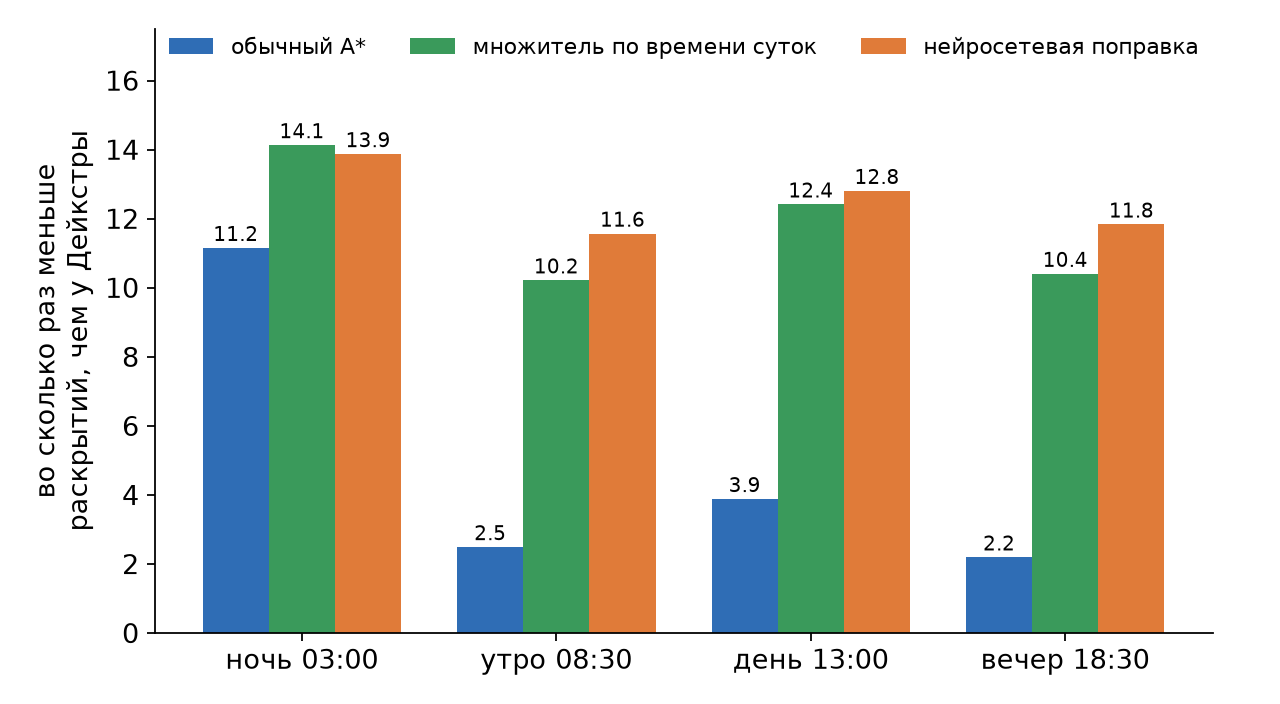
Обычный A* обозначен синим. Ночью он рассматривает в 11 раз меньше перекрёстков, чем алгоритм Дейкстры, днём — в 3,9 раза, а в часы пик — лишь в 2,2–2,5 раза.
Корректировка эвристики
Если в час пик оценка оказывается слишком оптимистичной, её можно умножить на коэффициент больше единицы. На этом основан взвешенный A* (Pohl, 1970): эвристику умножают на постоянное число, например на 2. Область поиска сужается, и маршрут иногда оказывается не оптимальным, но его стоимость превышает оптимальную не более чем в те же 2 раза. Недостаток в том, что коэффициент одинаков для всех ситуаций. В 3:00 оценку почти не нужно менять, а в 8:30 её стоит увеличить вдвое.
Поэтому я сделал множитель зависимым от положения и времени:
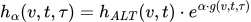
Здесь h_ALT — обычная оценка ALT от перекрёстка v до цели t. Функция g предсказывает логарифм отношения фактического времени в пути к этой оценке, если оказаться в v в момент τ. Коэффициент α от 0 до 1 регулирует силу поправки. При нуле получается обычный A* с гарантией оптимальности, при единице поправка применяется полностью. Иногда скорректированная оценка будет завышена, а маршрут — немного хуже оптимального. Именно эту цену я и измерял.
В процессе поиска эвристика используется в одном месте: при добавлении перекрёстка в очередь. Упрощённое ядро для всех вариантов выглядит так:
def search(graph, s, t, depart, h):
    arrive = {s: depart}                  # лучшее известное время прибытия
    done = set()
    queue = [(depart + h(s, depart), s)]
    while queue:
        _, u = heappop(queue)
        if u in done:
            continue                       # уже перебран, второй раз не трогаем
        done.add(u)
        if u == t:
            return arrive[t] - depart
        for v, travel_time in graph.edges(u):
            when = arrive[u] + travel_time(arrive[u])  # зависит от момента въезда
            if v not in done and when < arrive.get(v, inf):
                arrive[v] = when
                heappush(queue, (when + h(v, when), v))
Если передать функцию h, которая всегда возвращает ноль, получится TD-Dijkstra. Если передать ALT — обычный A*. Все корректировки отличаются только этой функцией. Извлечённый из очереди перекрёсток повторно не рассматривается, даже если позднее находится немного более короткий путь к нему. Благодаря этому число шагов не превышает размер графа, а завышение оценки отражается на качестве маршрута.
Я попробовал два способа предсказывать g. Первый использует таблицу по времени суток: по одному числу на каждые 15 минут, всего 96 значений. Они отражают, насколько фактическое время в среднем превышает оценку в соответствующий промежуток. Вот как выглядят эти значения:
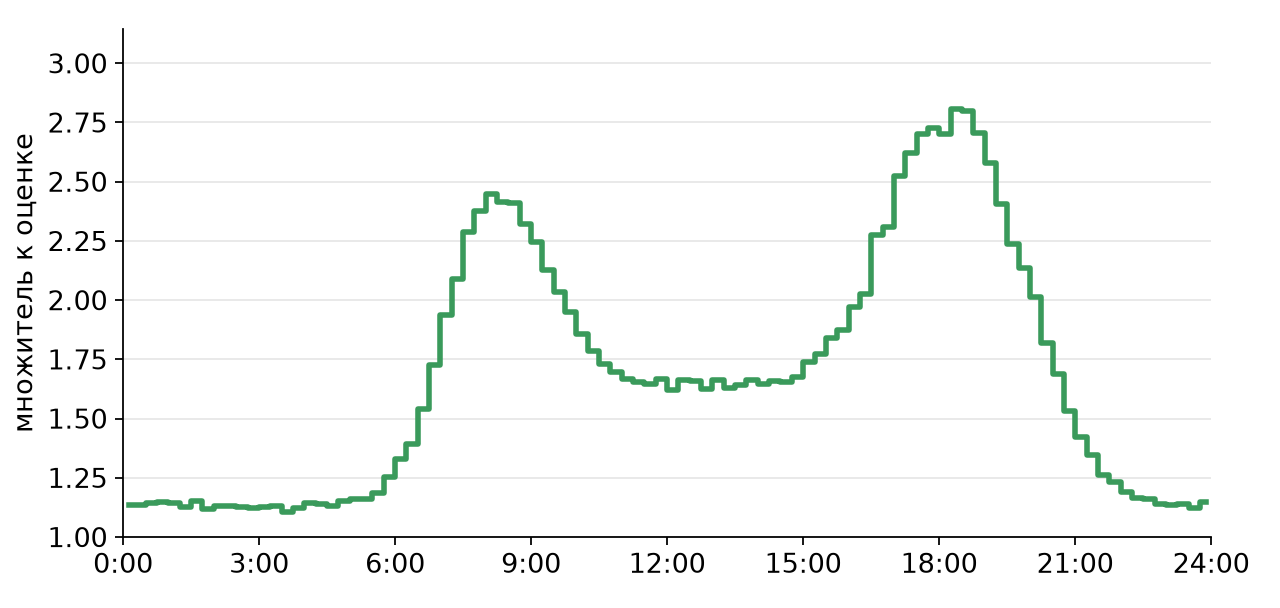
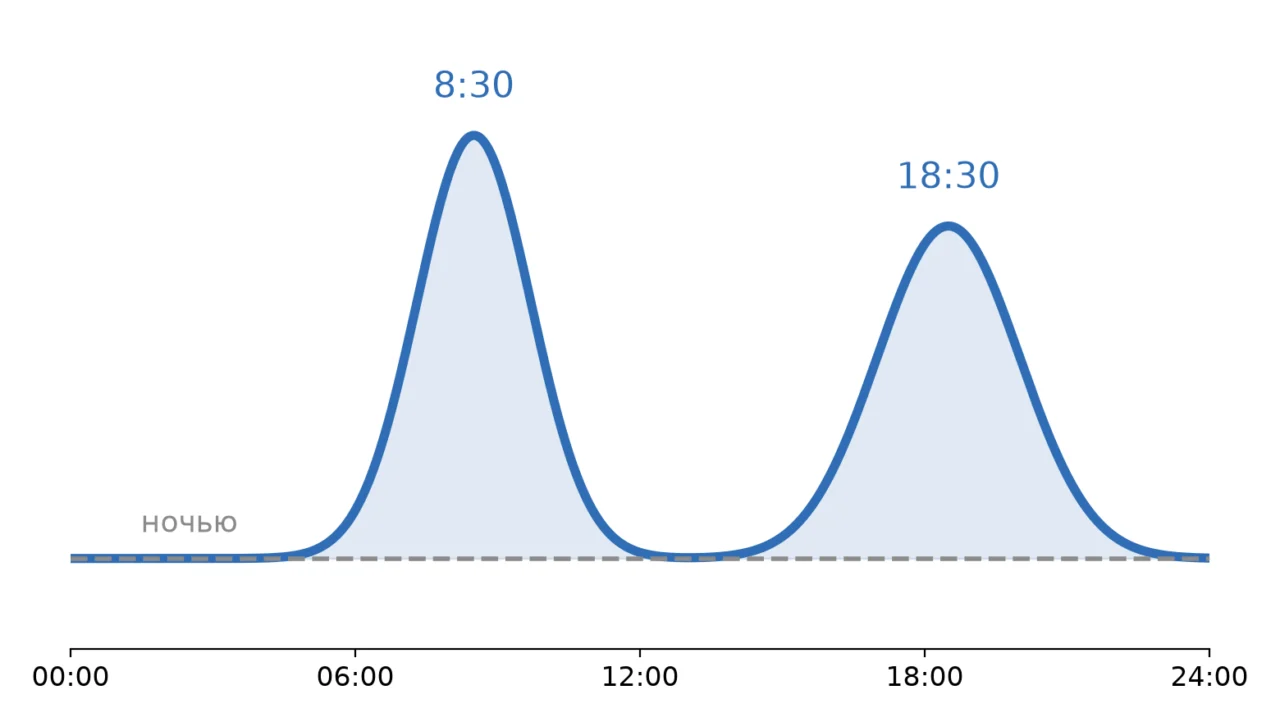
Ночью фактическое время в пути всего на 10–15% превышает оценку ALT, в утренний пик — в 2,4 раза, в вечерний — примерно в 2,8 раза.
Таблицу можно рассчитать в три строки:
bucket = (depart // 900).astype(int)                 # 96 корзин по 15 минут
table = np.array([log_ratio[bucket == b].mean() for b in range(96)])
h = lambda v, when: alt(v, t) * np.exp(alpha * table[int(when % 86400 // 900)])
В log_ratio хранится логарифм отношения фактического времени в пути к оценке ALT для каждого обучающего примера, а в depart — время отправления в секундах после полуночи. О том, как получены примеры, расскажу в разделе о нейросети.
Второй способ основан на нейросети. В отличие от таблицы, которая учитывает только время, сеть видит также начальную и конечную точки. В 8:30 поездка из центра на окраину проходит против основного потока и задержек на ней меньше, чем по дороге в центр. Таблица различить эти случаи не способна.
Нейросеть и её обучение
Сеть получилась очень небольшой. Это многослойный перцептрон с 10 входными значениями, двумя скрытыми слоями по 8 нейронов с ReLU и одним выходом. Всего у него 169 весов.
На вход подаются признаки, которые легко вычислить за несколько операций, когда поиск впервые достигает перекрёстка:
-
координаты перекрёстка и цели в километрах относительно Кремля — четыре числа;
-
расстояние каждого из них до центра — два числа;
-
расстояние между перекрёстком и целью по прямой;
-
логарифм оценки ALT;
-
время суток в виде синуса и косинуса, чтобы моменты 23:59 и 00:00 находились рядом.
На выходе сеть выдаёт логарифм отношения фактического времени в пути к оценке ALT. Логарифм удобен тем, что отклонения «в 1,1 раза больше» и «в 1,1 раза меньше» имеют одинаковый вес, а нужный множитель затем получается с помощью экспоненты. Если предсказание меньше нуля и, следовательно, предполагает время меньше допустимой оценки, я заменяю его нулём: приехать быстрее нижней границы нельзя.
Для обучения нужны точные времена в пути для большого числа сочетаний начальной точки, цели и времени отправления. Рассчитывать каждую поездку отдельно не требуется. Если не останавливать TD-Dijkstra при достижении цели, за один проход он найдёт точное время от старта до всех 19 473 перекрёстков. Таким образом, один запуск даёт сотни обучающих примеров:
X, y = [], []
for _ in range(2500):
    s, depart = random_vertex(), random.uniform(0, 24 * 3600)
    arrive = td_dijkstra(graph, s, depart)     # без цели: время до всех перекрёстков
    for t in pick_balanced(arrive, k=240):     # поровну близких и далёких целей
        X.append(features(s, t, depart))
        y.append(log((arrive[t] - depart) / alt(s, t)))
Я выполнил 2500 проходов из случайных перекрёстков в случайное время суток и из каждого взял по 240 целей, разделив их поровну на близкие и дальние. За 34 секунды на ноутбуке получилось 600 тысяч примеров. В среднем фактическое время в пути в 1,7 раза превышало оценку ALT, но разброс оказался большим. Ночью отношение обычно составляло около 1,1, в час пик — около 2,5, а для каждой десятой поездки в пик превышало три.
Сеть обучается с помощью scikit-learn — фреймворки глубокого обучения не потребовались:
net = MLPRegressor(hidden_layer_sizes=(8, 8), activation="relu",
                   batch_size=1024, early_stopping=True)
net.fit(X_train, y_train)
Для обучения я использовал среднеквадратичную ошибку, оптимизатор Adam и батчи по 1024 примера. Стартовые перекрёстки разделил на две группы: 85% отвёл для обучения, а оставшиеся 15% — для проверки на незнакомых местах. Обучение автоматически остановилось через 36 эпох, когда ошибка на небольшой контрольной части обучающих данных перестала снижаться. Оно заняло 4 секунды. Таблица по времени суток вычисляется простым усреднением по тем же 600 тысячам примеров.
На отложенных стартовых точках ошибка предсказанного сетью множителя в половине случаев составляет менее 5,3%, а у таблицы — менее 8,2%. Сеть 64×64 с 4,9 тысячи весов немного точнее: в половине случаев её ошибка ниже 4,4%. Далее станет понятно, почему я всё же остановился на маленькой сети.
Предсказания можно нанести на карту и увидеть, что сеть узнала о городе. Цвет на рисунке показывает, во сколько раз, по её оценке, время в пути превышает оценку ALT при поездке в 8:30 от каждого перекрёстка к Кремлю и в обратном направлении.
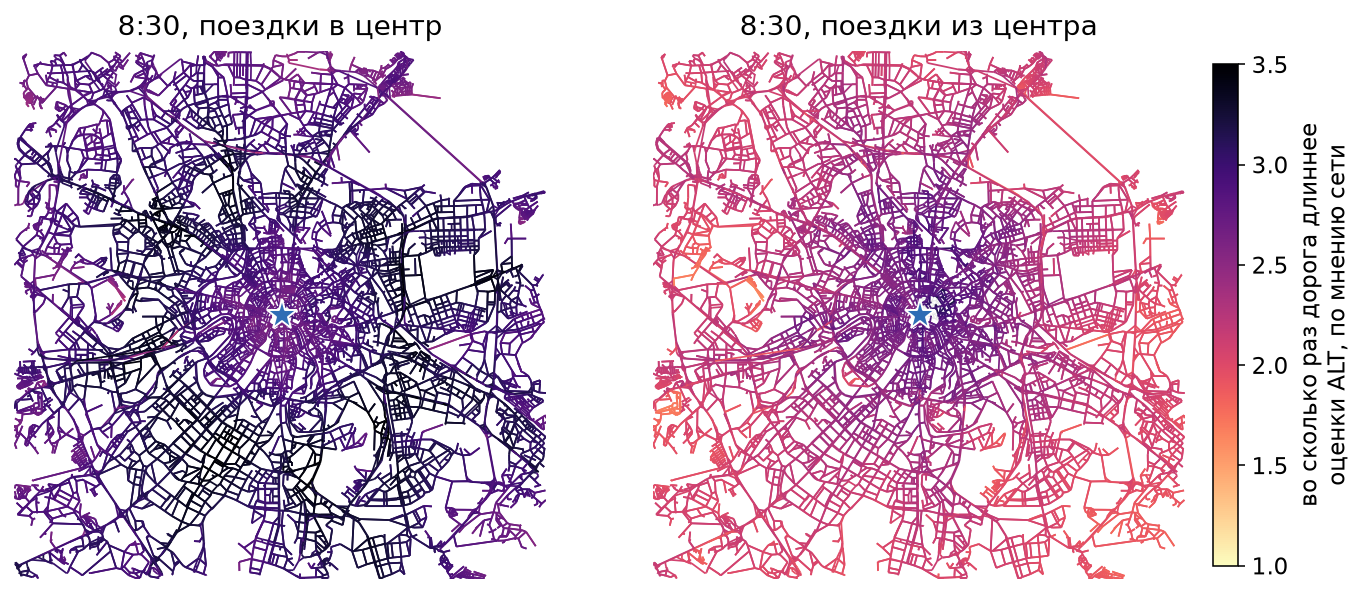
Слева показаны поездки в центр, справа — из центра. Чем темнее участок, тем выше множитель.
Направление транспортного потока я явно не задавал: сеть выявила его самостоятельно на обучающих примерах. Для поездки в центр в 8:30 она обычно предсказывает время втрое больше оценки, а для поездки из центра — в 2,25 раза. Таблица по времени суток даёт для обоих направлений одинаковый результат.
Во время поиска сеть вызывается один раз для каждого перекрёстка, когда он впервые попадает в очередь. Время прибытия берётся из текущего состояния поиска. Результат сохраняется, поэтому повторный вызов для того же перекрёстка не нужен. Само вычисление занимает четыре строки:
def g(x):                                  # x: 10 признаков
    h1 = np.maximum(W1 @ x + b1, 0)        # 10 → 8
    h2 = np.maximum(W2 @ h1 + b2, 0)       # 8 → 8
    return max(W3 @ h2 + b3, 0)            # 8 → 1, отрицательное обрезаем
Это примерно 150 умножений на перекрёсток. Для сети 64×64 требуется уже около 4800, и разница заметно влияет на время ответа.
Результаты
Чем сильнее поправка, тем меньше область поиска и тем чаще маршрут уступает оптимальному. Поэтому варианты удобно сравнивать по ускорению, полученному за каждый процент отклонения. На графике каждая точка соответствует отдельной настройке: значению α для поправок или весу для взвешенного A*.
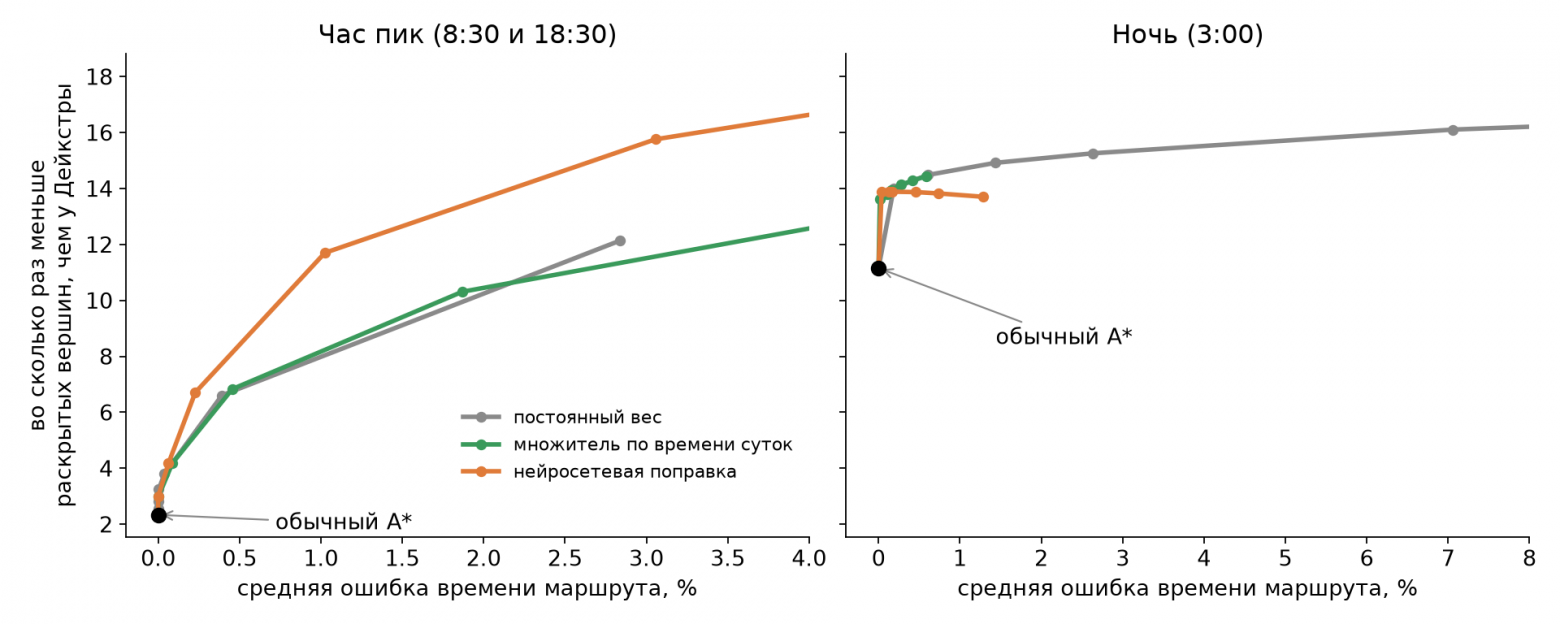
Слева показаны утренний и вечерний часы пик, справа — ночь. Чем выше и левее расположена кривая, тем лучше результат.
В час пик нейросеть при α = 1 рассматривает в 11,7 раза меньше перекрёстков, чем алгоритм Дейкстры, а маршрут в среднем всего на 1% дольше оптимального. Таблица сокращает перебор в 10,3 раза, но средняя ошибка у неё почти вдвое больше — 1,9%. Взвешенный A* при той же ошибке в 1% даёт примерно восьмикратное сокращение перебора.
Правая часть графика показывает слабость взвешенного A*. Вес 2, подходящий для часа пик, ночью увеличивает время маршрута в среднем на 7%, а для каждой двадцатой поездки — почти на 28%. Поправки с учётом времени суток ночью практически не меняют оценку и удерживают среднюю ошибку в пределах 0,5%.
Сводные результаты для часов пик — 8:30 и 18:30, всего 900 запросов:
|
|
Сокращение перебора относительно Дейкстры |
Ускорение по времени относительно Дейкстры |
Средняя ошибка маршрута |
95% маршрутов хуже оптимального не более чем на |
|---|---|---|---|---|
|
Обычный A* |
в 2,3 раза |
в 1,3 раза |
0 |
0 |
|
Взвешенный A*, вес 2 |
в 6,6 раза |
в 3,8 раза |
0,4% |
2,4% |
|
Таблица по времени суток |
в 10,3 раза |
в 7,3 раза |
1,9% |
9,8% |
|
Нейросеть 8×8 |
в 11,7 раза |
в 5,3 раза |
1,0% |
5,3% |
На дальних поездках преимущество заметнее. Для маршрута через половину города обычный A* в час пик рассматривает в 2,1 раза меньше перекрёстков, чем алгоритм Дейкстры, вариант с таблицей — в 16 раз, а с нейросетью — в 23 раза.
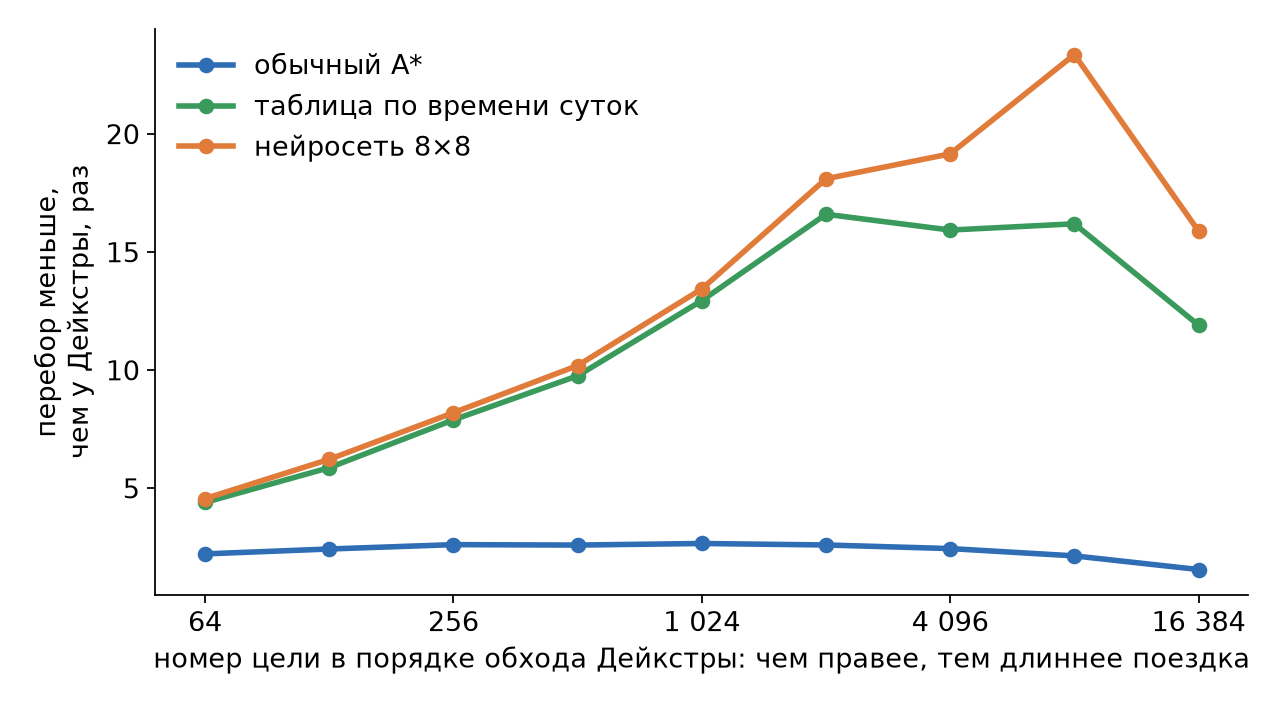
Для обычного A* длина поездки почти не влияет на выигрыш, а у методов с поправками преимущество растёт вместе с расстоянием.
Вот пример такого запроса в 8:30: маршрут с северо-запада на юго-восток.
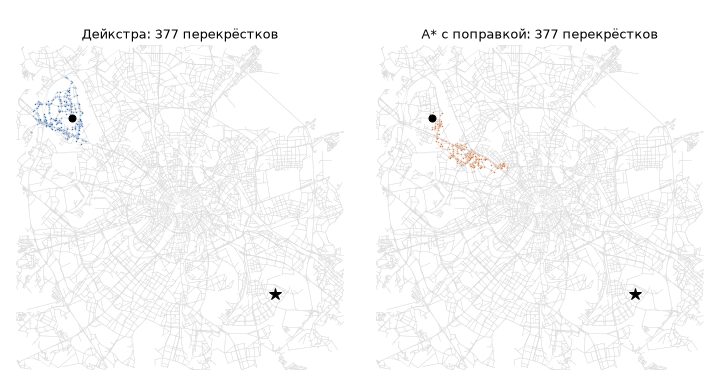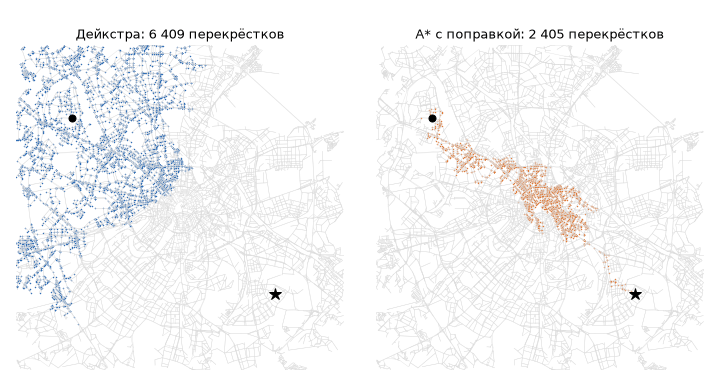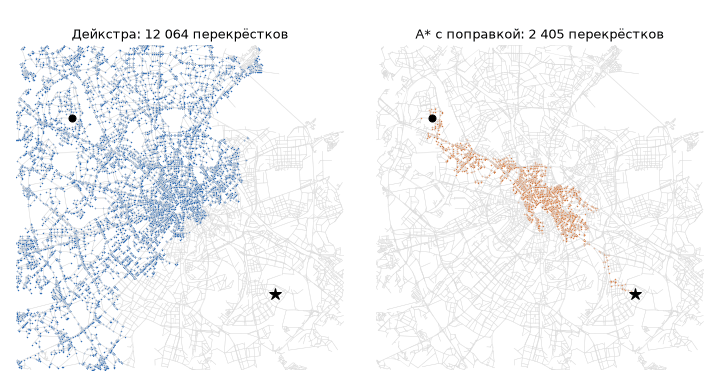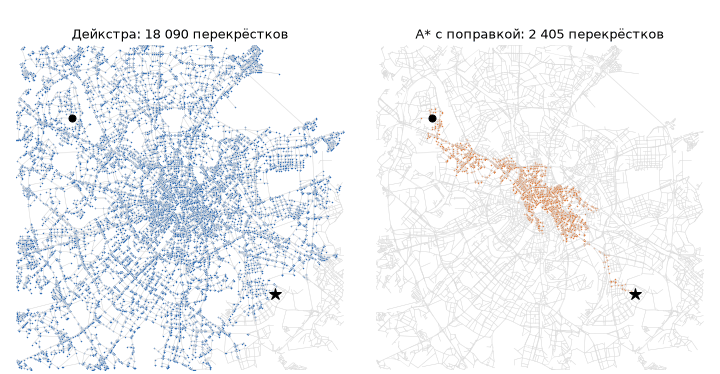
Точки обозначают перекрёстки, рассмотренные алгоритмом. Время поездки по маршруту Дейкстры составляет 80,6 минуты, по маршруту с поправкой — 80,8 минуты.
Алгоритм Дейкстры рассмотрел 18 090 перекрёстков — почти весь город. Обычный A* проверил 14 203 и исключил лишь восточную окраину. С поправкой область поиска сузилась до полосы через центр, а число рассмотренных перекрёстков составило 2405 — в 7,5 раза меньше. При этом маршрут оказался дольше на 15 секунд.
По фактическому времени поиска таблица опережает сеть. Для получения множителя достаточно прочитать одно значение из массива, тогда как сеть нужно вычислять для каждого нового перекрёстка. Поэтому важно сохранять её небольшой. Сеть 64×64 немного сокращает перебор — в 12,5 раза против 11,7, — но её вычисление занимает столько времени, что поиск становится медленнее алгоритма Дейкстры. Сеть 8×8 в час пик отвечает в 5,3 раза быстрее Дейкстры и в 4 раза быстрее обычного A*.
Выводы
Производительность A* в час пик падает из-за оценки оставшегося времени. Её рассчитывают для свободных ночных дорог, тогда как утром фактическое время в пути больше в 2–3 раза. В результате поиск по Москве сокращается всего в 2,3 раза вместо ночных 11.
Множитель, учитывающий время суток, позволяет вернуть значительную часть преимущества. В час пик число рассматриваемых перекрёстков уменьшается в 10–12 раз, а маршруты в среднем оказываются на 1–2% дольше оптимальных. Таблица из 96 чисел обеспечивает самый быстрый поиск — примерно в 7 раз быстрее Дейкстры по времени. Сеть 8×8 дополнительно учитывает направление потока и даёт примерно вдвое меньшую среднюю ошибку: для 95% её маршрутов отклонение не превышает 5,3%, тогда как у таблицы этот показатель составляет 9,8%. Обе поправки можно получить за минуту с помощью запусков алгоритма Дейкстры на том же графе и добавить к обычному A* без перестройки графа.
Выбор зависит от требований задачи. Если важнее время ответа, достаточно таблицы. Если приоритет — качество маршрутов, лучше подойдёт небольшая нейросеть.
Похожие статьи
 AlphaGenome 2: как глубокое обучение раскрывает механизмы регуляции генов и развития болезней
 Миниатюрные роботы смогут кувыркаться в сосудах и помогать растворять тромбы
 Астрономы впервые увидели исчезновение планеты-гиганта и выяснили, как это произошло
 Даже представители племени тумба-юмба…
 SpaceX опубликовала видео возвращения Starship на платформу Mechazilla
 Возможна ли внеземная жизнь в кислоте вместо воды?
 Статистическая механика жизни: новый взгляд на идеи Шрёдингера
 Что связывает крем от прыщей с эпидемией безумия?