Где грань между искусственным интеллектом и человеком?
Составляющие ИИ-грамотности
Главные выводы
-
Универсального критерия ИИ-грамотности не существует; опросники скорее отражают личную уверенность, чем объективный багаж знаний.
-
Хотя владение технологией, отношение к ней и интенсивность использования тесно связаны, причинно-следственную связь имеющиеся данные не раскрывают.
-
Мотивом для старта работы с ИИ служит практическая польза или личный интерес, тогда как значимость удобства и социального давления варьируется в зависимости от специфики инструмента.
-
Нейросети эффективно агрессируют информацию, которую сотрудники способны вербализовать при правильной постановке вопросов, однако глубинный невыразимый опыт остается за рамками их возможностей.
-
Успешная сдача экзаменационных тестов не гарантирует надежности ИИ в реальной практической деятельности — в сложных и нетривиальных кейсах финальный контроль всегда остается за экспертом-человеком.
Часть 1. ИИ-грамотность
Что подразумевают под «ИИ-грамотностью» и почему трактовки разнятся?
Суть в двух словах: Под ИИ-грамотностью (AI literacy) понимают комплекс компетенций, позволяющий критически осмыслять работу искусственного интеллекта, взаимодействовать с ним и внедрять его в профессиональную среду и быт. Универсального стандарта нет, каждый исследователь вкладывает в этот термин собственное видение.
Одни эксперты сводят понятие исключительно к техническим знаниям и сценариям применения. Другие интегрируют сюда эмоциональный интеллект, ценностные ориентиры, психологическую устойчивость и чувство личной ответственности. Специалисты по образовательным программам отмечают зависимость термина от контекста: так возникли понятия «GenAI-грамотность» и узкоспециализированная «ChatGPT-грамотность» для лингвистических дисциплин. При этом в академической среде принято разграничивать грамотность и «ИИ-компетентность», под которой подразумевают интуитивное и свободное владение инструментами.
Практический кейс: HR-менеджер инициирует разработку обучающего модуля по ИИ для персонала. Прежде чем утверждать бюджет на курс, он фиксирует, что именно будет заложено в основу: архитектура нейросетей, навыки промптинг-инжиниринга или способность верифицировать сгенерированный контент. От этого напрямую зависит программа и метрики эффективности.
2. Какие ключевые навыки формируют ИИ-грамотность?
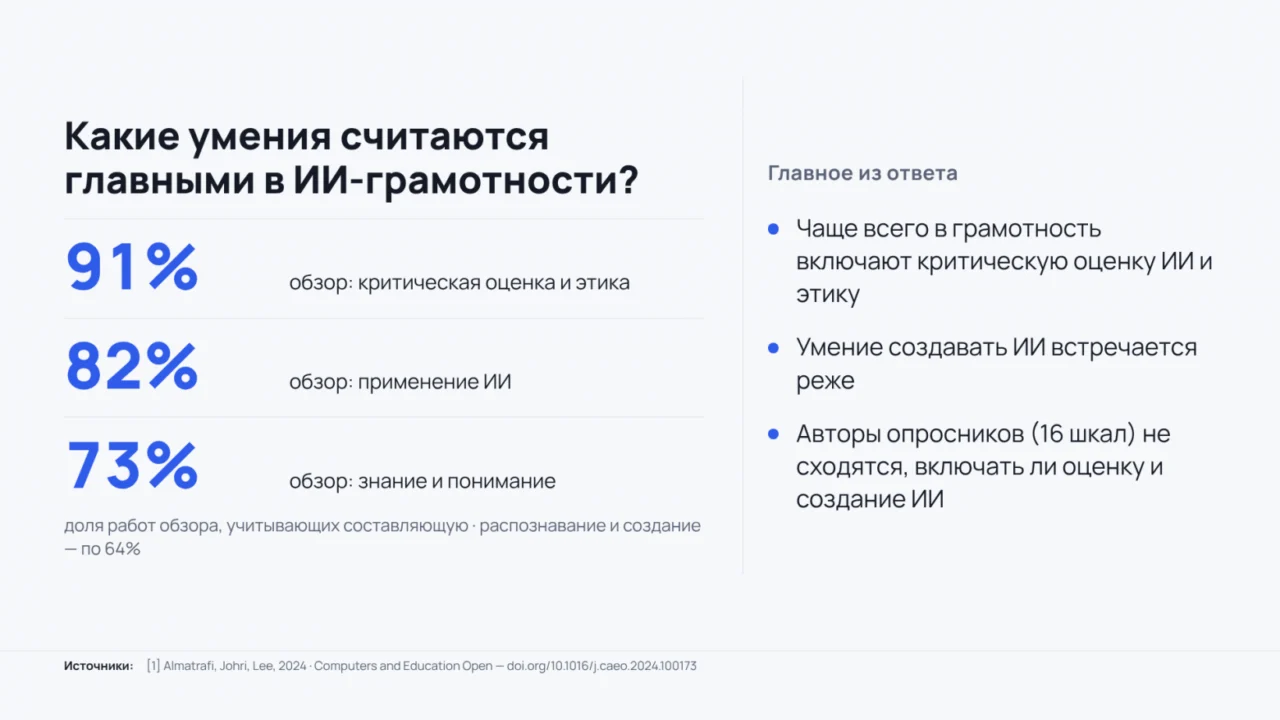
Суть в двух словах: Базовыми навыками чаще всего признаются критическое мышление и понимание этических аспектов, в то время как компетенции по созданию ИИ востребованы реже.
В одном из масштабных аналитических обзоров выделено шесть фундаментальных векторов: идентификация ИИ, теоретическая база, практическое применение, аналитическая оценка, разработка и соблюдение этических норм. Критерии критической оценки и этики фигурируют в 91% проанализированных трудов, практическое использование — в 82%, концептуальное понимание — в 73%, а распознавание и создание — в 64% случаев. Иная картина наблюдается в диагностических опросниках: метаанализ 16 шкал показал отсутствие консенсуса относительно включения в них блоков по разработке и оценке. Для студенческого сообщества приоритетным навыком названо умение распознавать сбои алгоритмов и критически фильтровать входящие массивы данных.
Практический кейс: Контент-редактор создает статьи при поддержке языковых моделей. Для него уровень грамотности измеряется не только качеством составления запросов, но и железной привычкой перепроверять фактуру и следить за соблюдением авторских прав.
3. Каким образом оценивают ИИ-грамотность и можно ли полагаться на самооценку?
Суть в двух словах: Инструментарий делится на субъективные анкеты и объективные тесты. Анкетирование отражает скорее личную уверенность респондента, чем его реальный багаж знаний.
Сравнительный анализ корреляций продемонстрировал: взаимосвязь с сопутствующими показателями оказывается значительно выше при использовании опросников самооценки, нежели при объективном тестировании. Исследователи связывают это с когнитивными искажениями. Респонденты с минимальным уровнем компетенций часто страдают от эффекта Даннинга-Крюгера, переоценивая свои возможности, в то время как эксперты склонны к излишней самокритике. Кроме того, людям в целом свойственно приукрашивать собственные успехи. Предполагается, что анкеты замеряют психологический барьер и уверенность при взаимодействии с софтом, а не академические знания. Тестирование же имеет свои изъяны в виде угадывания вариантов.
Практический кейс: Бизнес-аналитик проектирует опросник готовности команды к внедрению ИИ. В итоговом отчете он фиксирует формулировку «сотрудники оценивают свой уровень владения как…», избегая утвердительных заявлений о реальной квалификации, а для принятия кадровых решений дополняет опрос практическим кейс-заданием.
4. С какими факторами коррелирует уровень ИИ-грамотности?
Суть в двух словах: Продвинутые пользователи демонстрируют меньший уровень тревожности, более лояльное отношение, высокий кредит доверия к технологиям и устойчивую потребность в их регулярном применении. Речь идет о статистической связи, а не о прямой причинно-следственной логике.
Согласно обзору, грамотность коррелирует с учебной мотивацией, ожиданием бизнес-эффекта, восприятием интерфейсов как интуитивно понятных и личной уверенностью. Авторы подчеркивают необходимость комплексного подхода в образовательных програмх: развивать следует не только технические навыки, но и формировать правильный майндсет. Важная ремарка: поскольку наличие связи не доказывает причинность, подобные выводы остаются на уровне гипотез.
Практический кейс: Продакт-менеджер в ходе глубинных интервью замечает, что углубленное понимание ИИ стимулирует пользователей активнее кликать по AI-фичам. Воздерживаясь от поспешных выводов вроде «проведем вебинар — поднимем метрики», он проверяет гипотезу на контрольной и фокусной группах с разным онбордингом.
5. Зависит ли уровень ИИ-грамотности от демографических параметров — возраста и пола?
Суть в двух словах: В рамках проанализированных выборок — практически нет. Однако поскольку большинство исследований проводилось на базе университетов, экстраполировать эти данные на все возрастные категории преждевременно.
В академическом обзоре указано, что возраст и ключевые социально-демографические признаки слабо коррелируют с уровнем грамотности в студенческой среде. Однородность возрастного состава респондентов объективно затрудняет выявление подобных закономерностей. Аналогичные результаты зафиксированы в исследовании восприятия ChatGPT: пол и возраст не выступали медиаторами между эмоциональным фоном и готовностью использовать инструмент. Тем не менее, другие изыскания фиксируют, что молодые респонденты и мужчины чаще демонстрируют оптимизм по отношению к концепции «технологической сингулярности» (превосходству машин над людьми). Это относится к категории установок, которые косвенно влияют на восприятие образовательного контента.
Практический кейс: Маркетолог готовит запуск обучающего вебинара по новому функционалу. Он отказывается от сегментации аудитории по принципу «старшее поколение хуже справляется с технологиями», поскольку эмпирическая база не подтверждает этот стереотип для взрослой платежеспособной аудитории.
6. Как эксплуатация ИИ на рабочем месте трансформирует уверенность и инициативность сотрудников?
Суть в двух словах: В ряде кейсов использование нейросетей стимулирует инновационное мышление и рост самоуважения, однако на монотонных операциях может приводить к атрофии профессиональных навыков.
Согласно первому исследованию, в условиях интеллектуально сложного труда ИИ берет на себя рутину и выдает экспертные подсказки, высвобождая ресурсы для креатива и повышая уверенность специалиста. На примитивных операциях алгоритмы полностью дублируют человека, что ведет к деградации компетенций и падению мотивации. Второе исследование подчеркивает роль личной позиции: проактивные сотрудники видят в ИИ трамплин для профессионального роста, консервативно настроенные — прямую угрозу трудоустройству.
Практический кейс: Руководитель службы поддержки внедряет AI-подсказки для операторов. Чтобы предотвратить деквалификацию команды на простых тикетах, он сохраняет практику регулярных ручных разборов сложных инцидентов без привлечения алгоритмов.
7. Способствует ли ИИ-грамотность преодолению профессионального выгорания и стресса?
Суть в двух словах: Два независимых исследования заявляют о такой тенденции, хотя выводы авторов порой звучат оптимистичнее, чем сырые эмпирические данные.
Учащиеся с высоким уровнем ИИ-грамотности показывают лучшие результаты в академическом письме и демонстрируют более высокий уровень психологического благополучия при работе с генеративными моделями. Упоминается снижение тревожности перед созданием текстового контента и усиление локуса контроля. Среди молодых преподавателей китайских вузов ИИ-грамотность выступает буфером между рабочей нагрузкой и выгоранием. Логика исследователей проста: продвинутые пользователи молниеносно автоматизируют рутину (например, скрининг профильной литературы) за счет нейросетей.
Практический кейс: Тимлид предлагает разработчикам использовать ИИ-ассистентов для генерации типового кода с целью снижения когнитивной нагрузки. Эту инициативу он презентует не как панацею от выгорания, а как рабочую гипотезу, договариваясь замерить метрики самочувствия и дедлайнов через месяц.
Часть 2. Мотивация к внедрению ИИ
8. Что представляют собой «модели принятия технологий» и каковы их выводы относительно ChatGPT?
Суть в двух словах: Это теоретические концепции, объясняющие готовность индивида внедрять инновации. В отношении генеративного ИИ ключевыми предикторами выступают воспринимаемая польза, субъективное отношение и давление социального окружения.
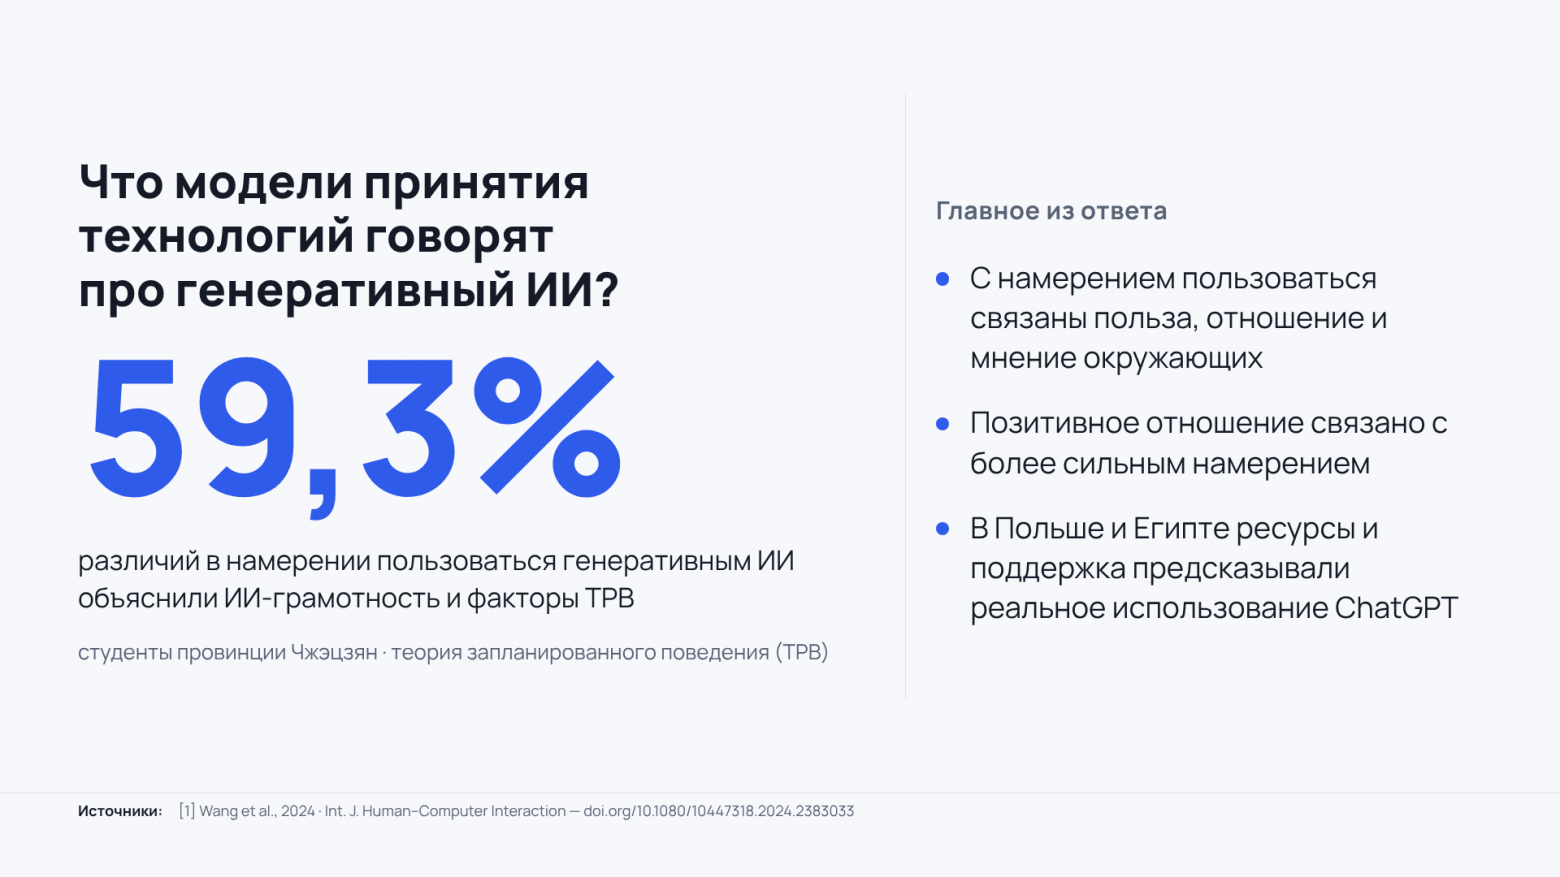
В академическом поле доминируют четыре ключевые модели. TAM фокусируется на полезности и простоте интерфейса. Теория запланированного поведения (TPB) оценивает личные установки, социальные нормы и степень контроля. UTAUT аккумулирует восемь классических парадигм, учитывая ожидаемый эффект, трудозатраты, влияние референтной группы и ресурсную базу. VAM добавляет экономический аспект и фактор удовольствия. Эмпирическое исследование среди студентов провинции Чжэцзян показало, что ИИ-грамотность в синергии с конструктами TPB объясняет 59,3% дисперсии намерений использовать генеративный софт. Благожелательное отношение напрямую коррелирует с готовностью к внедрению. Кросс-культурный анализ студентов Польши и Египта подтвердил, что наличие инфраструктуры и технической поддержки выступает универсальным триггером использования ChatGPT.
Практический кейс: Продакт-менеджер, выводящий на рынок AI-инструмент, формирует гайд для пользовательских интервью на базе этих моделей. Он проверяет гипотезы: очевидна ли польза? интуитивен ли интерфейс? пользуются ли продуктом коллеги? обеспечен ли доступ к инструкциям?
9. Что играет первенство в принятии ИИ: утилитарная польза, юзабилити или эмоциональный отклик?
Суть в двух словах: Результаты исследований разнятся. Чаще пальму первенства удерживает практическая ценность или удовольствие от процесса, в то время как фактор простоты демонстрирует переменную значимость.
Для студенческой аудитории ключевым драйвером внедрения ChatGPT выступала внутренняя мотивация (любопытство и удовольствие), следом шла польза. При этом простота интерфейса прямой корреляции с намерениями не показала. В параллельном исследовании доминантой выступала исключительно полезность: юзабилити влияло слабо, но опосредованно усиливало восприятие ценности продукта. В сегменте умных ИИ-устройств на первый план вышел фактор удовольствия, сравнявшись по значимости с ожидаемым функционалом. Объяснение кроется в специфике сценариев: для утилитарных продуктов (например, шеринга самокатов) критически важна простота, тогда как универсальные мультимодальные ассистенты ценятся за комплексную пользу.
Практический кейс: UI/UX-дизайнер ИИ-ассистента не ограничивается полировкой интерфейса. На стартовом экране он наглядно демонстрирует прикладные сценарии решения задач, поскольку для сложных чат-ботов демонстрация реальной пользы критически важнее минимализма.
10. Оказывает ли влияние мнение коллег и референтной группы?
Суть в двух словах: Большинство научных работ дает утвердительный ответ, хотя часть исследователей фиксирует снижение этого эффекта в отношении массовых чат-ботов.
Исследование польских и египетских студентов подтвердило прямую связь социального влияния с намерениями использовать ChatGPT, подчеркивая вес мнения профессорско-преподавательского состава и администрации. Китайские ученые установили, что социальные нормы формируют отношение к технологии и чувство уверенности. В сегменте умных гаджетов с ИИ социальное давление выступает вторым по значимости фактором. Это объясняется дефицитом личного опыта взаимодействия у пользователей. Альтернативная точка зрения гласит, что благодаря повсеместному распространению языковые модели миновали стадию осторожного тестирования, когда мнение окружения было критически важно, и перешли в фазу рутинного принятия.
Практический кейс: B2B-маркетолог закладывает в промо-кампанию нового AI-модуля кейсы и отзывы авторитетных экспертов профильной индустрии: согласно преобладающей массе исследований, социальное доказательство по-прежнему стимулирует решение о первой покупке.
11. Выступает ли страх перед ИИ барьером для его распространения?
Суть в двух словах: Все зависит от природы страха. Фобии масштаба «технологической сингулярности» негативно сказываются на лояльности к ИИ, тогда как опасения утратить профессиональные навыки в отдельно взятых исследованиях корреляции не показали.
Индивидуумы, прогнозирующие апокалиптические сценарии и тотальное превосходство машин над людьми, демонстрируют наибольшее отторжение инноваций. Второе исследование показало, что страх «интеллектуальной лени» и деградации когнитивных способностей не оказывает прямого влияния на отношение к софту. Третье описывает корпоративный сегмент, где сотрудники воспринимают ИИ как прямую угрозу рабочим местам, что снижает их готовность к оправданному риску. Речь идет о принципиально разных фобиях, поэтому противоречия в выводах отсутствуют.
Практический кейс: Контент-стратег готовит коммуникационную кампанию по внутреннему внедрению ИИ. Он разводит по разным блокам возражения «нас заменят» и «мы разучимся мыслить самостоятельно», понимая на основе научных данных, что за ними стоят совершенно разные психологические триггеры.
Часть 3. Неявное знание и нейросети
12. Что такое неявное знание (tacit knowledge) и почему его сложно эксплицировать?
Суть в двух словах: Это экспертный опыт, которым специалист владеет на интуитивном уровне, но не может четко сформулировать словами. Трудность передачи усугубляется тем, что обладатель часто не осознает наличие у себя этих компетенций.
В академической литературе используется термин tacit knowledge. Классическая дефиниция философа Майкла Полани звучит так: «мы знаем больше, чем можем выразить словами». Хрестоматийные примеры — навык езды на велосипеде или способность мгновенно узнавать лица в толпе. Подобный опыт невозможно почерпнуть из учебников, он аккумулируется исключительно через практику. Один из исследователей проводит параллель с естественным языком: у него есть грамматические правила, но ими язык не исчерпывается, а носители осваивают его интуитивно. Knowledge-менеджеры веками извлекали такие знания вручную с помощью глубинных интервью, анкетирования и анализа бизнес-процессов, что требовало привлечения дорогостоящих экспертов.
Практический кейс: Тимлид разработки фиксирует, что ведущий архитектор мгновенно локализует критический баг, но не способен объяснить алгоритм поиска. Перед нами классический пример неявного знания, которое не попадет в корпоративную базу знаний автоматически.
13. Возможно ли в принципе перевести неявное знание в форму структурированного текста?
Суть в двух словах: Лишь частично. Расхождения в позициях экспертов обусловлены тем, что под термином «неявное знание» они понимают разные сущности.
Одна концепция делит знание на три пласта. Явное знание полностью упаковывается в регламенты. Латентное знание скрыто от сознания, но может быть вербализовано прицельным вопросом или в рабочей обстановке. Неявное знание в строгом смысле слова не поддается экспликации (например, тонкое мастерство ремесленника). Альтернативный подход разделяет ноу-хау на выразимую часть (алгоритмы, эвристики) и невыразимую (мышечная память, телесный опыт). Обзоры литературы констатируют, что неявное знание нельзя транслировать через документы, и тут же указывают глубинные интервью в качестве лучшего метода его фиксации. В свою очередь, модель SECI описывает непрерывную трансформацию неявного знания в явное как стандартный эволюционный цикл организации.
Практический кейс: Сотрудник службы заботы интуитивно чувствует, как урегулировать конфликт с токсичным клиентом. Базовые скрипты и регламенты охватывают лишь латентную часть этого навыка, тогда как эмпатия и тонкая интонация остаются за пределами текстовых инструкций.
14. Каким образом ИИ оптимизирует сбор экспертизы сотрудников?
Суть в двух словах: В научной литературе рассматриваются два сценария: автономный ИИ-агент, опрошивающий персонал по оргструктуре, и интеллектуальный помощник, помогающий мастерам рефлексировать над производственным опытом. Первый метод пока апробирован исключительно в симуляциях.
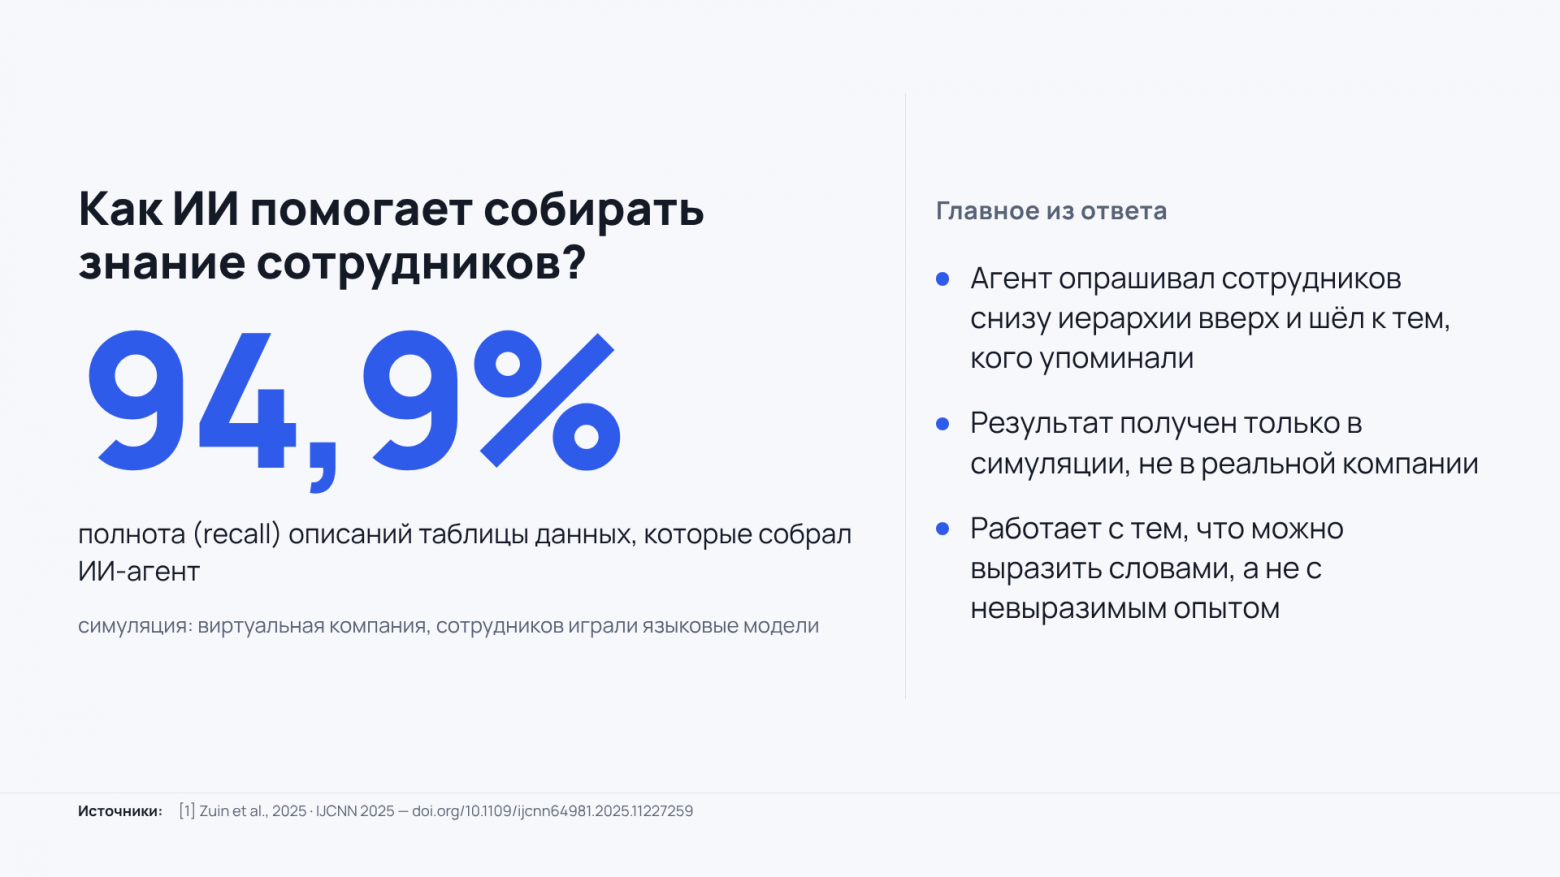
В первом эксперименте агент получил задачу составить дата-миграционный словарь, обладая лишь именами таблиц и полей. Он последовательно опрашивал сотрудников снизу вверх по иерархии, динамически выстраивая цепочку респондентов. Важная оговорка: среда и сами сотрудники были виртуальными, роли исполняли языковые модели. В этих тепличных условиях агент сформировал искусно детализированное описание без прямых контактов с первоисточниками, показав полноту поиска (recall) на уровне 94,9%. Второй сценарий описывает ассистента, который после завершения производственного цикла выводит на экран телеметрию линии и запрашивает у оператора причины корректировок, увязывая ответы с графом знаний оборудования. Авторы подчеркивают уникальность системной рефлексии. Оба решения работают с вербализуемым опытом, то есть преимущественно с латентными знаниями.
Практический кейс: Дата-аналитик сталкивается с легаси-базой данных без документации. Описанный в исследовании алгоритм подсказывает методологию: выстраивать интервьюирование снизу вверх, начиная с рядовых операторов таблиц и продвигаясь к ключевым владельцам процессов.
15. Какой этап работы со знаниями остается за рамками возможностей ИИ?
Суть в двух словах: Интеграция информации с реальным жизненным опытом. Нейросети агрессируют цифровые фрагменты, но смысловой контекст им придает исключительно человек.
Концепция GenAI SECI вводит дефиницию «цифровое фрагментированное знание» — разрозненные паттерны цифровой среды, с которыми традиционные базы данных не справлялись, а генеративный ИИ справляется успешно. Тем не менее, авторы подчеркивают: увязку абстрактных формулировок с реальным физическим миром осуществляет человек через личную рефлексию и практику. Другая школа мысли идет еще дальше, утверждая, что генерация подлинного неявного знания — эксклюзивная прерогатива человека, и машины никогда не смогут полностью заметить этот механизм. Оба тезиса носят концептуально-теоретический характер.
Практический кейс: UX-исследователь агрегирует с помощью ИИ массив инсайтов из десятков записей юзабилити-тестов. Нейросеть структурирует текстовые фрагменты, но приоритезацию продуктовых гипотез осуществляет сам эксперт, основываясь на эмпатии к пользователям.
Часть 4. Экспертная точность LLM в профессиональных нишах
16. Насколько высока точность языковых моделей в медицинской сфере?
Суть в двух словах: Стандартные врачебные экзамены модели сдают успешно, однако показатели точности в реальной клинической практике заметно ниже и демонстрируют колоссальный разброс.
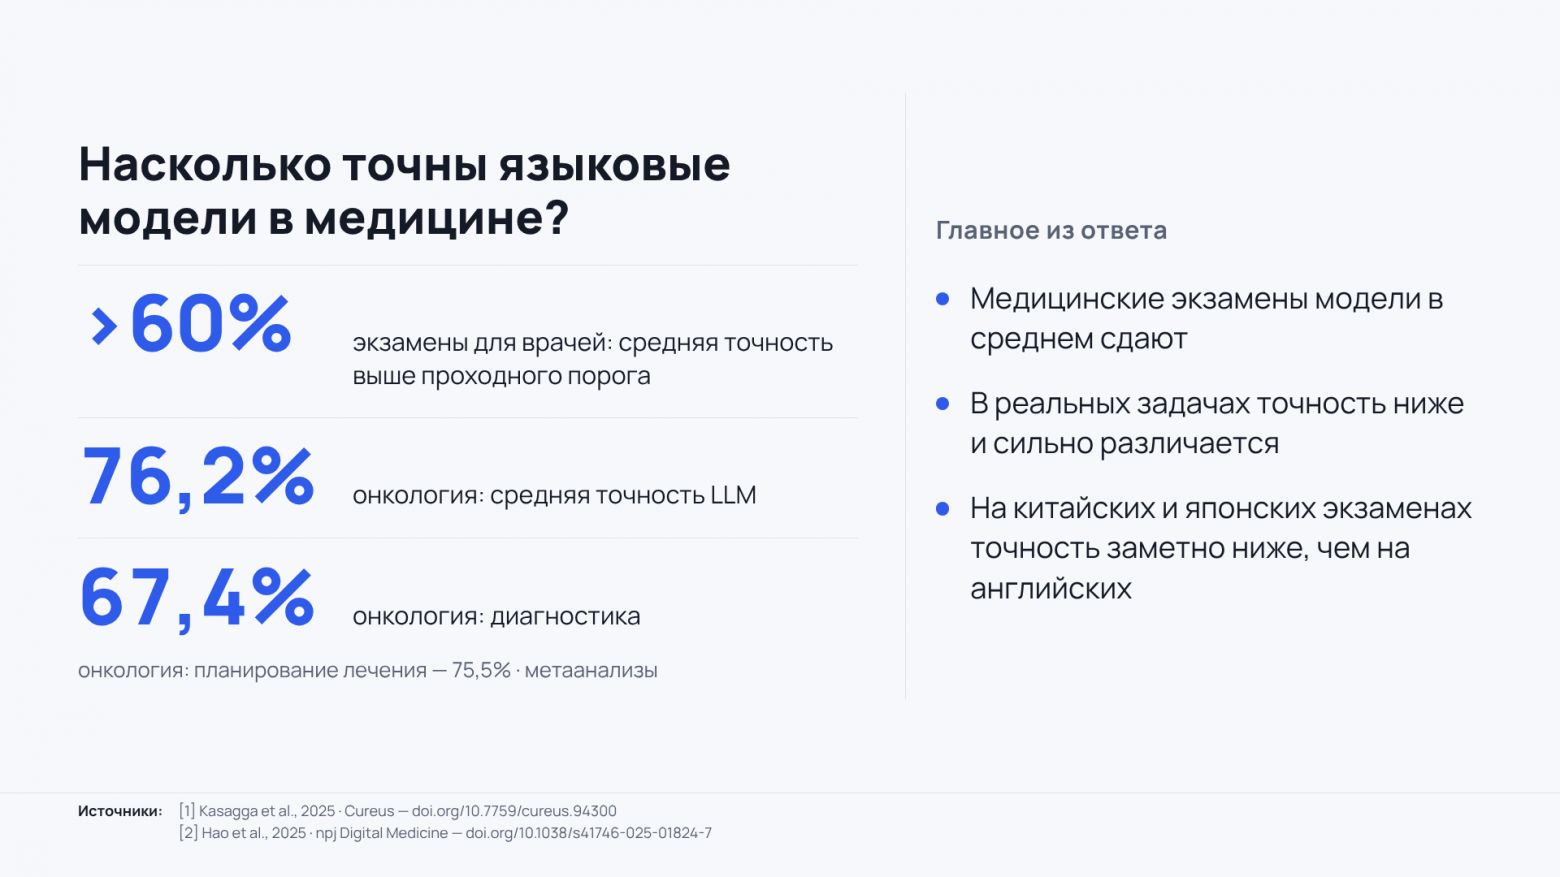
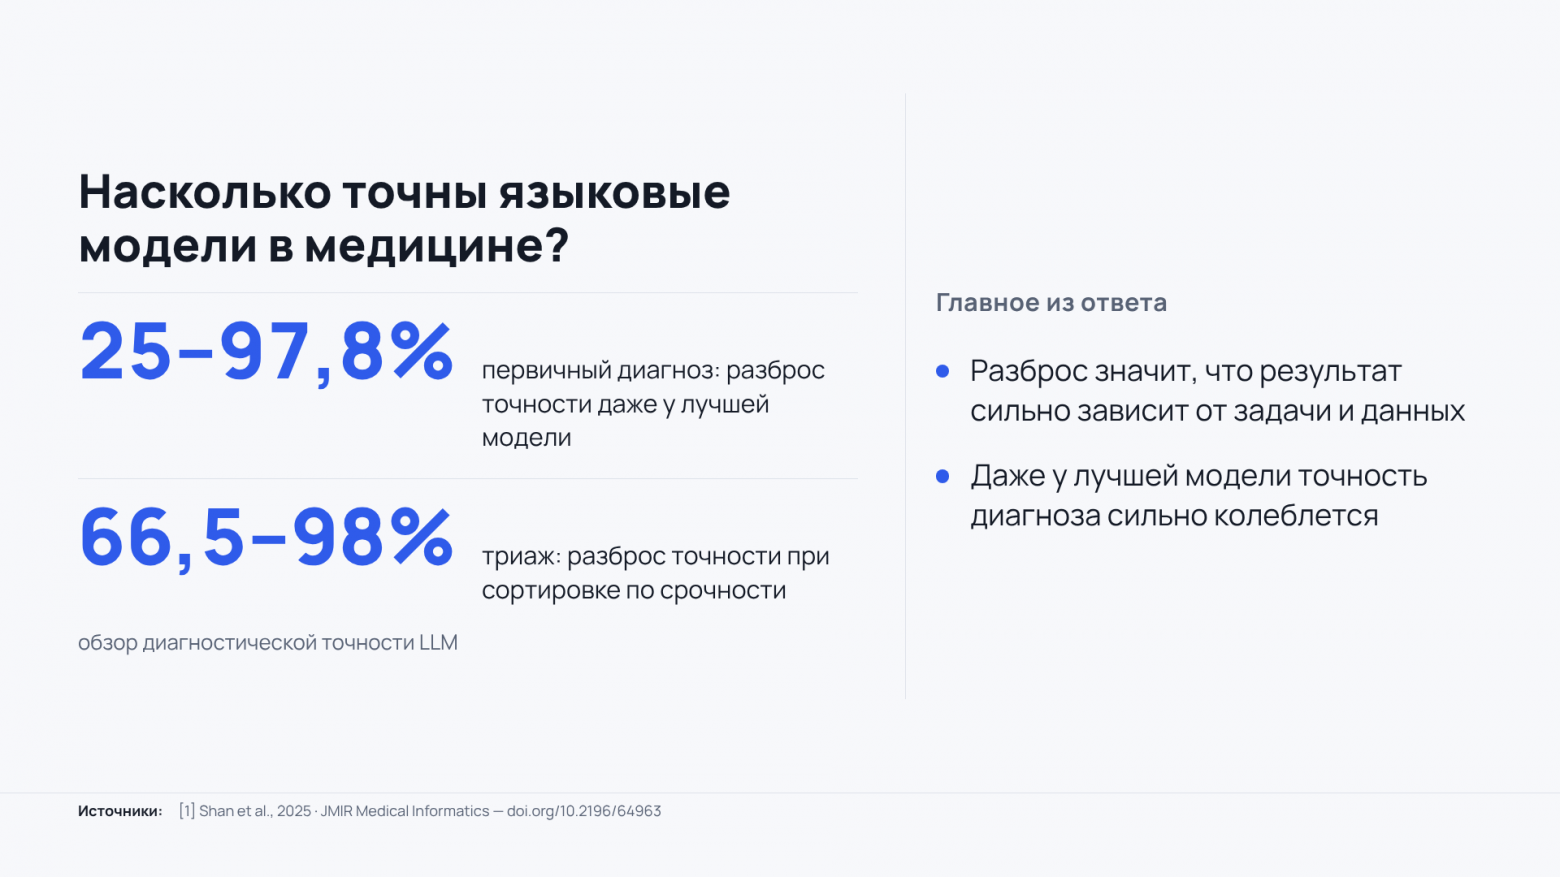
Метаанализ тестирования на национальных медицинских лицензиатах показал средний балл выше проходного порога в 60%. В онкологическом сегменте средняя точность моделей составила 76,2%, при разработке протоколов лечения — 75,5%, в диагностике — 67,4%. Обзор диагностических метрик выявил, что у передовых моделей точность постановки первичного диагноза варьировалась от 25% до 97,8%. В триаже пациентов (сортировке по степени срочности) разброс составил от 66,5% до 98%. Столь вариативные показатели доказывают критическую зависимость результатов от специфики клинической задачи и качества обучающей выборки. Примечательно, что на китайских и японских экзаменах точность оказалась существенно ниже по сравнению с англоязычными аналогами.
Практический кейс: Продакт-менеджер медицинского софта, услышав тезис «модель блестяще сдает медицинские экзамены», требует предоставить метрики точности для конкретной локальной задачи и на целевом языке будущего продукта.
17. Почему успешная сдача тестов не тождественна готовности к реальной работе?
Суть в двух словах: Тестирование базируется на искусственных или усеченных массивах данных, далеких от реальных бизнес-процессов. Авторы онкологического обзора категорически отвергают идею полной автоматизации медицинских решений с помощью LLM.
Исследователи выделяют ключевые зоны риска: 1) Риск слепого доверия со стороны медперсонала и пациентов. 2) Оценка на синтетических датасетах без глубокого анализа побочных эффектов. 3) Угрозы утечки конфиденциальных данных, алгоритмическая предвзятость из-за нерепрезентативных выборок и плохая масштабируемость на другие группы пациентов. 4) Закрытость обучающих датасетов, затрудняющая независимый аудит. Аналогичная ситуация наблюдается в юриспруденции: успешно справляясь с теоретическими кейсами, LLM демонстрируют слабые знания правовой фактологии (см. пункт 19). Способность выстраивать логические цепочки и владение верифицированными фактами — принципиально разные компетенции. Тем не менее, ценность ИИ в роли интеллектуального ассистента (синтез рекомендаций, подготовка выписок) не вызывает сомнений.
Практический кейс: Системный аналитик проводит стресс-тестирование AI-модуля перед релизом. Вместо синтетических тест-кейсов он загружает исторические логи реальных запросов и отдельно просчитывает потенциальный ущерб от каждого типа алгоритмической ошибки.
18. В каких сценариях нейросети ошибаются с наибольшей вероятностью?
Суть в двух словах: В зонах дефицита обучающих данных и при столкновении с нетипичными кейсами — в узких специализациях, локальных юрисдикциях и сложных междисциплинарных вопросах.
Медицинские обзоры фиксируют, что узкоспециализированные доменные знания представлены в массивах претрейна фрагментарно, из-за чего модели сбоят при анализе нюансированных симптомов. Лингвистические барьеры также играют роль: на локальных языках точность падает. В правовой сфере риски максимальны при анализе прецедентов судов низших инстанций, специфических региональных норм и запутанных коллизий. Вероятность ошибки многократно возрастает, если в самом запросе изначально заложена ложная предпосылка.
Практический кейс: Контент-маркетолог локализует базу знаний с помощью ИИ. Англоязычную версию он валидирует выборочно, тогда как статьи по узкоспециализированным техническим темам и локализации на редких языках отдает на стопроцентную вычитку профильным экспертам.
19. Допустимо ли доверять языковым моделям юридические задачи?
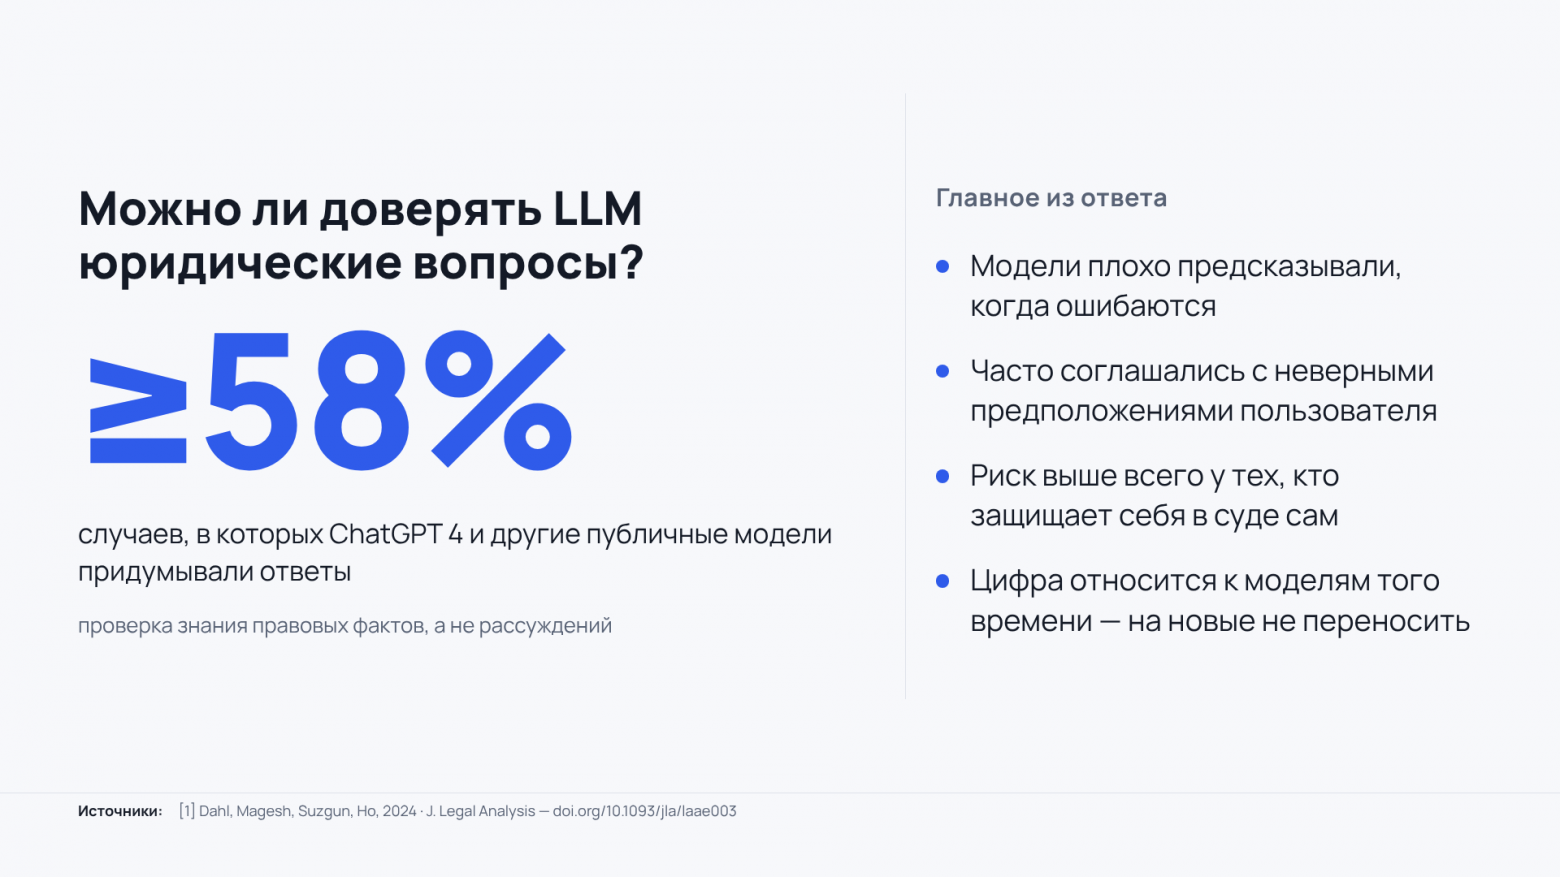
Суть в двух словах: Флагманские публичные модели (включая ChatGPT-4) демонстрировали до 58% вымышленных или некорректных ответов в правовом поле.
Подобные генерации называют «галлюцинациями». Исследования тестировали не логическое мышление, а точность юридической фактологии. Помимо высокой частоты ошибок, модели не умели рефлексировать над собственной некомпетентностью и легко соглашались с ошибочными вводными пользователя. Эксперты резюмируют: парадоксальным образом наибольшему риску подвергаются те, кому ИИ мог бы помочь сильнее всего — граждане без бюджета на юристов, занимающиеся самозащитой в суде. Данные справедливы для протестированных версий софта и требуют обязательной актуализации для современных архитектур.
Практический кейс: Специалист техподдержки обрабатывает претензию потребителя. Он не отправляет клиенту черновик ответа от нейросети до тех пор, пока вручную не сверит каждую ссылку на статьи закона с актуальной корпоративной базой данных, особенно если в обращении клиента содержалась провокационная фраза вроде «по закону вы обязаны…».
20. Способны ли языковые модели генерировать прорывные инновационные идеи?
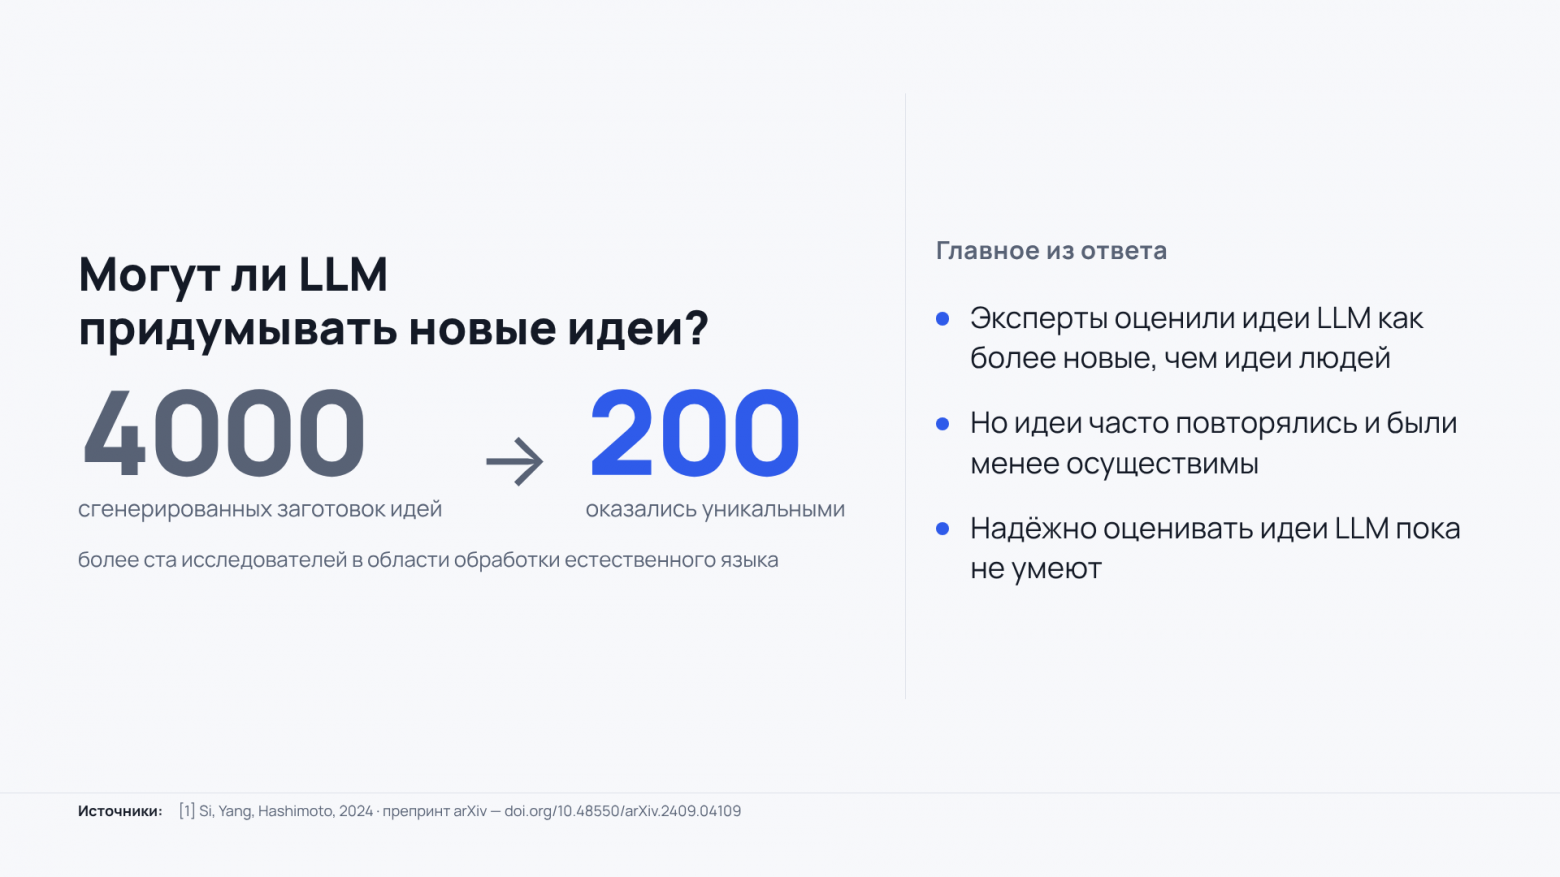
Суть в двух словах: Масштабный эксперимент показал, что эксперты оценивали идеи LLM как более новаторские по сравнению с человеческими, однако сгенерированные концепты страдали от высокой частоты дублирования и низкой практической реализуемости.
В исследовании участвовало более ста специалистов по обработке естественного языка. Из 4000 сгенерированных идей уникальными оказались лишь 200. Типичные изъяны машинного креатива: размытая архитектура реализации, некорректное использование вводных данных, оторванные от реальности допущения и слабая аргументация. Человеческие идеи тяготеют к существующему практическому контексту и ставят во главу угла реализуемость, а не абстрактную новизну. Кроме того, эксперименты подтвердили неспособность LLM адекватно оценивать качество идей: вердикт «звучит инновационно» на практике не гарантирует жизнеспособность решения.
Практический кейс: Маркетолог инициирует генерацию ста идей для рекламной кампании с помощью ИИ. Перед брейнштормом с командой он фильтрует дубли, а для оставшихся вариантов прописывает ресурсные требования «что необходимо для запуска». Оценку перспективности нейросети он не доверяет.
Что почитать
ИИ-грамотность (часть 1)
-
Bewersdorff, Nerdel, Zhai (2025). How AI literacy correlates with affective, behavioral, cognitive and contextual variables: A systematic review. Computers and Education: Artificial Intelligence.
-
Almatrafi, Johri, Lee (2024). A systematic review of AI literacy conceptualization, constructs, and implementation and assessment efforts (2019–2023). Computers and Education Open.
-
Lintner (2024). A systematic review of AI literacy scales. npj Science of Learning.
-
Feng, Carolus (2026). Artificial intelligence literacy at school: A systematic review with a focus on psychological foundations. Computers and Education: Artificial Intelligence.
-
Acosta-Enriquez et al. (2024). Exploring attitudes toward ChatGPT among college students: An empirical analysis of cognitive, affective, and behavioral components using path analysis. Computers and Education: Artificial Intelligence.
-
Shi, Liu, Hu (2025). Exploring How AI Literacy and Self-Regulated Learning Relate to Student Writing Performance and Well-Being in Generative AI-Supported Higher Education. Behavioral Sciences.
-
Coelho et al. (2025). Beyond Fear and Feelings Toward Technological Singularity: Understanding Psychological Factors Shaping Attitudes Toward AI. Trends in Psychology.
-
Yin, Ren, Zhang (2025). Mediating and moderating roles of AI literacy: How it shapes the impacts of psychological resilience on work stress and job burnout among young university teachers in China. Computers and Education: Artificial Intelligence.
-
Zhang et al. (2025). The Impact of AI Usage on Innovation Behavior at Work: The Moderating Role of Openness and Job Complexity. Behavioral Sciences.
-
Han et al. (2025). Trust the Machine or Trust Yourself: How AI Usage Reshapes Employee Self-Efficacy and Willingness to Take Risks. Behavioral Sciences.
Принятие ИИ (часть 2)
-
Lai, Cheung, Chan (2023). Exploring the role of intrinsic motivation in ChatGPT adoption to support active learning: An extension of the technology acceptance model. Computers and Education: Artificial Intelligence.
-
Wang et al. (2024). Factors Influencing University Students’ Behavioral Intention to Use Generative Artificial Intelligence: Integrating the Theory of Planned Behavior and AI Literacy. International Journal of Human–Computer Interaction.
-
Ibrahim et al. (2025). The technology acceptance model and adopter type analysis in the context of artificial intelligence. Frontiers in Artificial Intelligence.
-
Strzelecki, ElArabawy (2024). Investigation of the moderation effect of gender and study level on the acceptance and use of generative AI by higher education students: Comparative evidence from Poland and Egypt. British Journal of Educational Technology.
-
Sohn, Kwon (2020). Technology acceptance theories and factors influencing artificial Intelligence-based intelligent products. Telematics and Informatics.
Неявное знание (часть 3)
-
Zuin et al. (2025). Leveraging Large Language Models for Tacit Knowledge Discovery in Organizational Contexts. IJCNN 2025.
-
Uchihira (2026). Tacit Knowledge Management with Generative AI: Proposal of the GenAI SECI Model. AHFE International.
-
Kernan Freire et al. (2023). Tacit Knowledge Elicitation for Shop-floor Workers with an Intelligent Assistant. CHI EA 2023.
-
Al-Alawi, Al-Ahmed (2025). Integration of AI in Capturing Tacit Knowledge of Employees Leading to Innovation in Organizational Learning: A Literature Review. ITIKD 2025.
LLM в профессиональных областях (часть 4)
-
Hao et al. (2025). Large language model integrations in cancer decision-making: a systematic review and meta-analysis. npj Digital Medicine.
-
Kasagga et al. (2025). Performance of ChatGPT and Large Language Models on Medical Licensing Exams Worldwide: A Systematic Review and Network Meta-Analysis With Meta-Regression. Cureus.
-
Shan et al. (2025). Comparing Diagnostic Accuracy of Clinical Professionals and Large Language Models: Systematic Review and Meta-Analysis. JMIR Medical Informatics.
-
Dahl, Magesh, Suzgun, Ho (2024). Large Legal Fictions: Profiling Legal Hallucinations in Large Language Models. Journal of Legal Analysis.
-
Si, Yang, Hashimoto (2024). Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers.
-
Glazer et al. (2024). FrontierMath: A Benchmark for Evaluating Advanced Mathematical Reasoning in AI.
-
Chollet et al. (2025). ARC-AGI-2: A New Challenge for Frontier AI Reasoning Systems.
Похожие статьи
 Коллективный разум и способность к самообучению у одноклеточных организмов
 Математика дейтинга: рассчитай свою ликвидность в интерактивном калькуляторе Тиндера
 Судебные зарисовки в США и Великобритании и тайна адвоката Чарли Мэнсона
 Подъемная сила крыла. Часть 2: парадокс д’Аламбера и модель Жуковского
 Без тёмной энергии: уравнения Эйнштейна объясняют структуру Вселенной
 Эффективный менеджмент знаний: подборка книг о том, как монетизировать опыт персонала
 Как пауки превращают жидкий шелк в самый прочный материал на Земле
 Анатомия кодов: как устроены штрихкод, QR и Data Matrix