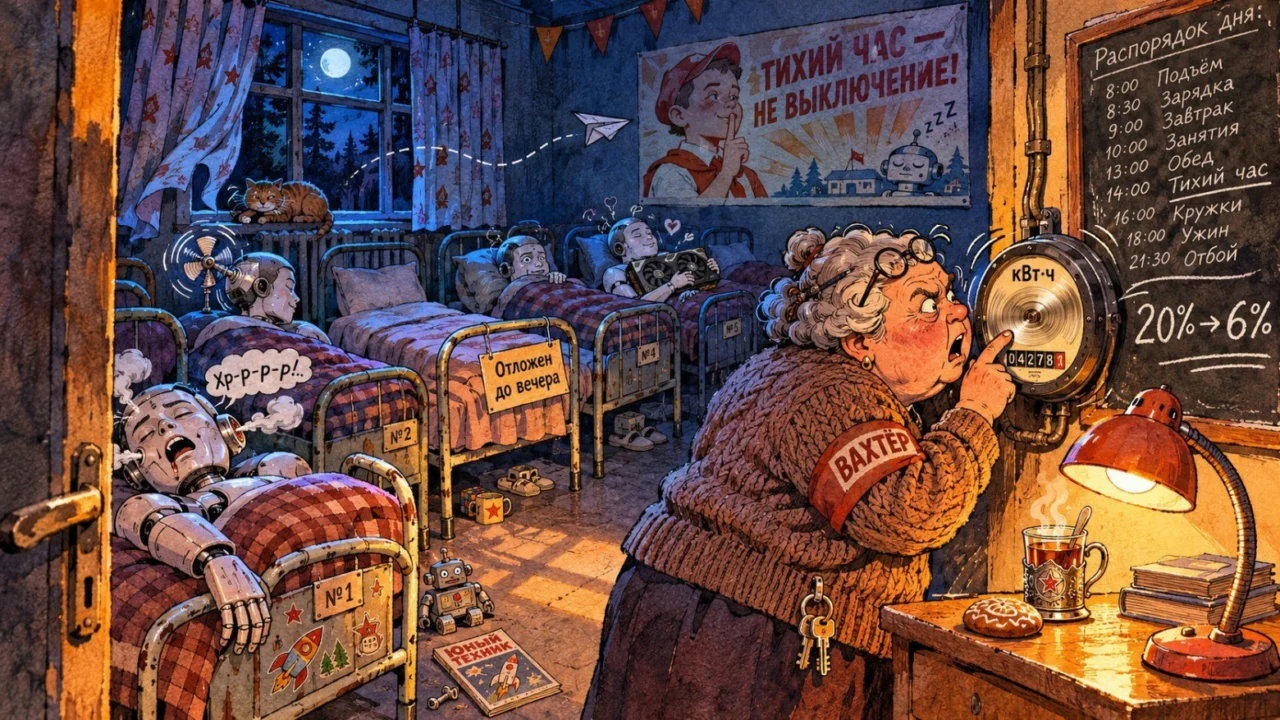
Энергозатраты ИИ-дата-центра: всё сложнее, чем в промышленности
Дата-центр для задач ИИ — крупный потребитель электроэнергии со сложной структурой нагрузки. Управлять его потреблением по примеру сталелитейного завода не получится. На производстве схема относительно проста: чтобы освободить мощность, часть оборудования останавливают, пропорционально сокращая выпуск, а затем снова запускают.
Какие механизмы использовать для ИИ-ЦОДов, пока не столь очевидно. В отличие от конвейера, вычислительная нагрузка непрерывно меняется, разные задачи по-разному используют GPU, а низкая активность вычислительных блоков вовсе не означает, что электричество не расходуется. Поэтому кажущееся логичным решение — приостановить 20% подходящих для этого задач, чтобы высвободить 20% мощности, — не работает.
Исследователи из Университета Луизианы попытались выяснить, какую мощность крупный GPU-кластер действительно может временно предоставить энергосистеме. Оказалось, что между возможностью отложить задачи и способностью гарантированно снизить потребление существует существенная разница. Гибкость дата-центра заметно меньше, чем кажется на первый взгляд, а по мере увеличения срока ограничения надежность снижения мощности падает.
Зачем энергосистеме гибкость?
По мере развития ИИ потребность в электроэнергии будет расти. Согласно прогнозам, к 2035 году мировое энергопотребление дата-центров, обслуживающих ИИ, увеличится примерно вчетверо. Основными потребителями останутся США и Китай: именно на них придется большая часть новой ИИ-инфраструктуры.
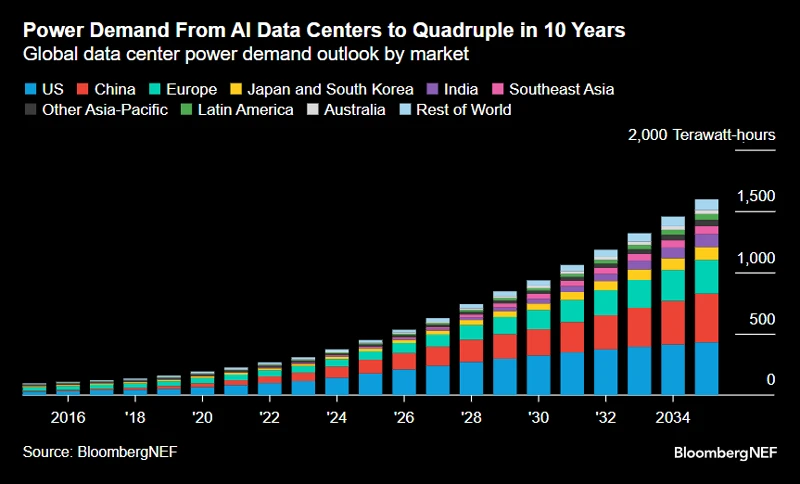
Ожидается, что к 2030 году нагрузка на национальную энергосистему США вырастет вдвое.
Обучение больших языковых моделей обходится в миллионы долларов и занимает месяцы. Однако повсеместного строительства отдельных электростанций для ИИ пока не происходит: дата-центры подключены к общей сети и конкурируют за доступную мощность с другими потребителями.
Энергокомпании перераспределяют нагрузку в зависимости от ситуации. Когда жители массово включают кондиционеры или обогреватели, городу требуется больше мощности, а вычислениям, возможно, придется подождать. В таких условиях энергосистеме полезно иметь возможность временно ограничить потребление хотя бы некоторых крупных клиентов. Иначе в критический момент может произойти блэкаут, который остановит работу всех подключенных объектов.
На крупных промышленных предприятиях подходы к перераспределению нагрузки уже отработаны. Если часть процессов допускает остановку, предприятие снижает потребление в нужный момент, а затем наверстывает упущенное. Но применима ли та же логика к дата-центрам для ИИ?
Предположим, в большом GPU-кластере выполняются низкоприоритетные вычисления. Казалось бы, при нехватке мощности их можно приостановить и передать освободившуюся энергию другим потребителям.
В работе Beyond Scalar Flexibility: From Eligible AI Workloads to Dependable Load Relief исследователи оценили, сколько мощности удастся высвободить таким способом с учетом сохранности вычислений в ЦОДе. Для этого они изучили реальные журналы работы кластера из 155 410 GPU за 185 дней. В распоряжении авторов были данные о выделенных и использованных GPU-часах, загрузке вычислительных блоков, типах и приоритетах задач и других параметрах. Прямых измерений энергопотребления объекта в этих данных не было, поэтому исследователям пришлось построить математическую модель для оценки мощности GPU, хостов и остальной инфраструктуры.
Результаты оказались весьма показательными.
Вывод 1. Мощность зависит от нагрузки нелинейно
Загрузка GPU на 50% не означает, что он потребляет половину максимальной мощности. Исследование выявило нелинейную зависимость между этими величинами, поэтому простое соотношение «50% загрузки — 50% мощности» здесь неприменимо.
GPU расходует электроэнергию и при невысокой вычислительной активности. Кроме того, потребление зависит от характера задачи. Например, при обработке онлайн-запроса к модели без обучения значительная часть работы приходится на память: вычислительная загрузка GPU может быть низкой, а энергопотребление — высоким.
Для оценки потребления всего дата-центра недостаточно учитывать только GPU. По данным исследования, на них приходится около 67% энергозатрат ИТ-инфраструктуры, еще примерно 31% — на хосты и связанные компоненты. Если добавить охлаждение и другую вспомогательную инфраструктуру, общая мощность объекта окажется еще выше.
Расчеты дали следующие значения:
-
29,37 МВт — GPU;
-
43,60 МВт — ИТ-инфраструктура;
-
52,32 МВт — весь объект с учетом охлаждения и других сопутствующих затрат.
Таким образом, даже зная загрузку GPU и тип выполняемой задачи, нельзя точно судить об энергопотреблении дата-центра в целом.
Вывод 2. Усреднение мощности может приводить к значительной ошибке
Это следует из предыдущего наблюдения: при нелинейной зависимости мощности от загрузки GPU неосторожное усреднение способно существенно исказить результат.
Представим, что GPU работает с полной загрузкой половину времени. Считать это эквивалентом постоянной загрузки на 50% и использовать такое значение в дальнейших расчетах нельзя.
Количество кВт·ч, израсходованных при полной загрузке в течение половины времени, отличается от расхода при постоянной половинной загрузке. Среднее значение функции не равно значению функции от среднего аргумента. В стрессовом сценарии этого исследования, где высокая и низкая загрузка чередовались, оценка средней мощности оказалась завышена на 22–25%.
Важно уточнить: это не значит, что любой GPU всегда потребляет на 22–25% меньше, чем показывает модель с усреднением. Стрессовый сценарий был создан специально, чтобы продемонстрировать последствия такого подхода.
В реальном дата-центре ситуация сложнее: одновременно выполняются разные задачи, и у каждой своя зависимость мощности от загрузки.
Вывод 3. Приостановка 20% задач не освобождает 20% мощности
Теперь перейдем непосредственно к вопросу гибкости.
Предположим, что 20% задач в ИИ-дата-центре не относятся к критически важным и их можно отложить, когда энергосистеме необходимо снизить нагрузку. Однако это не означает, что она получит соответствующие 20% мощности.
Причина прежняя: остановка вычислений не выключает оборудование. GPU продолжает работать и сохраняет базовое потребление. Следовательно, в таком случае сокращается только активная составляющая мощности.
Авторы исследования относят 20,39% мощности рабочей нагрузки к потенциально гибкому слою — задачам, которые допускают приостановку. Но если после их прерывания GPU физически не отключаются, экономия составит лишь 6,35% медианной мощности всего объекта.
В таких расчетах необходимо различать:
-
долю задач определенного типа;
-
долю потребляемой ими мощности;
-
мощность, которую потенциально можно отключить;
-
фактическое снижение нагрузки всего объекта.
Это четыре разных показателя, и их значения существенно различаются.
Вывод 4. Снижение мощности трудно поддерживать длительное время
Допустим, нагрузку все же удалось сократить. Как долго дата-центр сможет оставаться в таком режиме? Энергосистеме ограничение может понадобиться на четыре часа или даже на сутки.
Исследователи обнаружили: чем продолжительнее период ограничения, тем меньшую мощность удается надежно высвободить.
Состав вычислительной нагрузки непрерывно меняется. Одни низкоприоритетные задачи завершаются, другие запускаются, а распределение работы между кластерами пересматривается. Задачи, которые можно прервать сейчас, через несколько часов могут уже не выполняться.
В вычислительном эксперименте для первого часа исследователи оценили доступную энергосистеме мощность в 2,51 МВт, а для 24-го часа — лишь в 1,95 МВт. При этом рассчитывалась мощность, которую можно предоставить с вероятностью 95% в течение заданного периода. Для энергосистемы это означает риск: обещание предоставить 2,51 МВт на 24 часа на основании средней оценки привело бы к переоценке гибкости примерно на 47%.
Вывод 5. Объединение кластеров повышает стабильность, но не так сильно, как хотелось бы
Возникает еще одна логичная идея: если нагрузка одного кластера нестабильна, можно объединить несколько. При независимых нагрузках случайные колебания частично компенсировали бы друг друга. Один кластер загружен сильнее, другой слабее — в результате совокупная нагрузка стабильнее, что выгодно энергосистеме.
Такой подход полностью сработал бы при независимости нагрузок. На практике они могут реагировать на общие события и процессы, например на решения планировщика. Поэтому часть изменений происходит синхронно, и эффект от объединения уменьшается.
Для оценки надежности авторы используют показатель доступности — вероятность того, что кластер сможет обеспечить заявленное снижение мощности. Так, значение 0,656 означает, что нужный уровень достигается в 65,6% наблюдаемых случаев. При этом сами значения мощности рассчитываются для уровня доступности 95%.
Объединение действительно помогает: чем больше кластеров в группе, тем стабильнее суммарная доступная мощность. Для одного кластера показатель доступности составляет 0,378, а для 13 кластеров — уже 0,656. Тем не менее до идеального сценария далеко: при полной независимости кластеров модель дала бы значение 0,729.
Вывод 6. Прерывание и перезапуск задач тоже требуют ресурсов
Предположим, часть задач удалось остановить и снизить энергопотребление на необходимый срок. Энергосистема справилась с нагрузкой, но работа дата-центра на этом не заканчивается: отложенные вычисления придется выполнить позже.
Исследование показало, что после восстановления доступной мощности суммарное энергопотребление может возрасти. Причина — затраты на перезапуск задач и повторное выполнение части вычислений. Авторы предложили довольно условный метод оценки дополнительных расходов, поэтому конкретная цифра, на мой взгляд, вряд ли полезна на практике. Гораздо важнее общий вывод: управление мощностью и экономия энергии — не одно и то же.
Исследование не предлагает простого ответа на вопрос, какую мощность ИИ-дата-центр способен временно высвободить для энергосистемы. Вместо этого оно раскрывает сложную картину: гибкость зависит от характера нагрузки, продолжительности ограничения, требуемой надежности и способа организации вычислений. Тем, кто хочет разобраться глубже, в статье доступны подробные формулы.
Практический вывод, пожалуй, важнее отдельных численных оценок: при управлении ИИ-дата-центрами опасно опираться на упрощенные предположения. Они могут приводить к существенным ошибкам, а привычные методы управления промышленной нагрузкой нельзя напрямую перенести на вычислительную инфраструктуру.
Подход «приостановим часть задач и освободим соответствующую долю мощности» не работает. Потребуются более точные способы управления нагрузкой, учитывающие текущие задачи GPU, допустимое время их отсрочки и мощность, которую действительно удастся высвободить.
Похожие статьи
 Microsoft поручила Intel упаковку своих процессоров для Azure
 Windows 11 можно не взламывать: оставленная Microsoft лазейка позволяет обойти экран блокировки
 Представлен первый смартфон Huawei с упором на ИИ — OSTA O1 Pro: широкий экран 6,39 дюйма, камера 200 Мп, аккумулятор на 7000 мА·ч и Kirin 9030S
 В России введут предупреждения о звонках из-за границы
 Из канала в истории: Max запустил новый способ делиться публикациями
 Google доверила Blue Origin запуск спутников с ИИ-процессорами в космос
 Samsung Galaxy S27 Pro впервые появился в Geekbench: 12 ГБ памяти и Exynos 2700 вместо Qualcomm
 Почему серверы так шумят?