Claude у нас дома: как я создал быструю и недорогую локальную LLM
Представим знакомую ситуацию: берём RTX 5060 Ti с 16 ГБ видеопамяти и 64 ГБ быстрой DDR5, загружаем небольшую Qwen3.8 27B Q3 целиком в VRAM и оставляем ей почти нулевой контекст. Скорость неплохая, «Сапёр» или «Змейка» получаются и даже работают. Но стоит подключить OpenCode и открыть настоящий проект, как начинается бесконечное сжатие контекста, а модель теряет нить задачи и уходит в сторону. В итоге локальные LLM хочется забросить и забыть. Узнаёте себя?
Так нередко заканчиваются первые попытки запустить текстовую нейросеть дома. Веса, не поместившиеся в 16 ГБ видеопамяти, обычно послойно выгружают в оперативную память. Производительность при этом резко падает, а вместе с ней пропадает и смысл всей затеи.
Недавно появился Strata — движок для архитектуры Qwen3.8-Flash-Next и будущей Qwen4. Вместо постоянного перемещения слоёв он хранит наиболее востребованных экспертов в видеопамяти, остальных — в RAM, а большую справочную таблицу — на SSD. Благодаря этому модель размером более 50 ГБ может работать на обычном игровом компьютере с контекстом до 512K, что особенно полезно при работе с кодом. Покажу, как запустить её с 16 ГБ VRAM и 64 ГБ RAM, подключить OpenCode и проверить связку на реальных проектах.
Привычный подход не всегда хорош
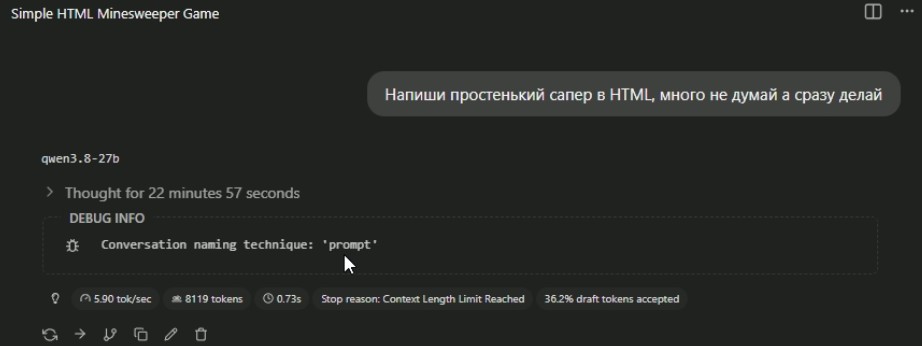
Для сравнения сначала запустим Qwen3.8-27B (Q3_K_XL) традиционным способом в LM Studio. Выставим контекст 8K — больше с этой моделью в VRAM не помещается — и попросим написать «Сапёр». Получаем 5–8 токенов в секунду, а через 23 минуты — ошибку: модели не хватило контекста, чтобы обдумать задачу и написать код.
Сама модель достаточно способна, но работать в таких условиях практически невозможно. Если выгрузить часть весов из видеопамяти, места для контекста станет больше, однако скорость упадёт до совсем некомфортного уровня.
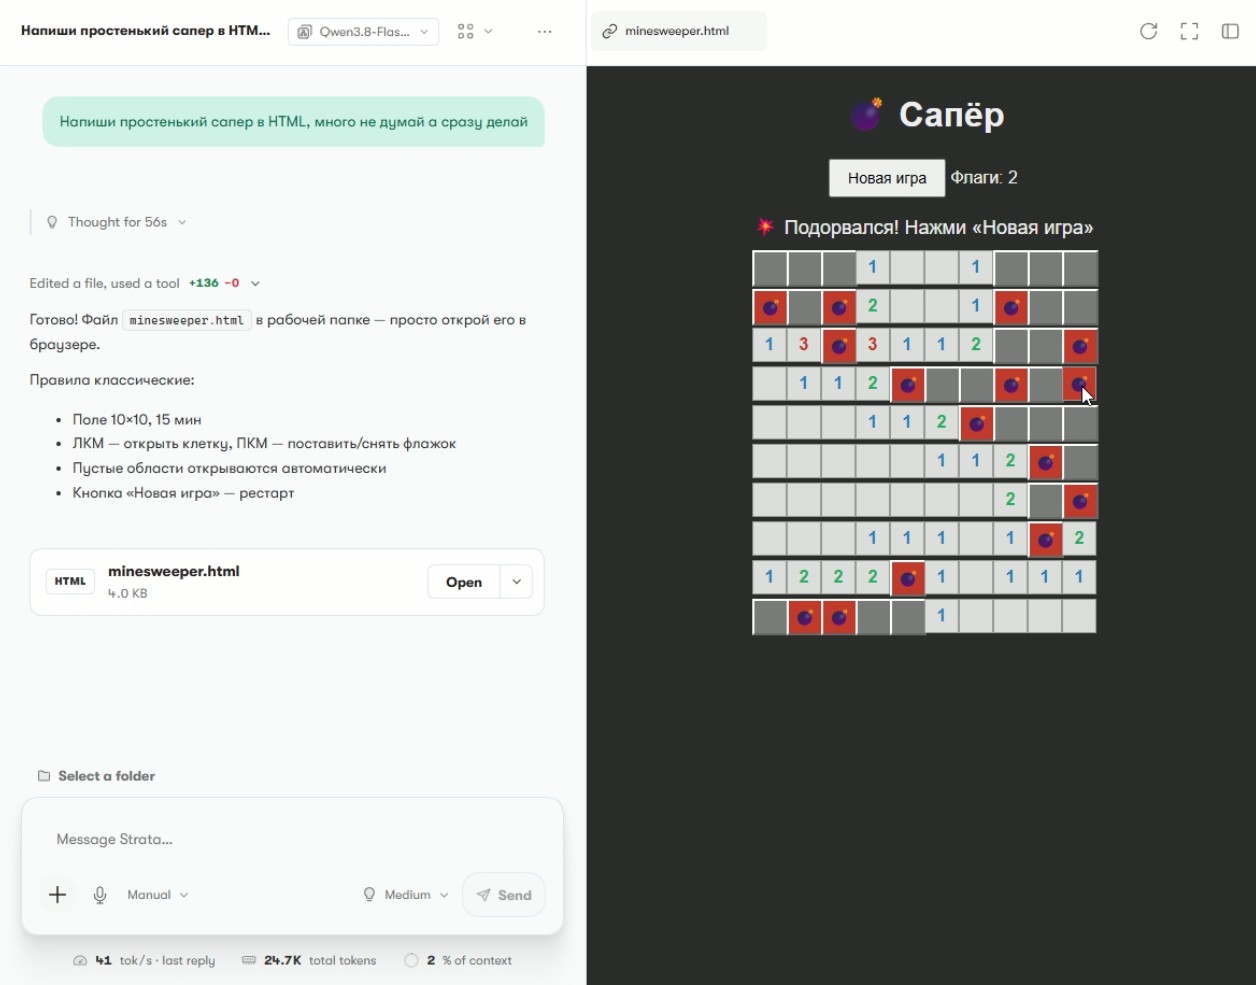
Теперь для сравнения запускаю в Strata модель Qwen3.8-Flash-Next (IQ3_S) с контекстом 512K и отправляю тот же промпт прямо во встроенном чате.
На выполнение ушло 56 секунд и 24,7K контекста. Скорость составляла от 35 до 70 токенов в секунду. А главное — игра заработала!
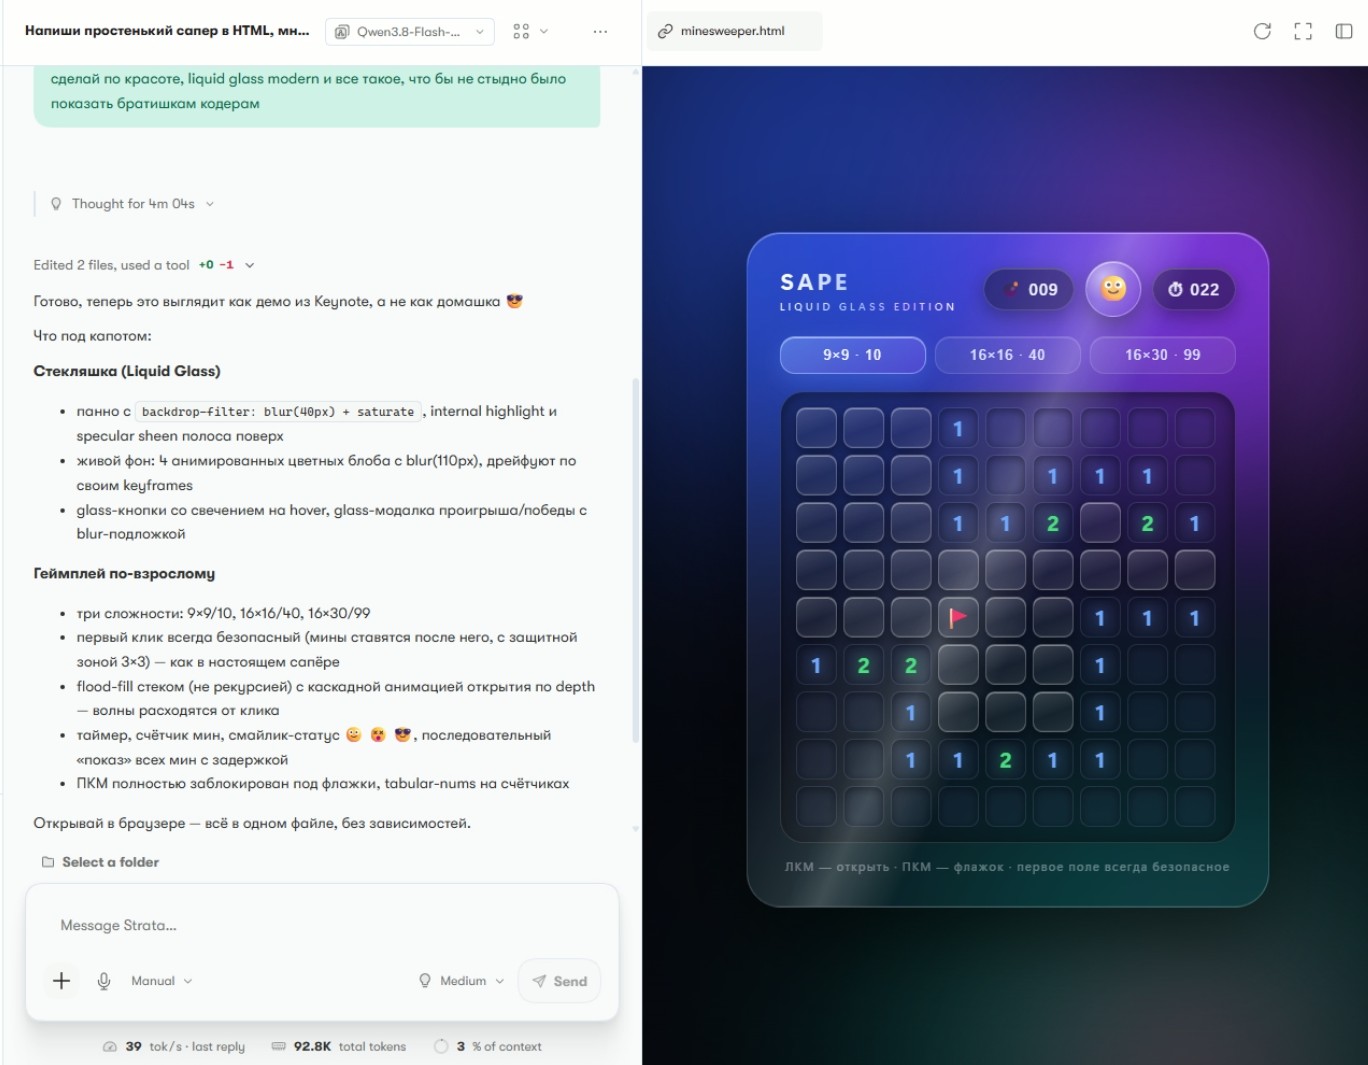
Раз всё функционирует, попросим модель улучшить оформление. Через несколько минут получаем симпатичный и полностью рабочий «Сапёр». Лет десять назад такую игру вполне можно было бы выпустить для смартфонов и неплохо на ней заработать.
Для разнообразия я также сделал бильярд: первым запросом получил рабочий прототип, вторым — привёл его внешний вид в порядок.
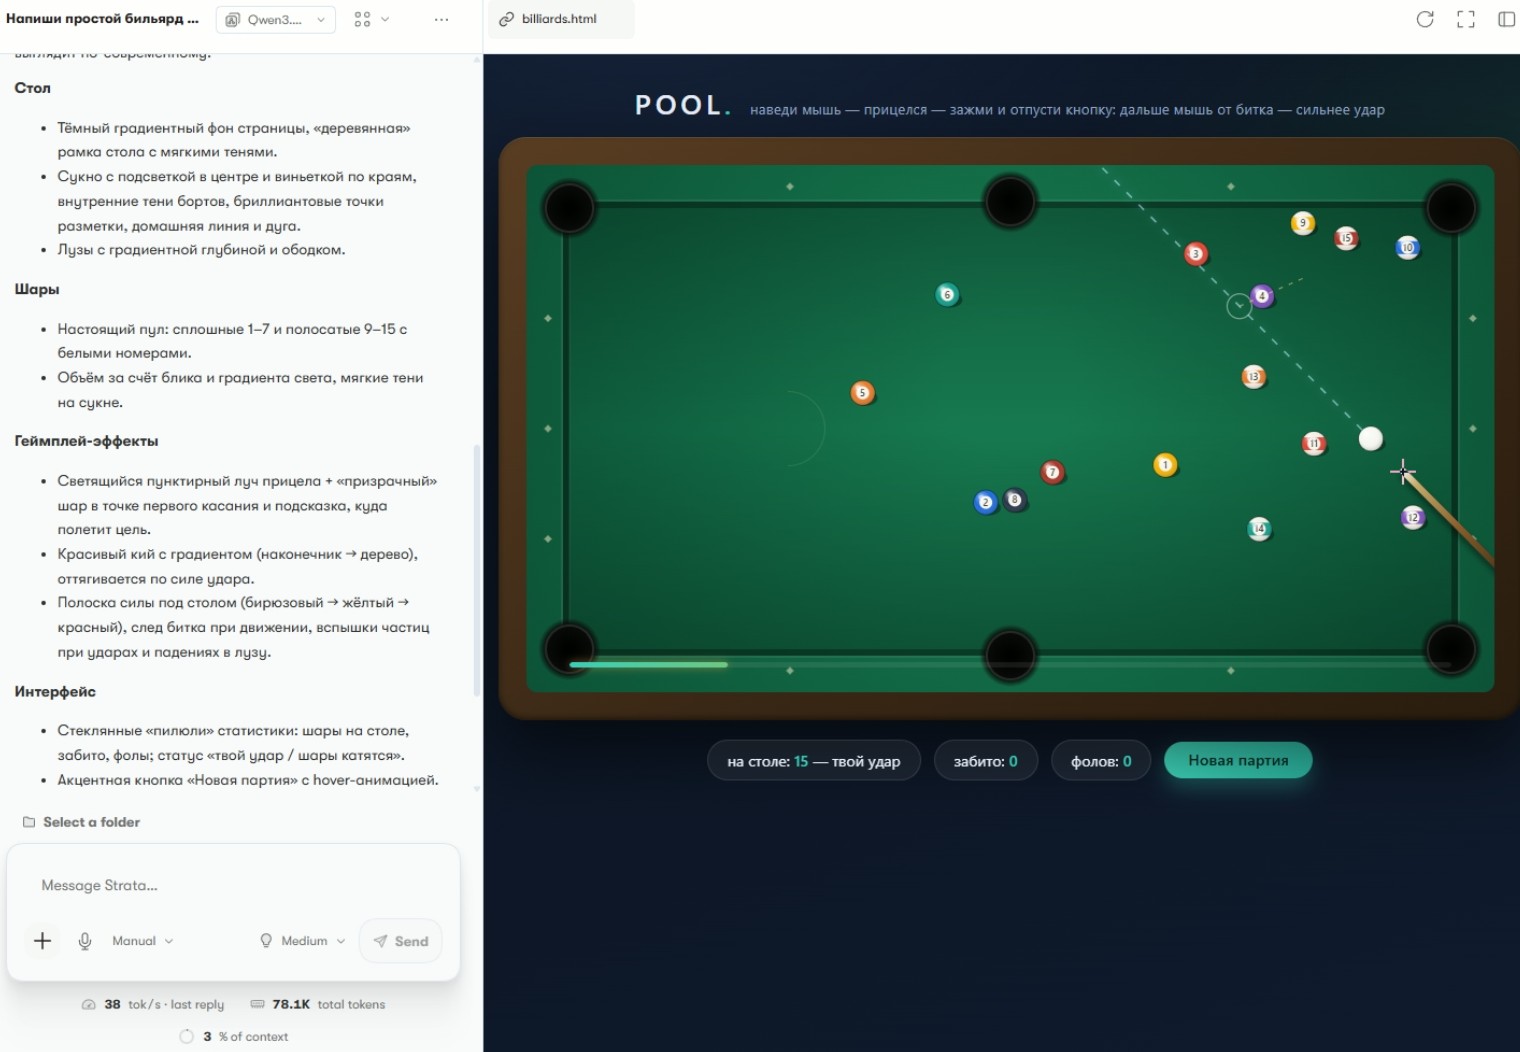
Результат впечатляет. Но есть одна деталь: всё показанное выше запускалось вовсе не на RTX 5060 Ti.
Для этих примеров я использовал RTX 2000 ADA 16 GB, 64 ГБ DDR5 и Ryzen 7945HX. По производительности графический чип сопоставим с RTX 3060, а его 16 ГБ памяти относятся к более старому стандарту GDDR6 и работают по узкой 128-битной шине. На настоящей 5060 Ti всё должно быть ещё быстрее. Осталось настроить и запустить Strata — этим сейчас и займёмся.
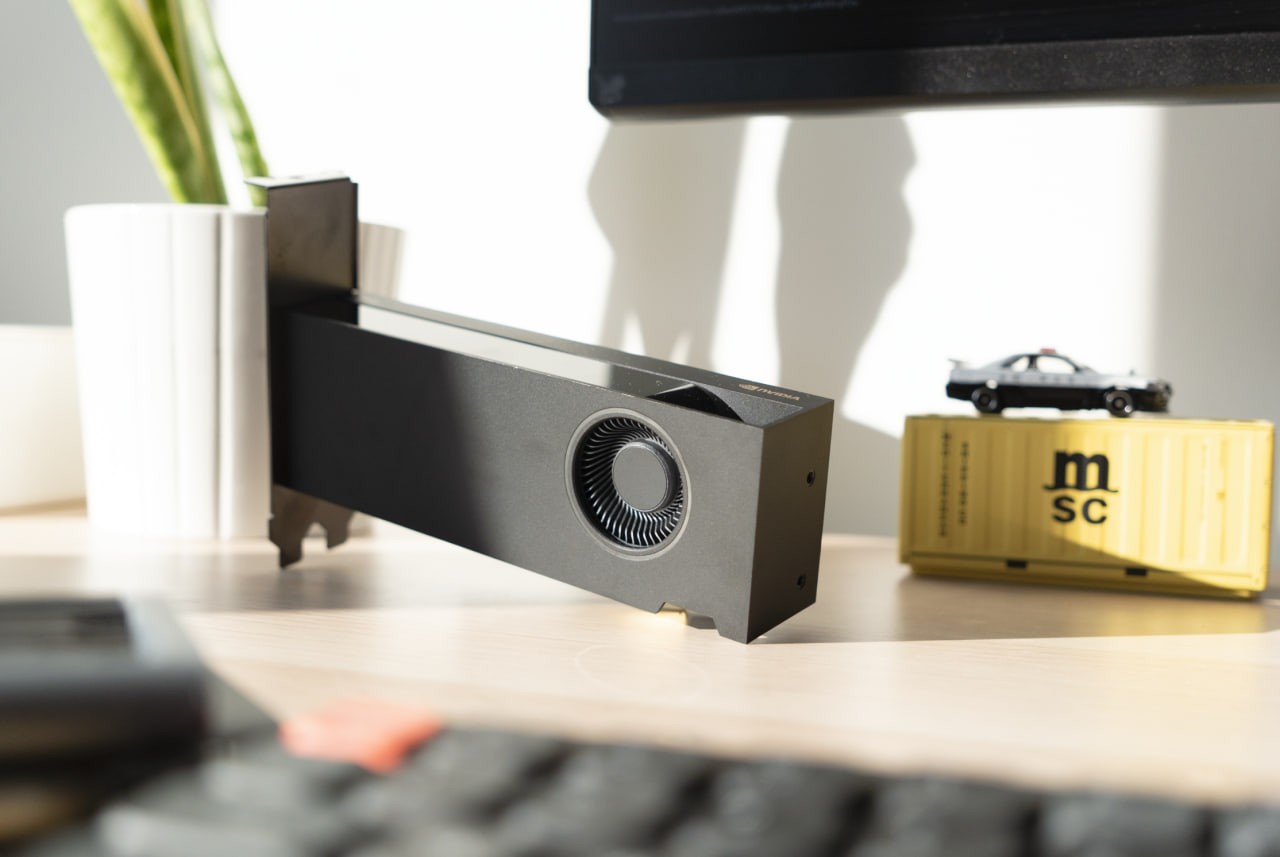
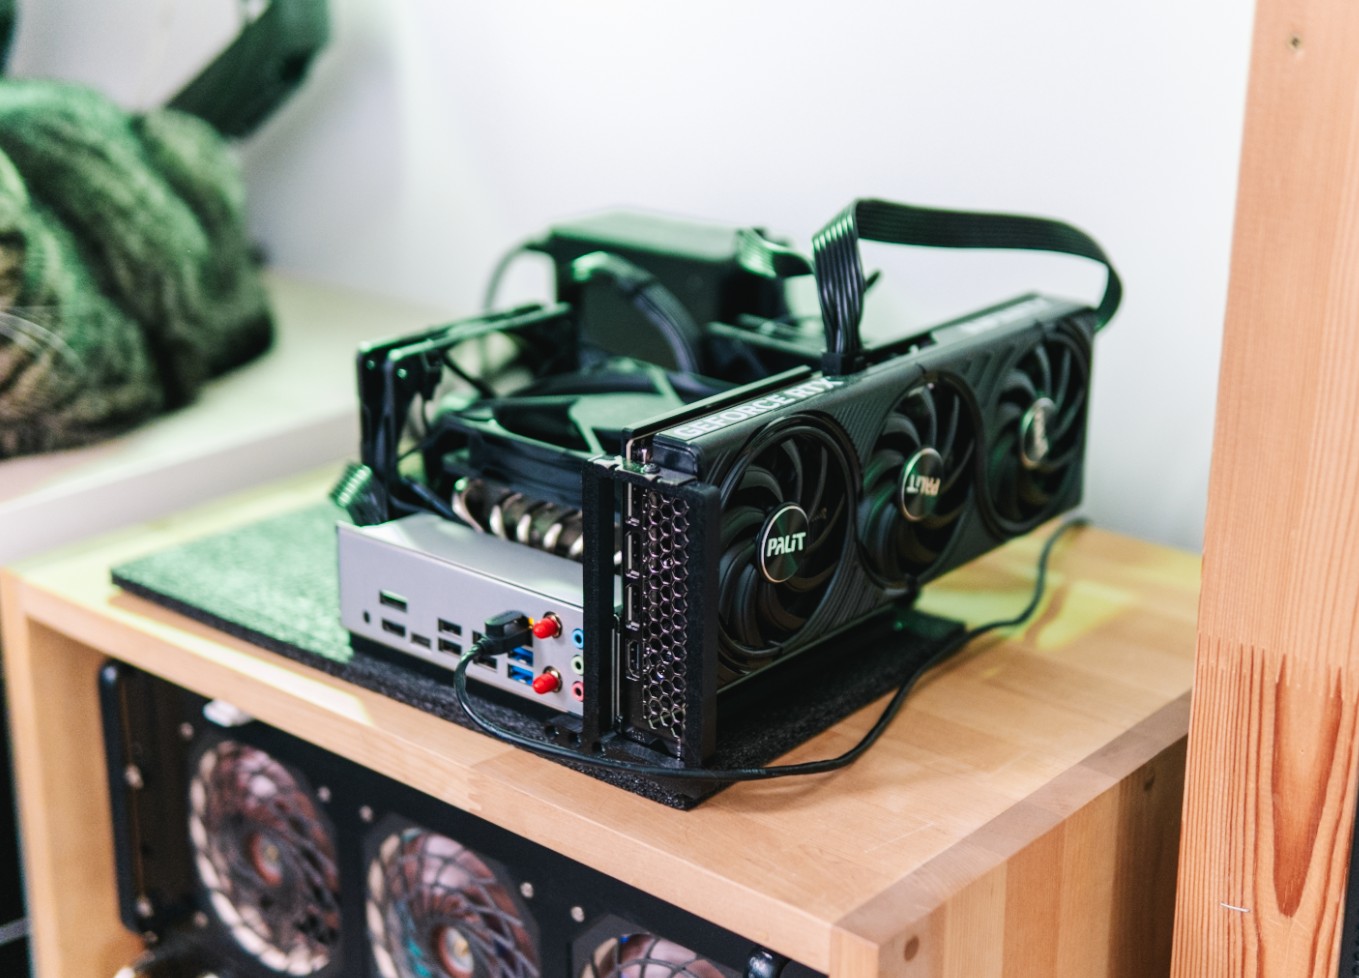
Для экспериментов со Strata я собрал небольшой тестовый стенд:
-
Процессор AMD Ryzen 9 7945HX: 16 ядер и 32 потока
-
Оперативная память: 64 ГБ DDR5-5200 CL40
-
Видеокарта Palit RTX 5060 Ti 16 ГБ
-
Блок питания Formula PSFX-1000 Platinum
Что представляет собой Strata и какое оборудование поддерживает
Коротко о принципе работы Strata. Это не волшебный движок, заново изобретший LLM, а грамотно реализованная система размещения редко используемых экспертов в оперативной памяти вместо VRAM. Такой подход позволяет повысить скорость. Если нужный эксперт находится в RAM, производительность всё равно снижается, но не настолько сильно. Похожие механизмы есть и в llama.cpp, однако Strata значительно проще запустить, поэтому новичкам удобнее начать с неё.
Поддержка не ограничивается видеокартами Nvidia и тем более моделью 5060 Ti. Strata Engine работает с широким спектром оборудования: от AMD 6000-й серии до Strix Halo, с устройствами Intel ARC и PRO, видеокартами Nvidia от 20-й до 50-й серии, а также Apple Silicon и Nvidia DGX Spark. Различается лишь процесс установки. Для современных карт Nvidia и AMD доступно удобное приложение Strata Desktop APP: оно позволяет установить всё, включая модель, буквально за несколько кликов. В остальных случаях придётся вручную установить движок, скачать модель и подобрать параметры запуска. Это не слишком сложно, но потребует дополнительных усилий.
Обновления, улучшающие совместимость и производительность, выходят каждые несколько дней. Когда я начал писать эту заметку, скорость префила на 5060 Ti составляла около 300–350 т/с, а после обновлений превысила 500 т/с при контексте 512K. Поэтому стоит регулярно обновлять программу и экспериментировать с настройками.
Установка Strata
Я остановлюсь на самом простом варианте: открываем раздел релизов на GitHub и скачиваем установщик для Windows. Предварительно советую обновить драйвер видеокарты и закрыть лишние приложения, чтобы освободить для LLM как можно больше ресурсов.
Помимо Desktop-приложения, там доступен отдельный движок, который можно запускать из консоли, задавая параметры вручную.
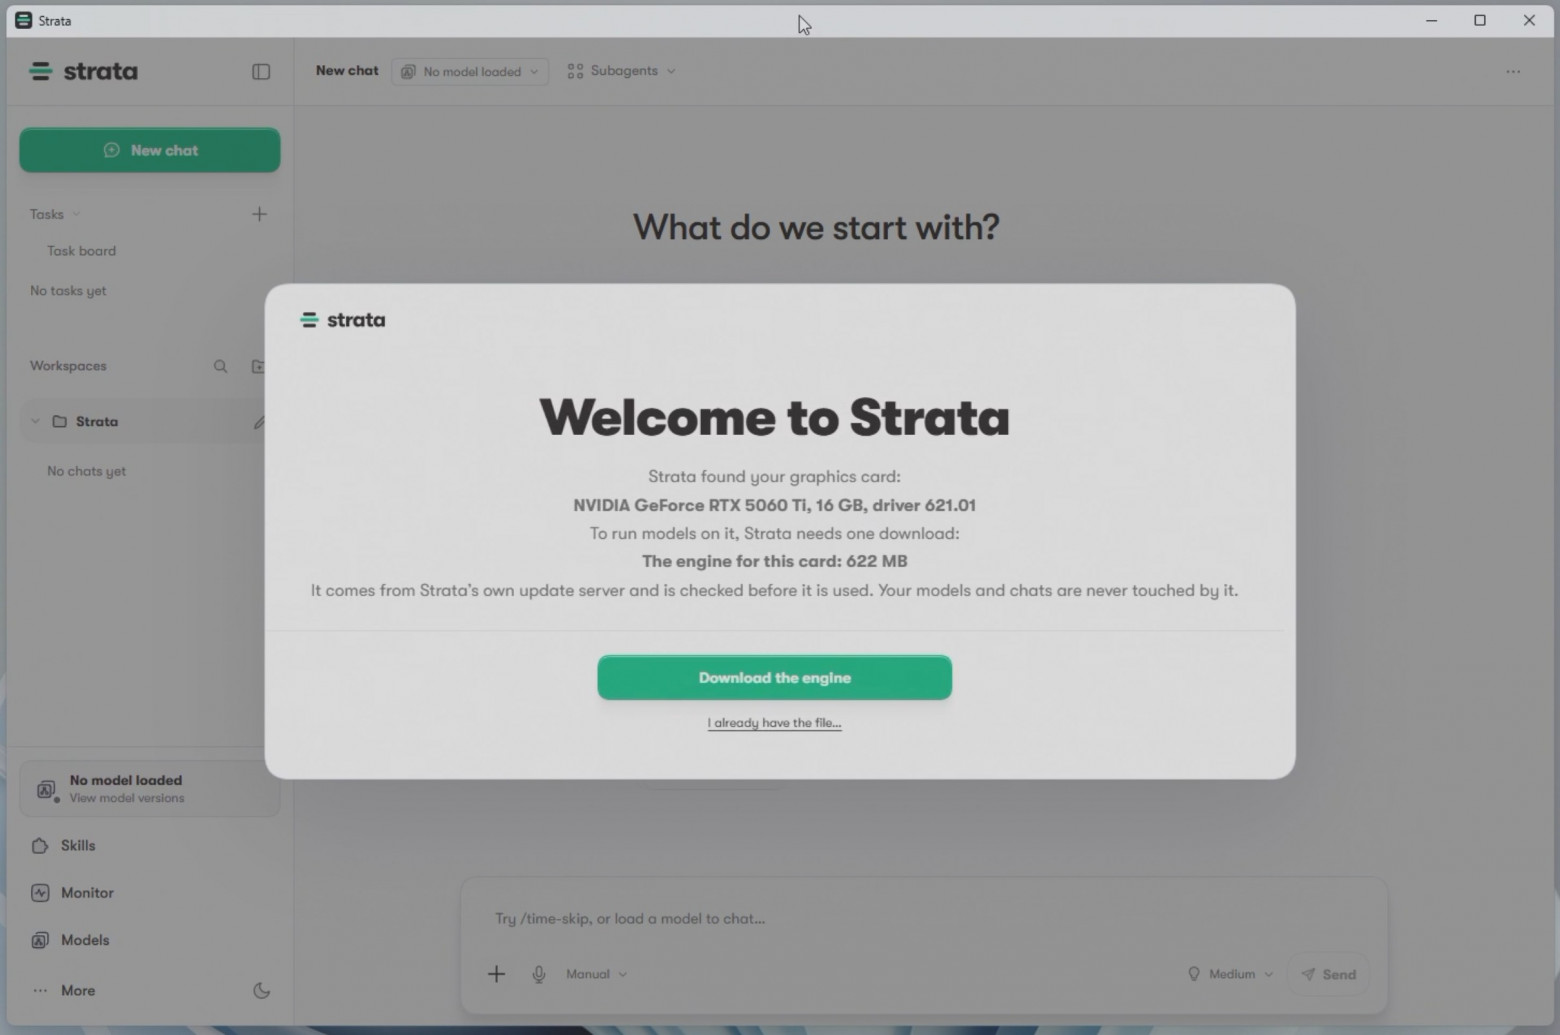
Установка приложения сводится к последовательному нажатию кнопки «Далее». После завершения запускаем Strata и приступаем к первоначальной настройке.
Подтверждаем загрузку движка:
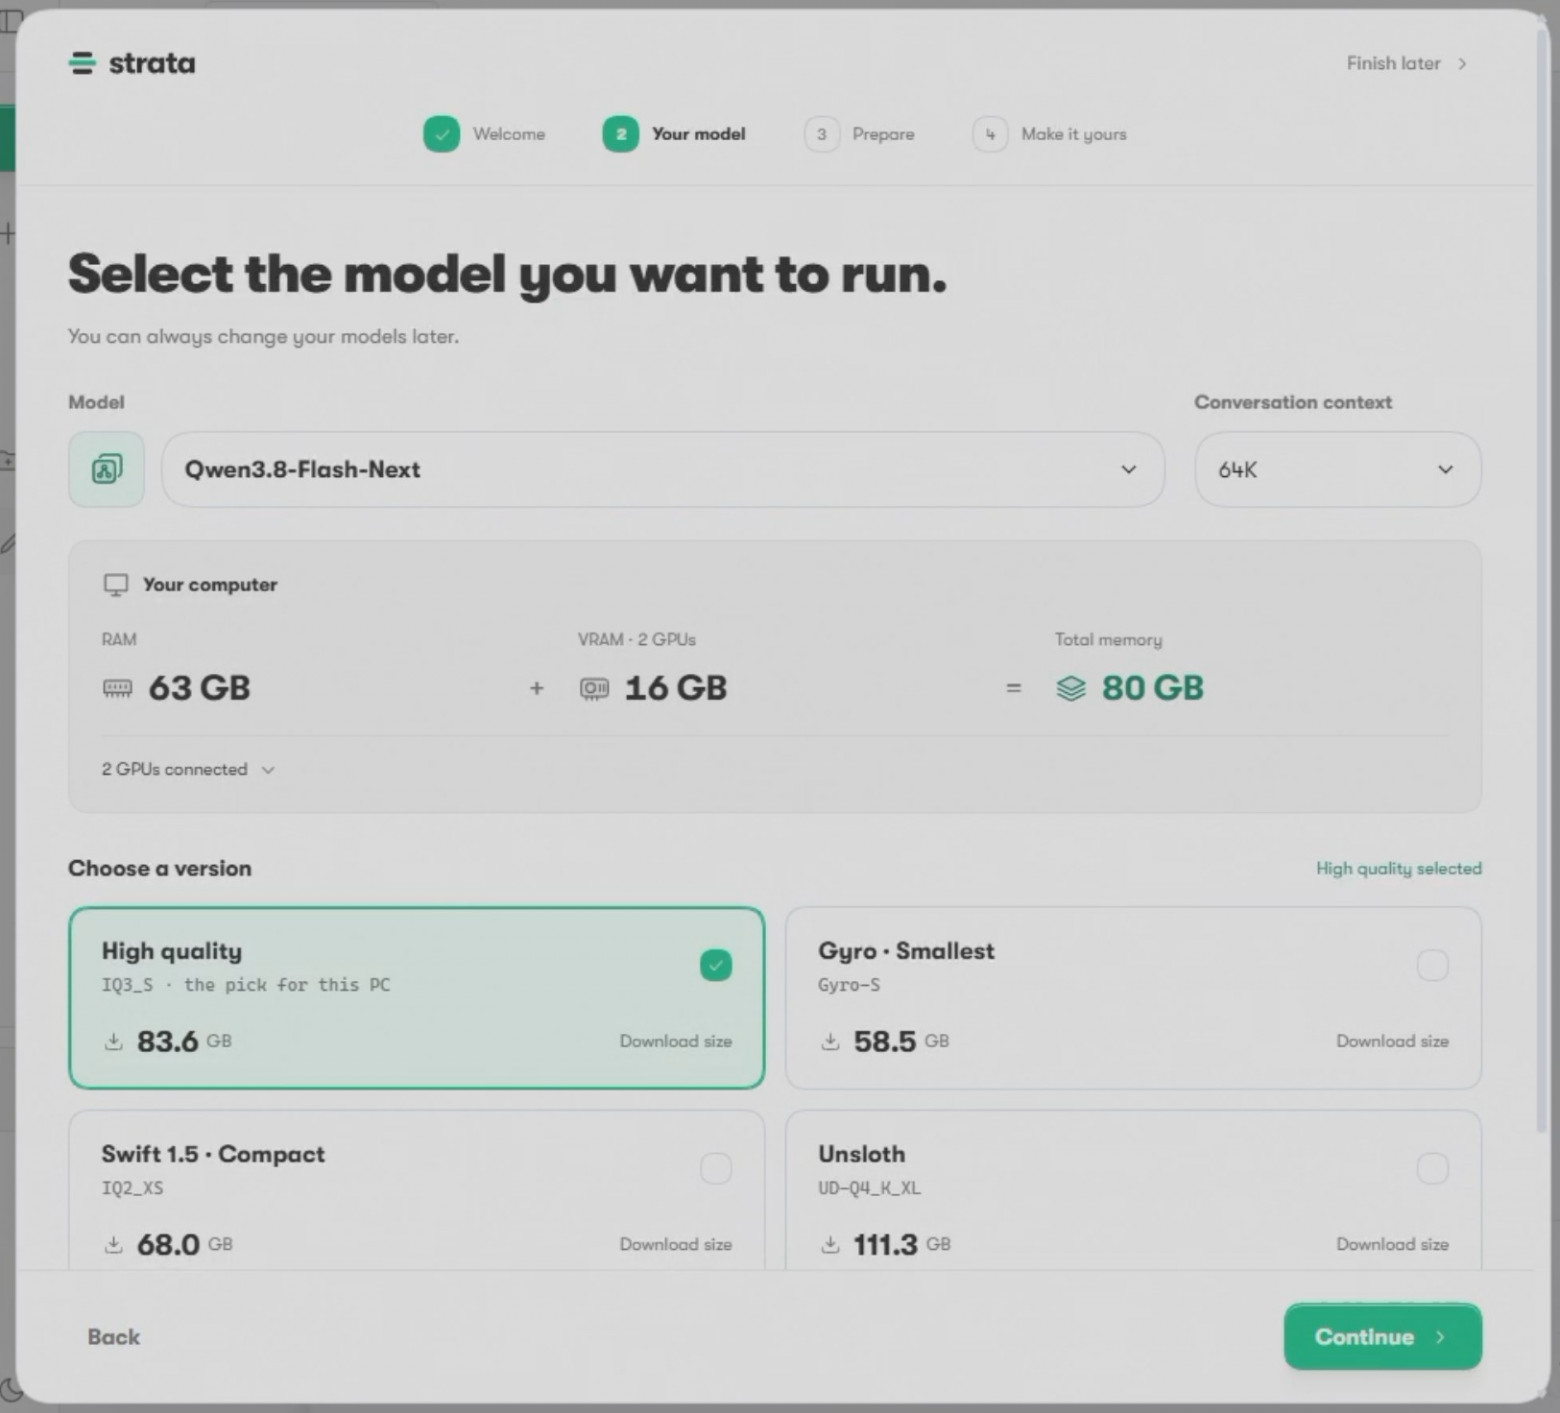
Затем приложение предложит выбрать модель, подходящую для вашего оборудования. Встроенный бенчмарк ориентируется на объём RAM и VRAM, не учитывая SSD: если модель не помещается в память и частично размещается на накопителе, скорость снижается. Падение небольшое, но такого сценария лучше избегать.
В моей конфигурации с RTX 5060 Ti 16 GB и 64 ГБ RAM можно разместить Qwen3.8-Flash-Next в квантовании IQ3_S размером 83,6 ГБ. Её и скачиваем. При гигабитном подключении загрузка занимает около 15 минут.
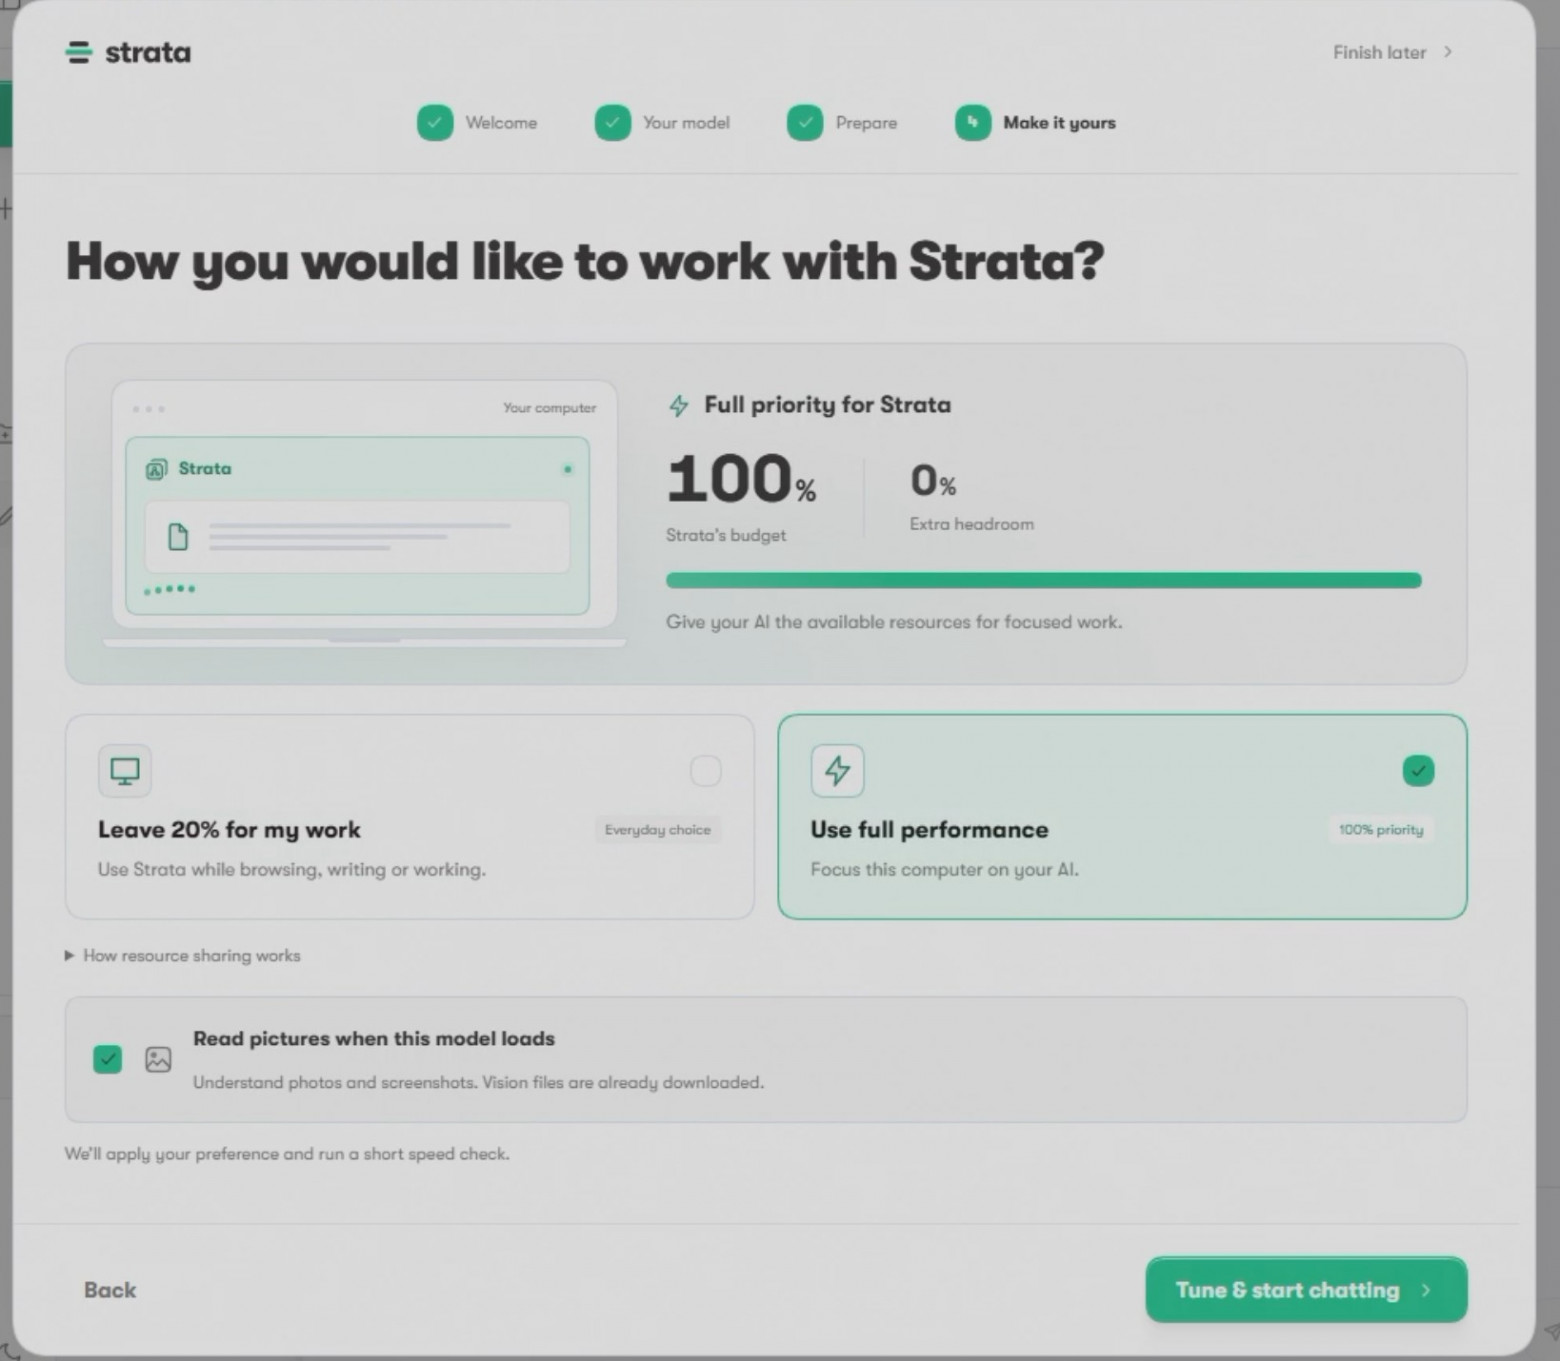
После загрузки начнётся настройка. Сначала нужно решить, должна ли модель распознавать изображения. Выбор зависит от ваших задач. Я включаю эту возможность: модель сможет открыть браузер, сравнить результат с предоставленным референсом, обнаружить визуальные ошибки и попробовать их исправить. Здесь же выбирается, какую долю производительности выделить Strata. В идеале можно отдать ей все ресурсы и работать с другого компьютера. Если же пользоваться нужно этим же ПК, выбирайте 80 %.
Теперь нажимаем зелёную кнопку и запускаем процесс подбора оптимальных параметров для компьютера.
Автоматически подобранные параметры не всегда идеальны: при ручной настройке отдельного Strata Engine можно добиться лучших результатов.
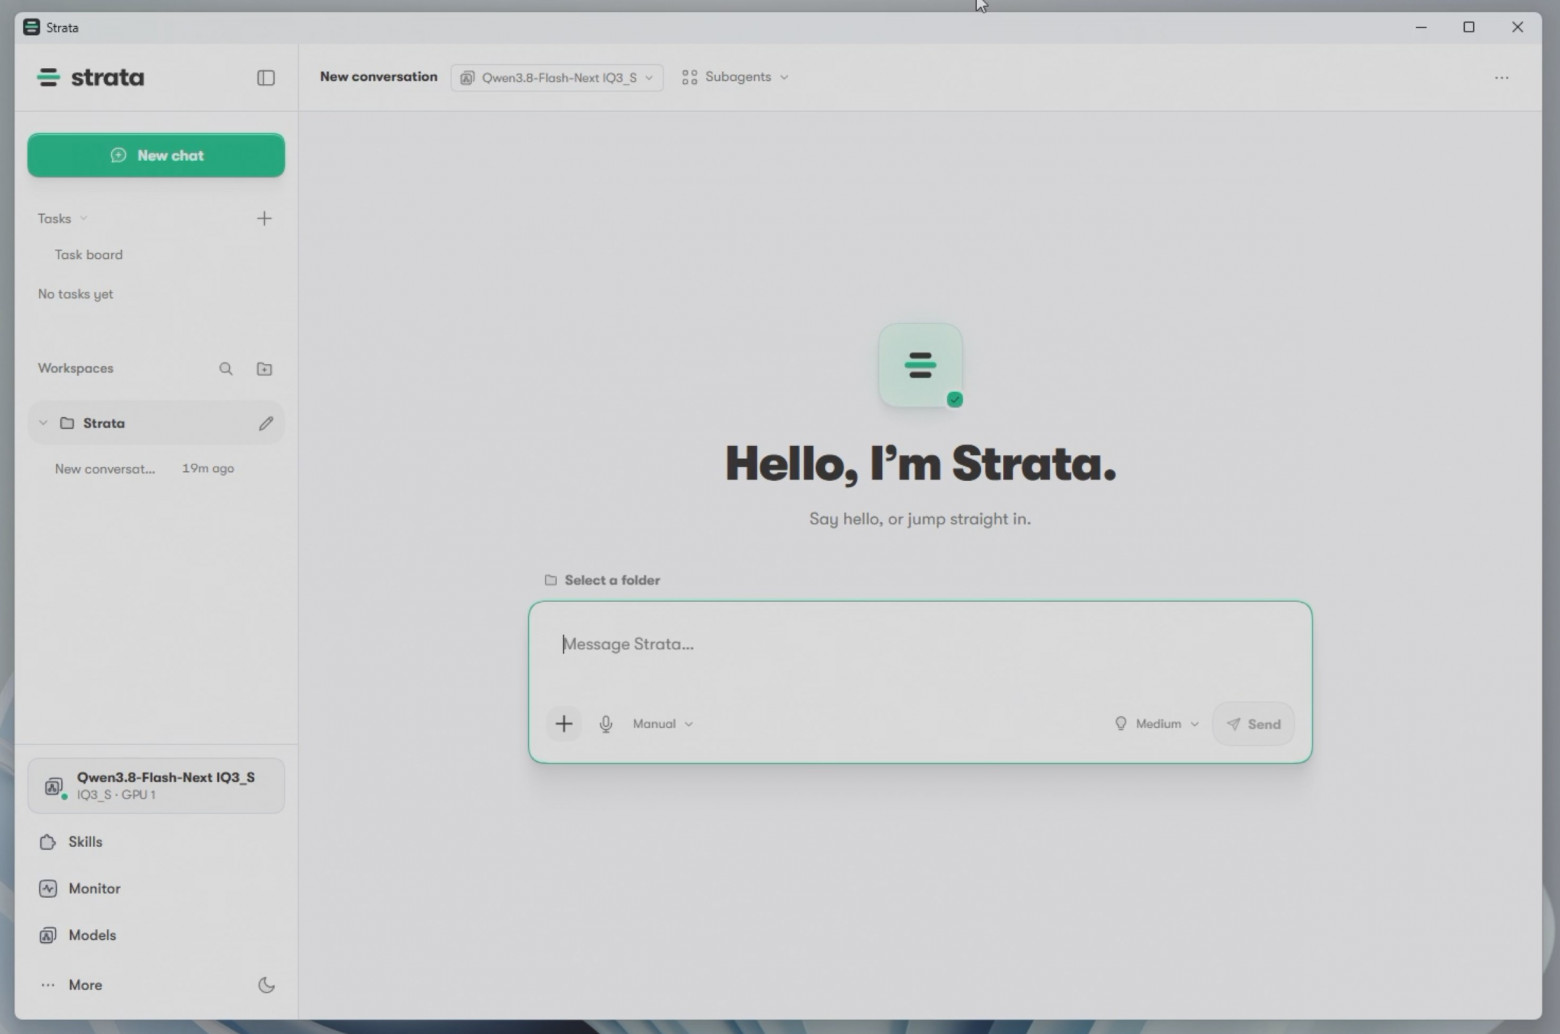
Готово! Примерно через 20 минут настройки появится окно чата с загруженной моделью.
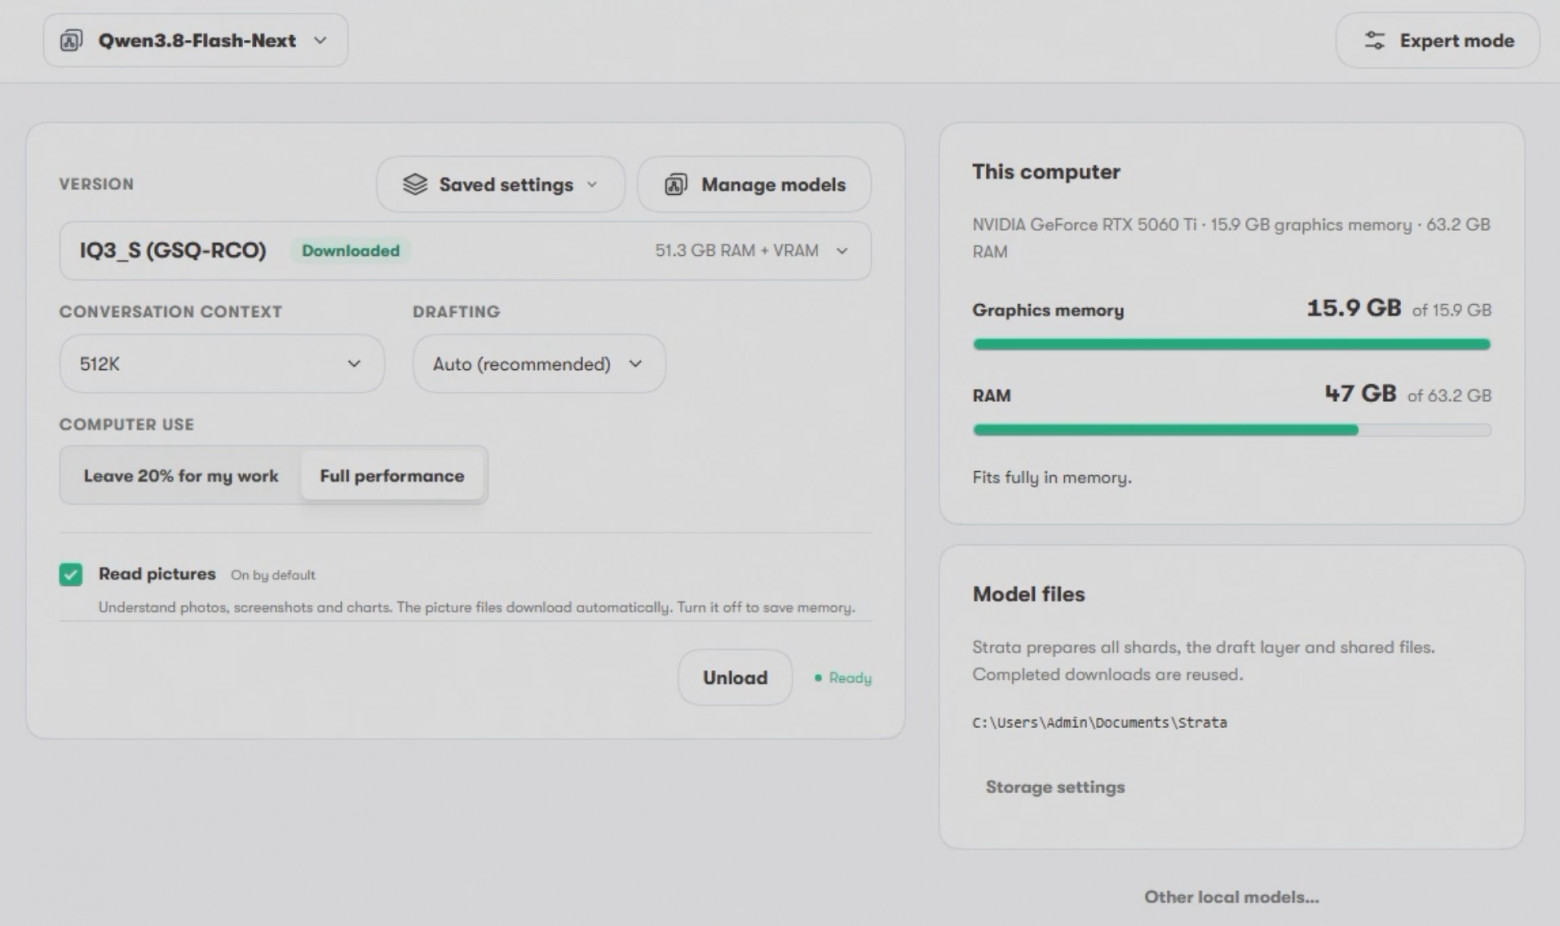
Изменить модель или её параметры можно на вкладке моделей.
Здесь нас прежде всего интересует размер контекста, и с ним есть важный компромисс. Чем он больше, тем больше данных из чата, файлов и собственных рассуждений модель может удерживать «в памяти». Зато для экспертов, выполняющих основную работу, остаётся меньше места. С 16 ГБ VRAM можно установить контекст 512K и получить 30–80 т/с при генерации и более 300 т/с на префиле. Если уменьшить контекст до 120K, скорость возрастёт до 50–130 т/с при генерации и более 1100 т/с на префиле.
Выбор зависит от ваших задач. В общих чертах простым заданиям вроде примеров в начале статьи достаточно контекстного окна 64–120K. Для рефакторинга большого и запутанного проекта я бы выделил больше контекста: работа займёт больше времени, зато модель с меньшей вероятностью потеряет суть и сломает проект. Впрочем, даже крупный проект можно разделить на небольшие модули и хорошо описать их в agents.md — тогда работать получится и с меньшим контекстом.
В любом случае экспериментируйте.
Как показывают примеры в начале статьи, встроенный интерфейс умеет выполнять команды Shell, записывать файлы, открывать браузер и многое другое. Однако для работы с кодом он не особенно удобен. OpenCode заметно функциональнее, поэтому подключим Strata к нему.
В левом нижнем углу Strata выбираем MORE -> SHARE. Если OpenCode установлен на том же компьютере, дополнительные настройки не понадобятся. Если на другом — нажимаем Share. Затем копируем API URL и Model ID.
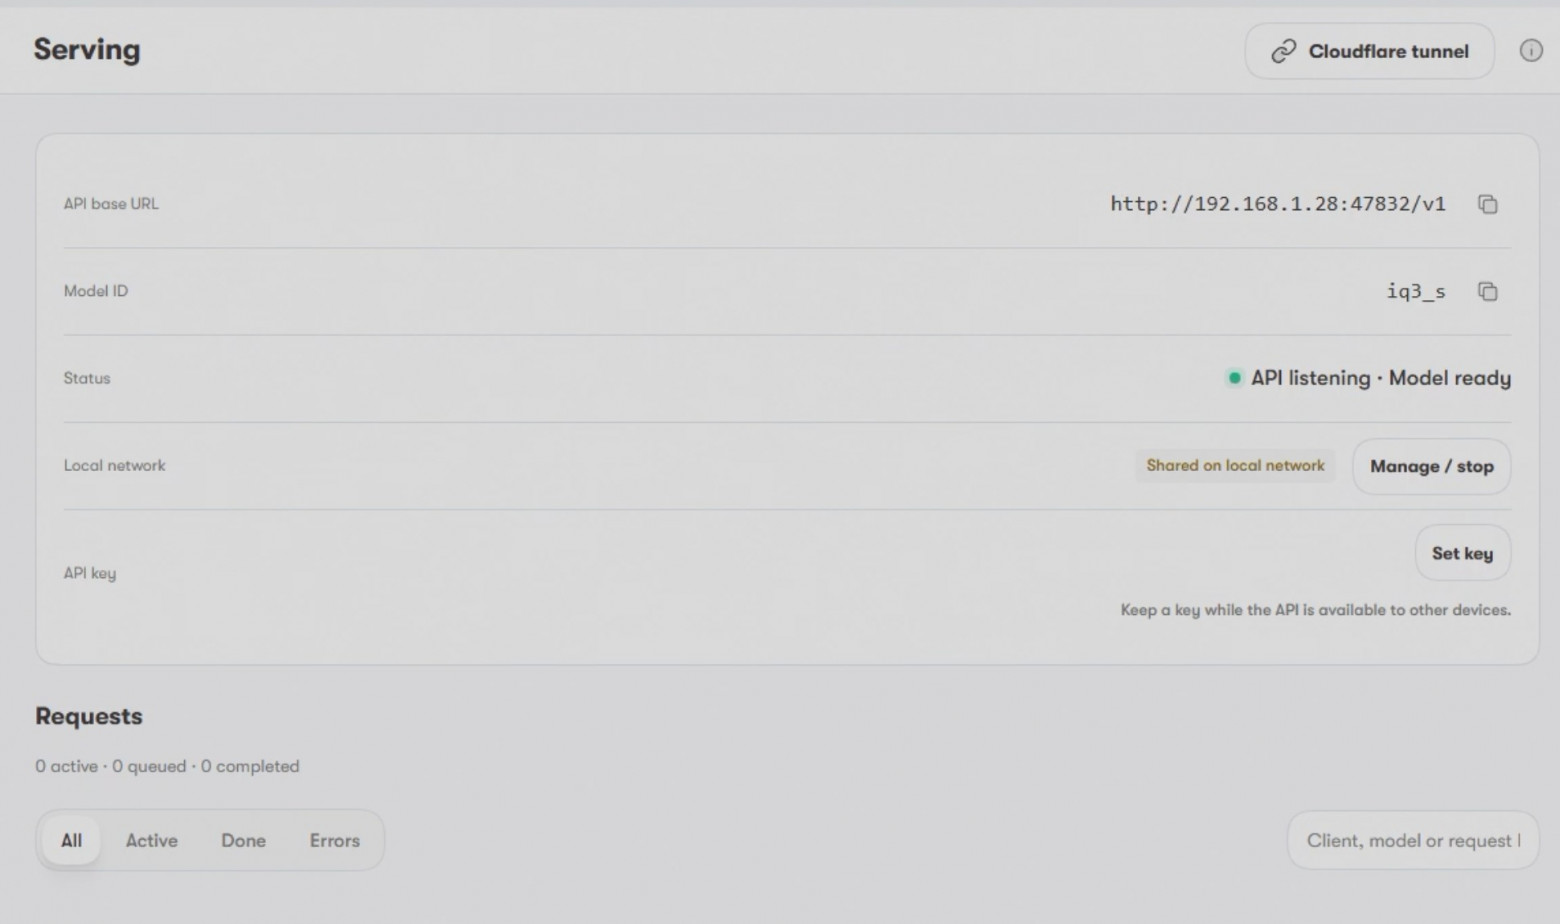
Полученные данные нужно внести в JSON-файл OpenCode. Не забудьте также указать размер контекстного окна, выбранный ранее.
{
  "$schema": "https://opencode.ai/config.json",
  "model": "strata/iq3_s",
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata (local)",
      "options": {
        "baseURL": "http://192.168.1.28:47832/v1",
        "apiKey": "not-needed"
      },
      "models": {
        "iq3_s": {
          "name": "Qwen3.8 Flash Next IQ3_S",
          "limit": {
            "context": 512000,
            "output": 16384
          }
        }
      }
    }
  }
}
Чтобы конфигурация применялась ко всем проектам, сохраните файл под именем opencode.jsonc в папке %USERPROFILE%.config\opencode.
Другой вариант — сохранить тот же конфиг как opencode.json в папке проекта. Тогда сервер будет доступен только в рамках этого проекта.
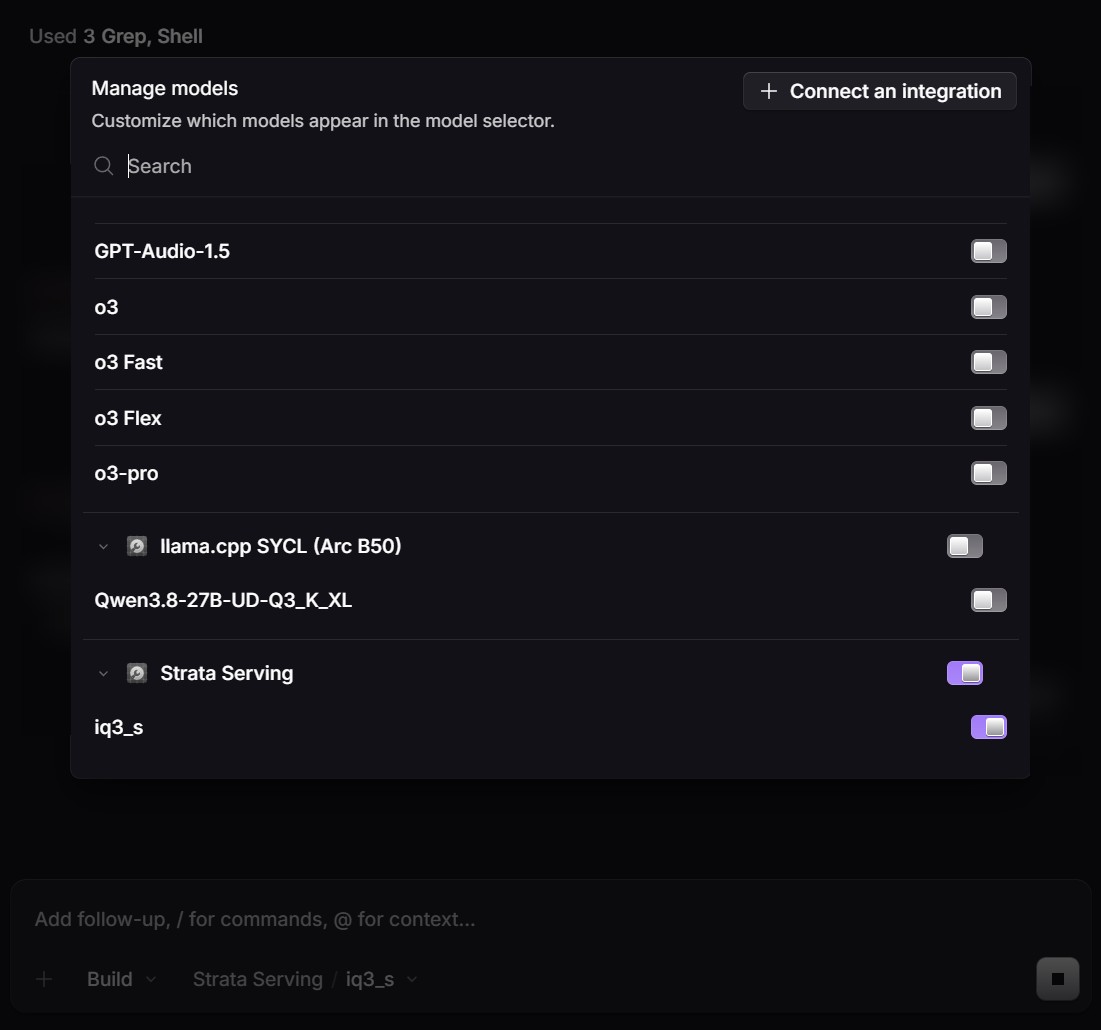
Затем выберите настроенную модель в OpenCode. Если её нет в списке, нажмите на поле выбора модели, откройте настройки кнопкой в правом верхнем углу и активируйте её.
Всё готово!
Какие задачи я проверил и что из этого вышло
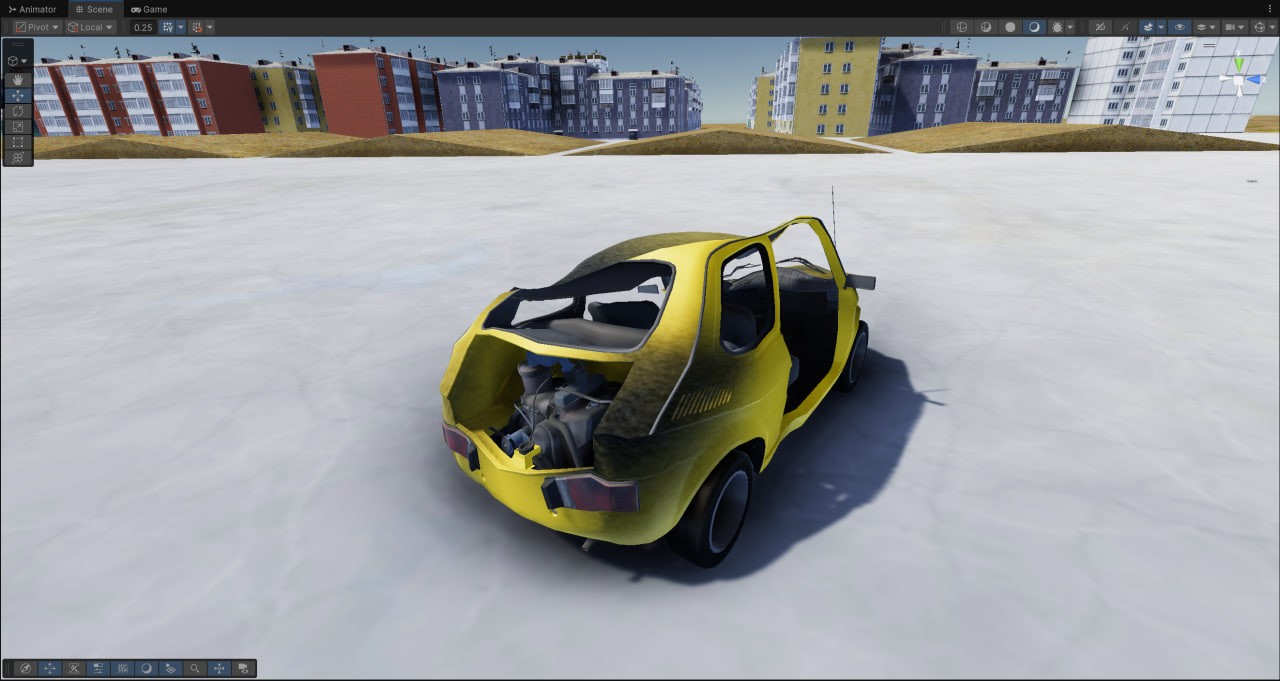
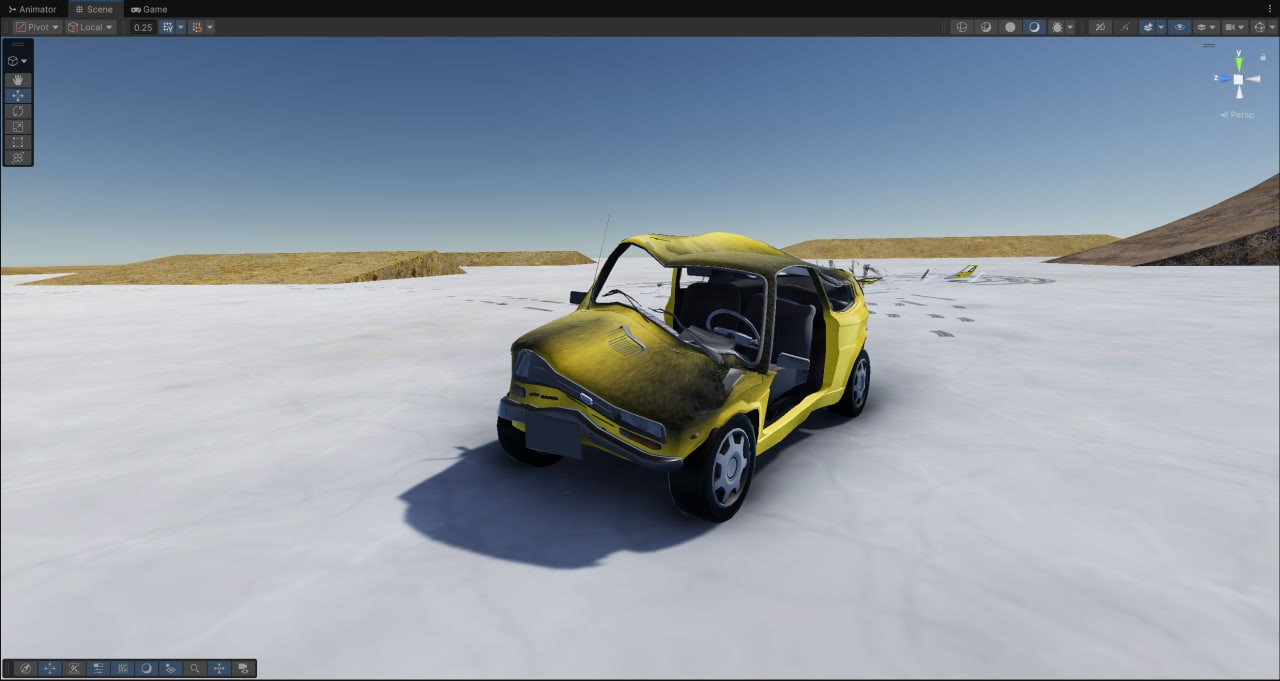
Первая задача — перенести в Unity систему отображения повреждений автомобилей из GTA V. В игре используется интересный механизм деформации машин, пришедший ещё из GTA IV и в своё время ставший в определённой степени прорывным. Он прост, элегантен и быстр: при столкновении вершины автомобиля деформируются не в исходной модели на процессоре, а на ГПУ. Для этого создаётся текстура, на которой в момент удара рисуются цветные фигуры с градиентом. Яркость пятна определяет силу повреждения, а цвет — направление удара. Затем текстура проецируется на автомобиль с помощью radial projection и используется вершинным шейдером для смещения вершин. Такой подход поддерживает столкновения с объектами любой формы и требует сравнительно мало ресурсов ГПУ.
Задача непростая: когда я создавал такую систему с нуля вручную, на неё ушло два дня. LLM написала код примерно за полчаса, включая мои замечания, направленные на существенное упрощение реализации.
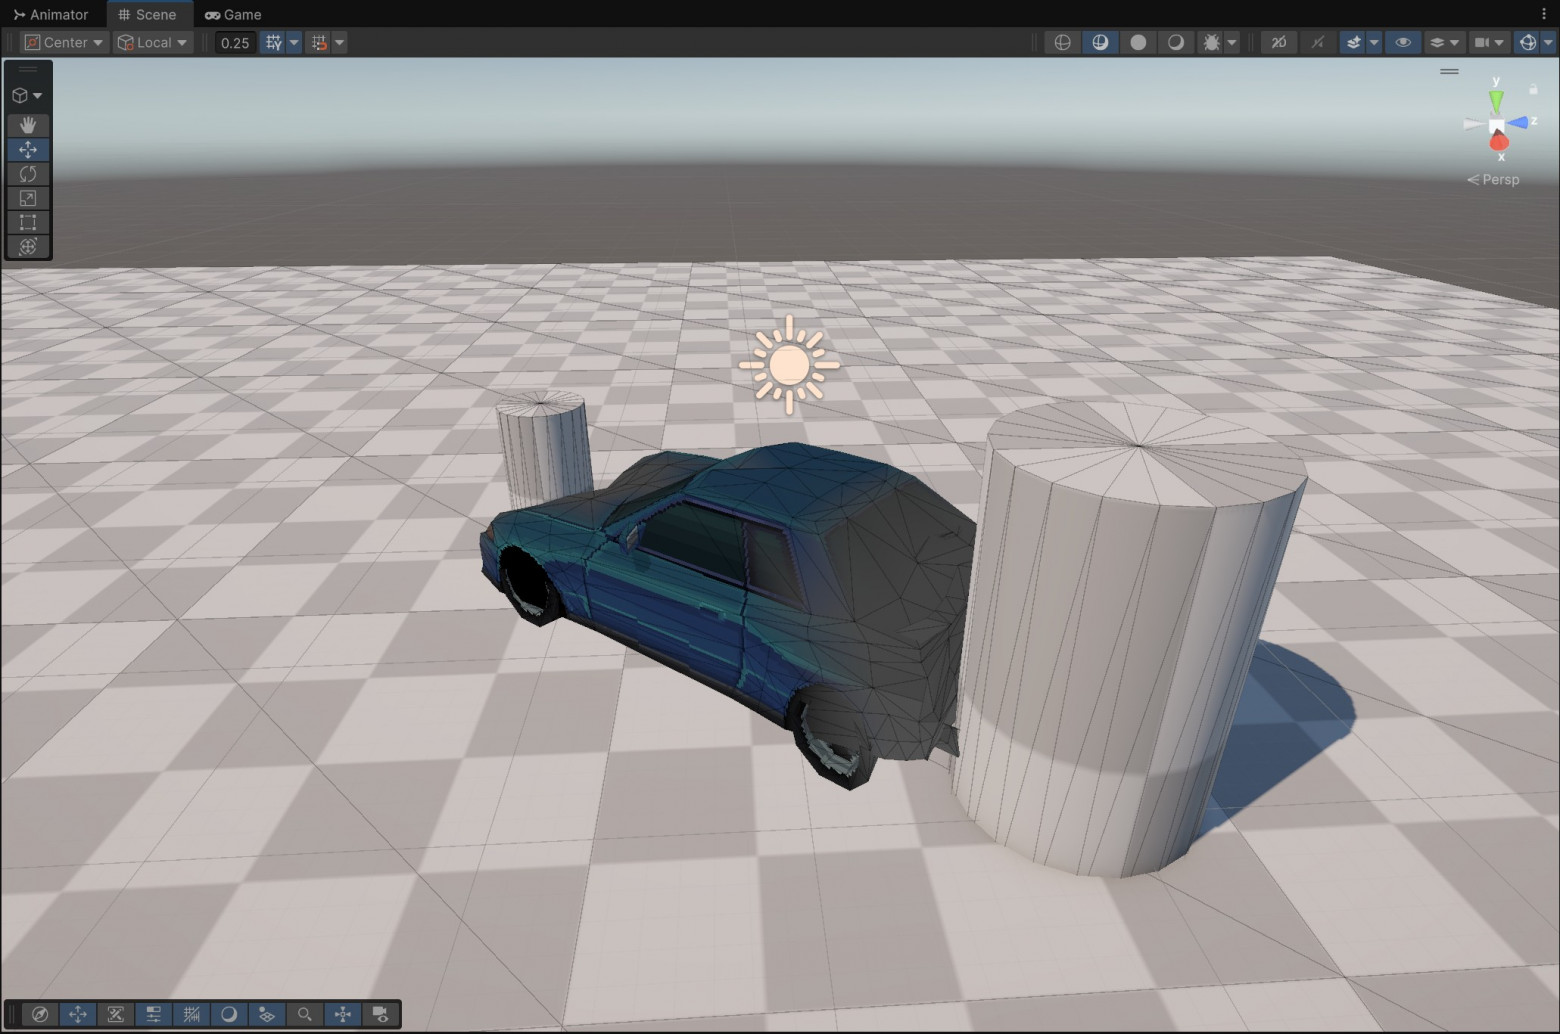
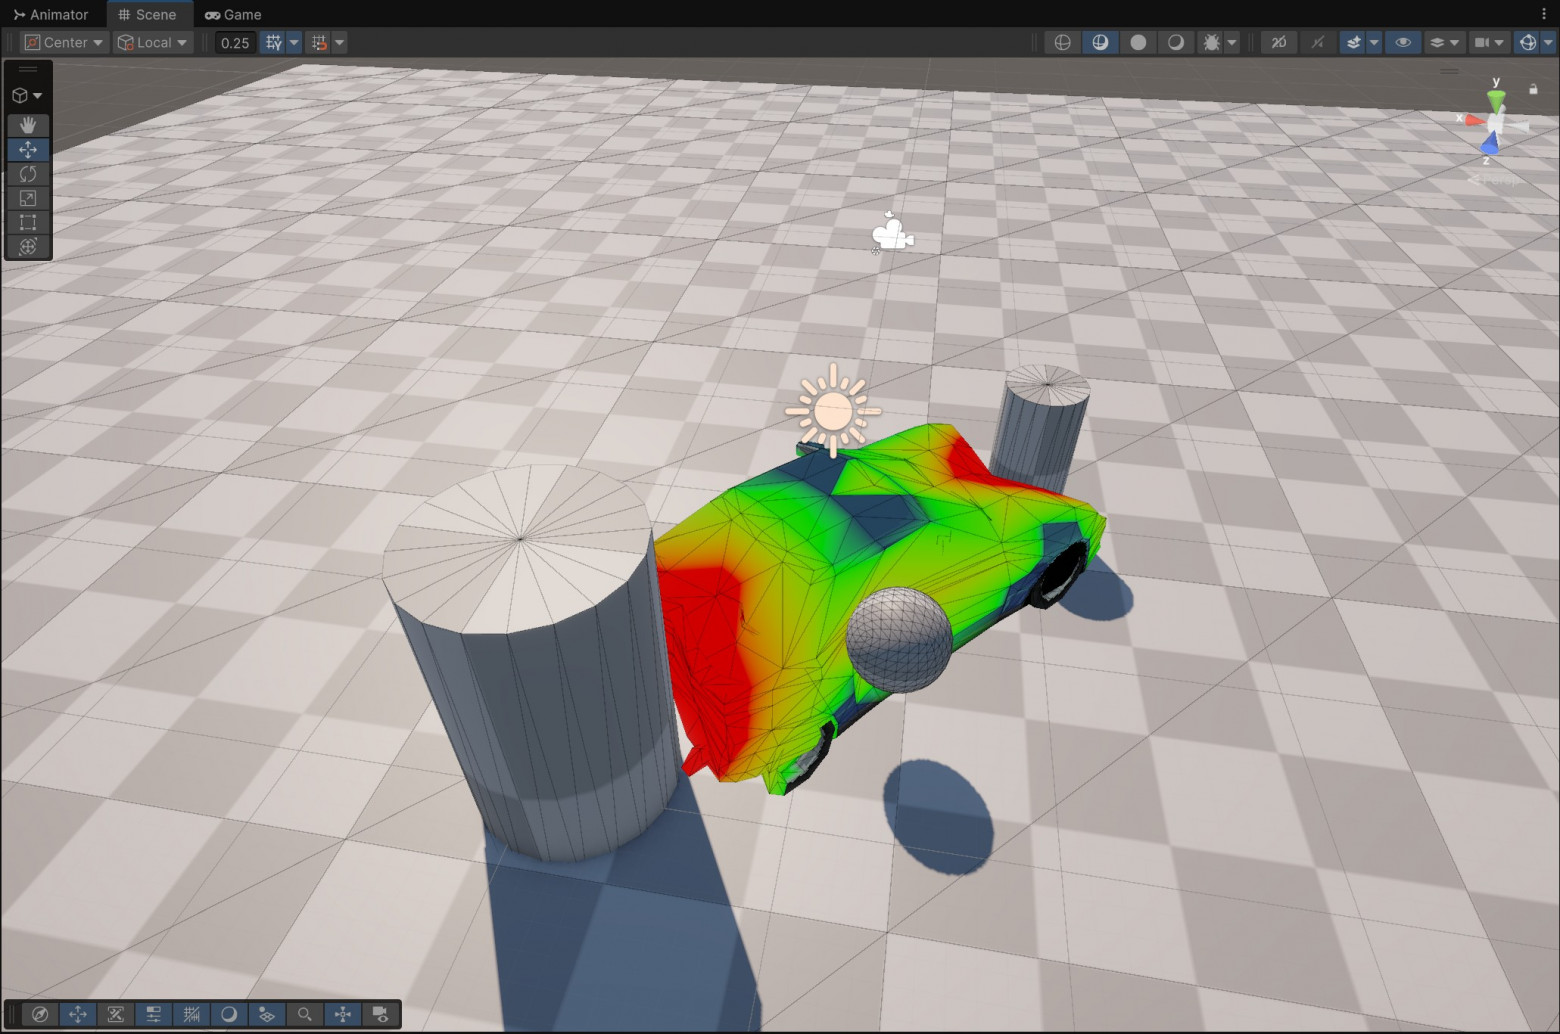
На модели автомобиля из GTA V результат выглядит весьма убедительно.
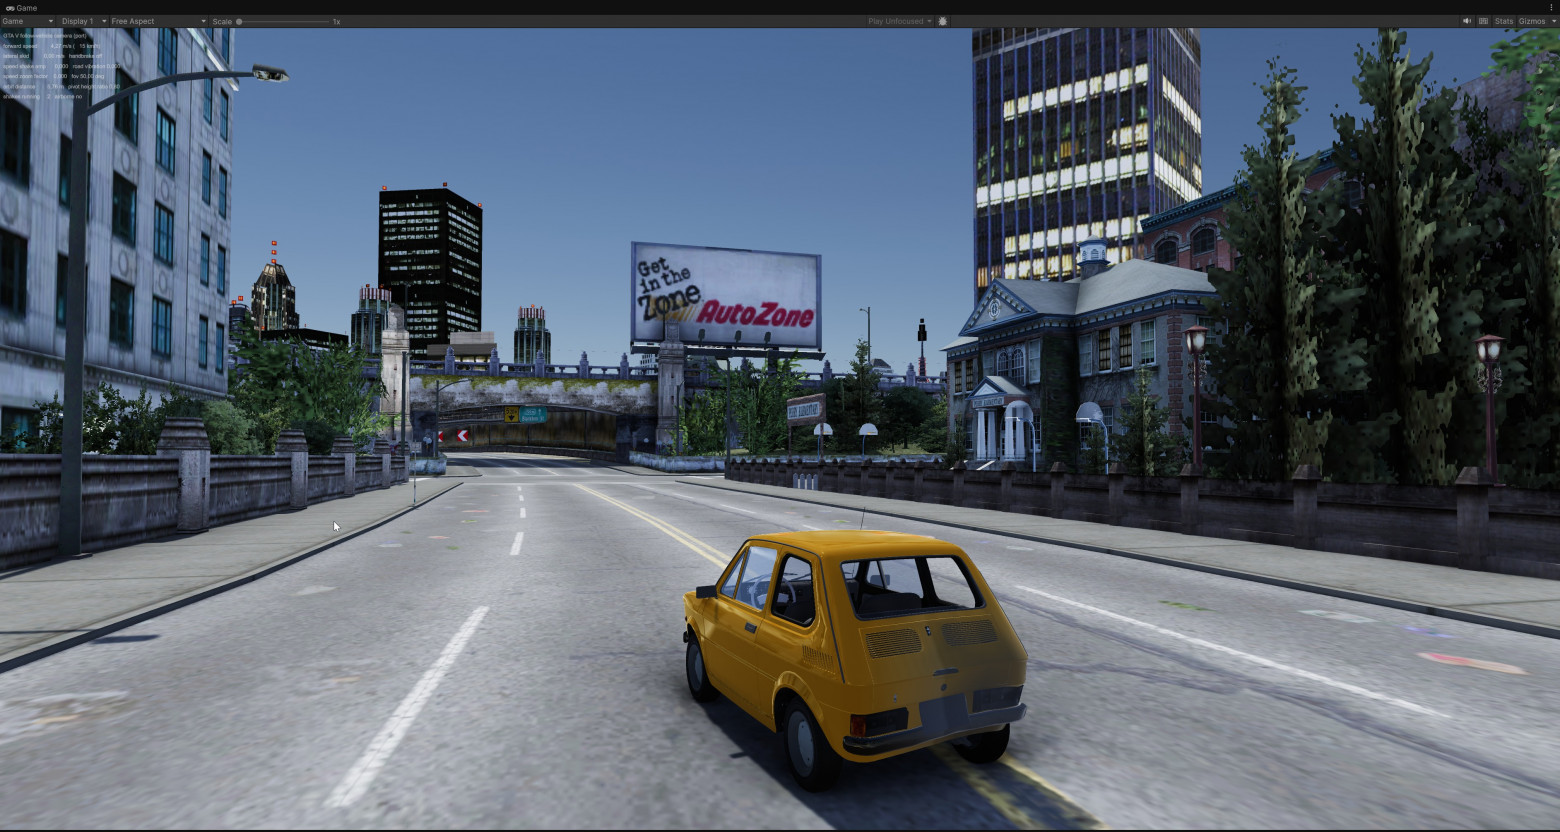
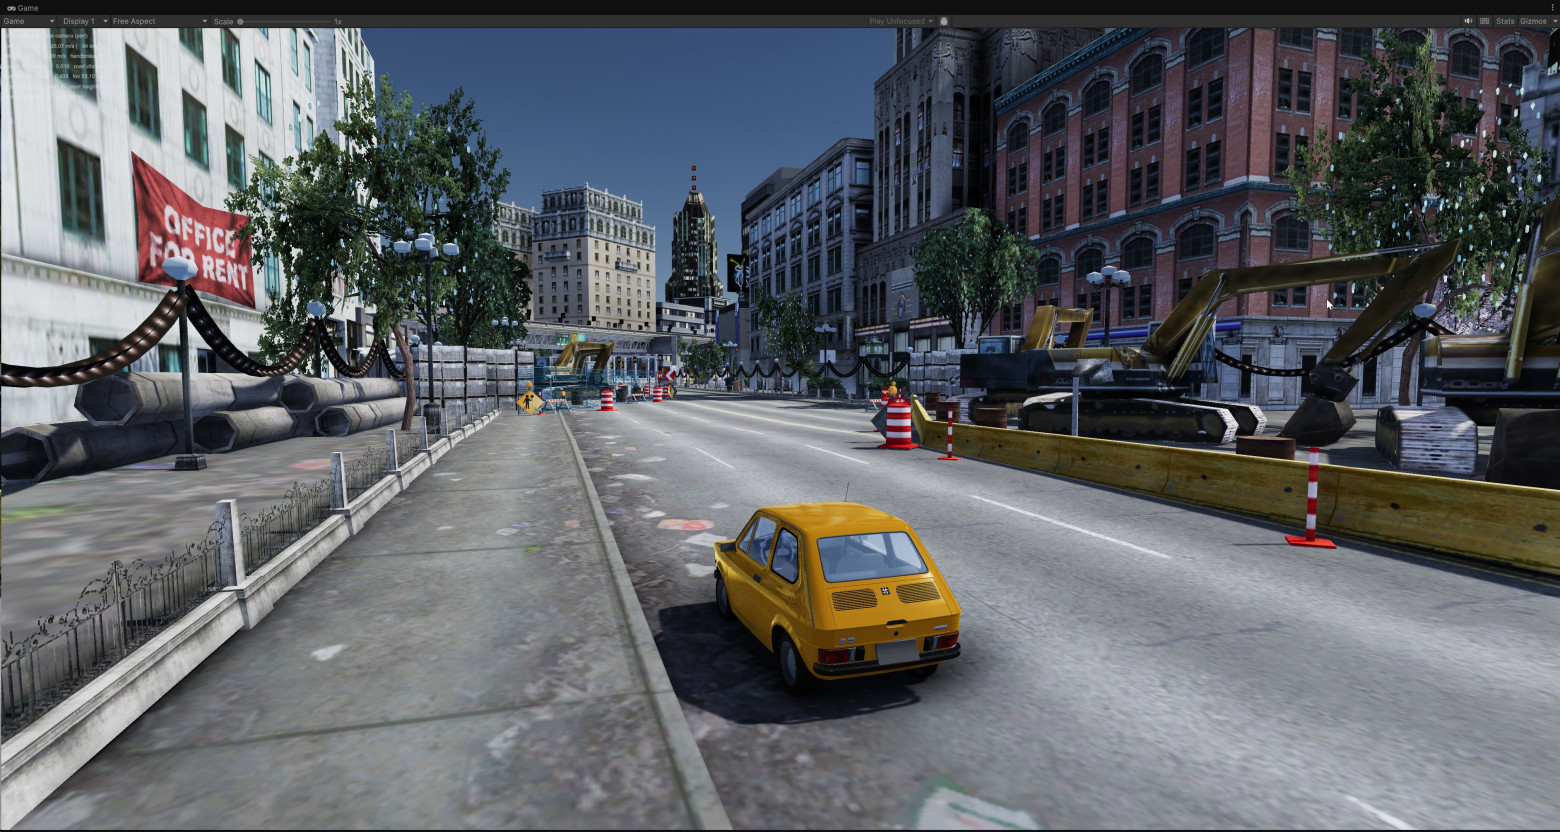
А чтобы было где покататься, дополнительно написали загрузчик карты из NFS Underground.
Создаём детские игры по изображениям
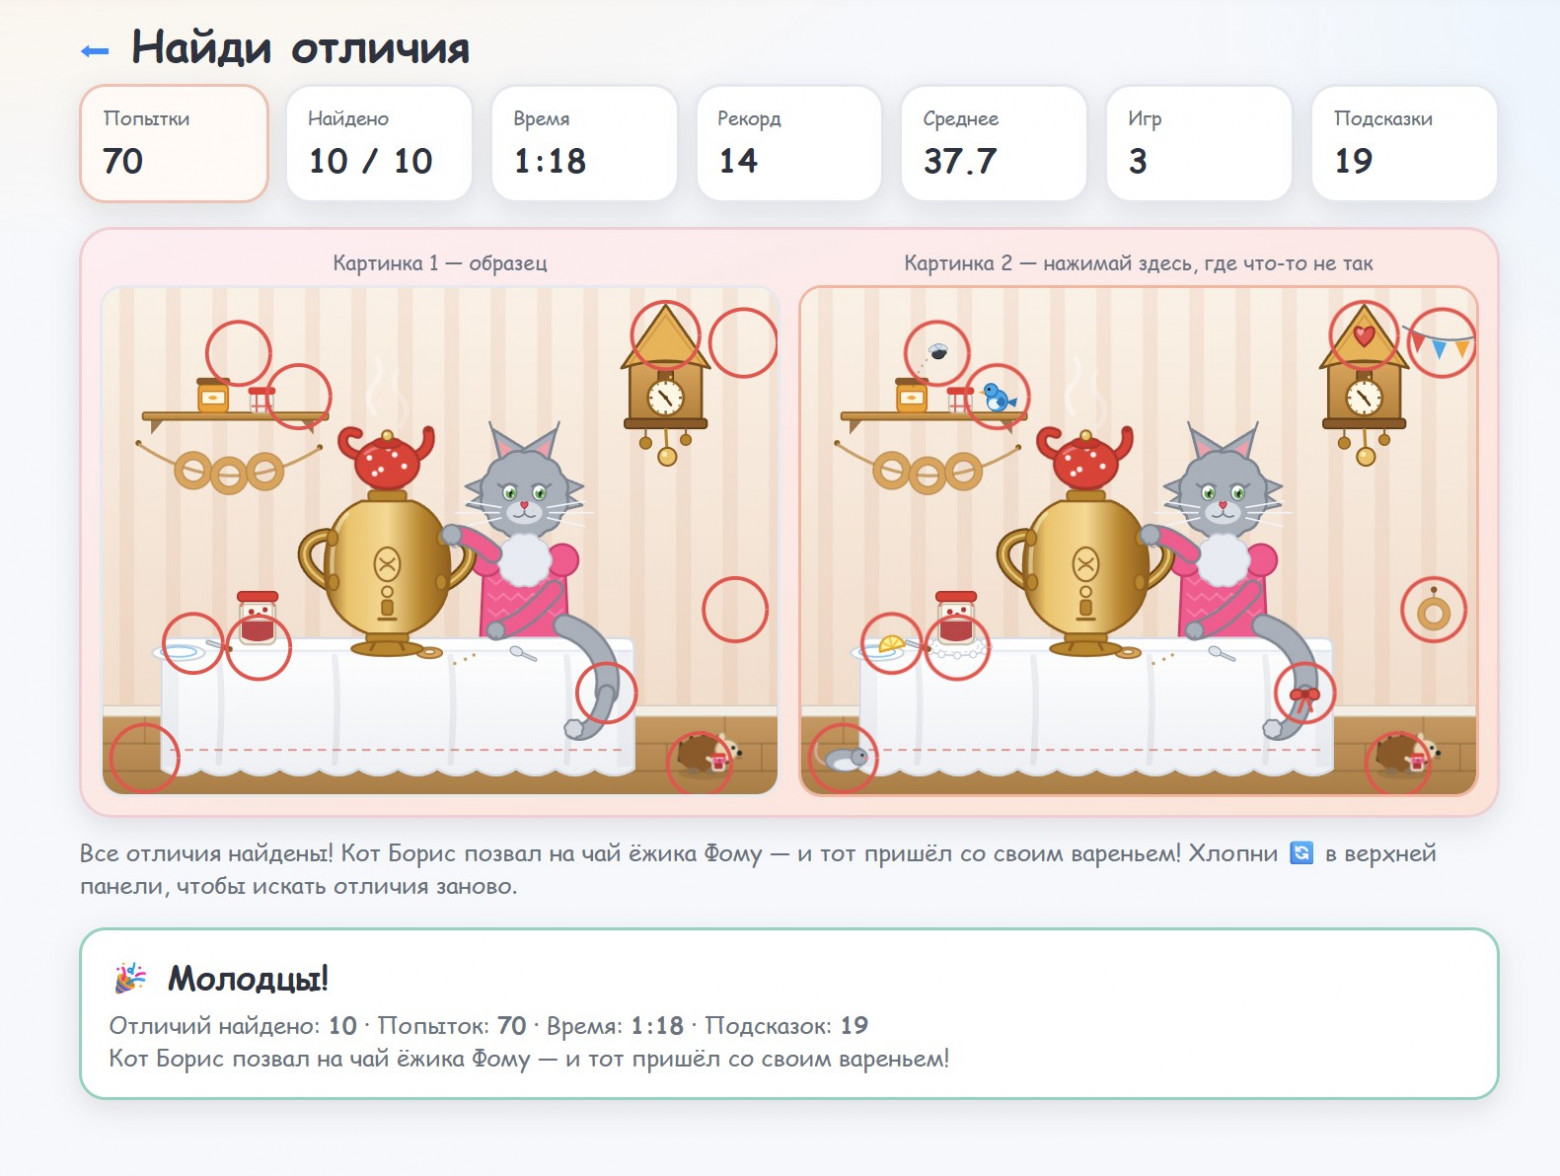
Меня попросили сделать несколько развивающих игр для детей. Мне стало интересно, справится ли LLM без подробного технического задания и моего активного участия. Я сделал скриншоты игр из презентаций и отправил их в чат с просьбой создать аналог. Первая игра предельно проста: нужно найти отличия между двумя картинками.
Модель справилась! SVG-графика получилась несколько неровной, но её можно исправить, а сама игра полностью работоспособна.
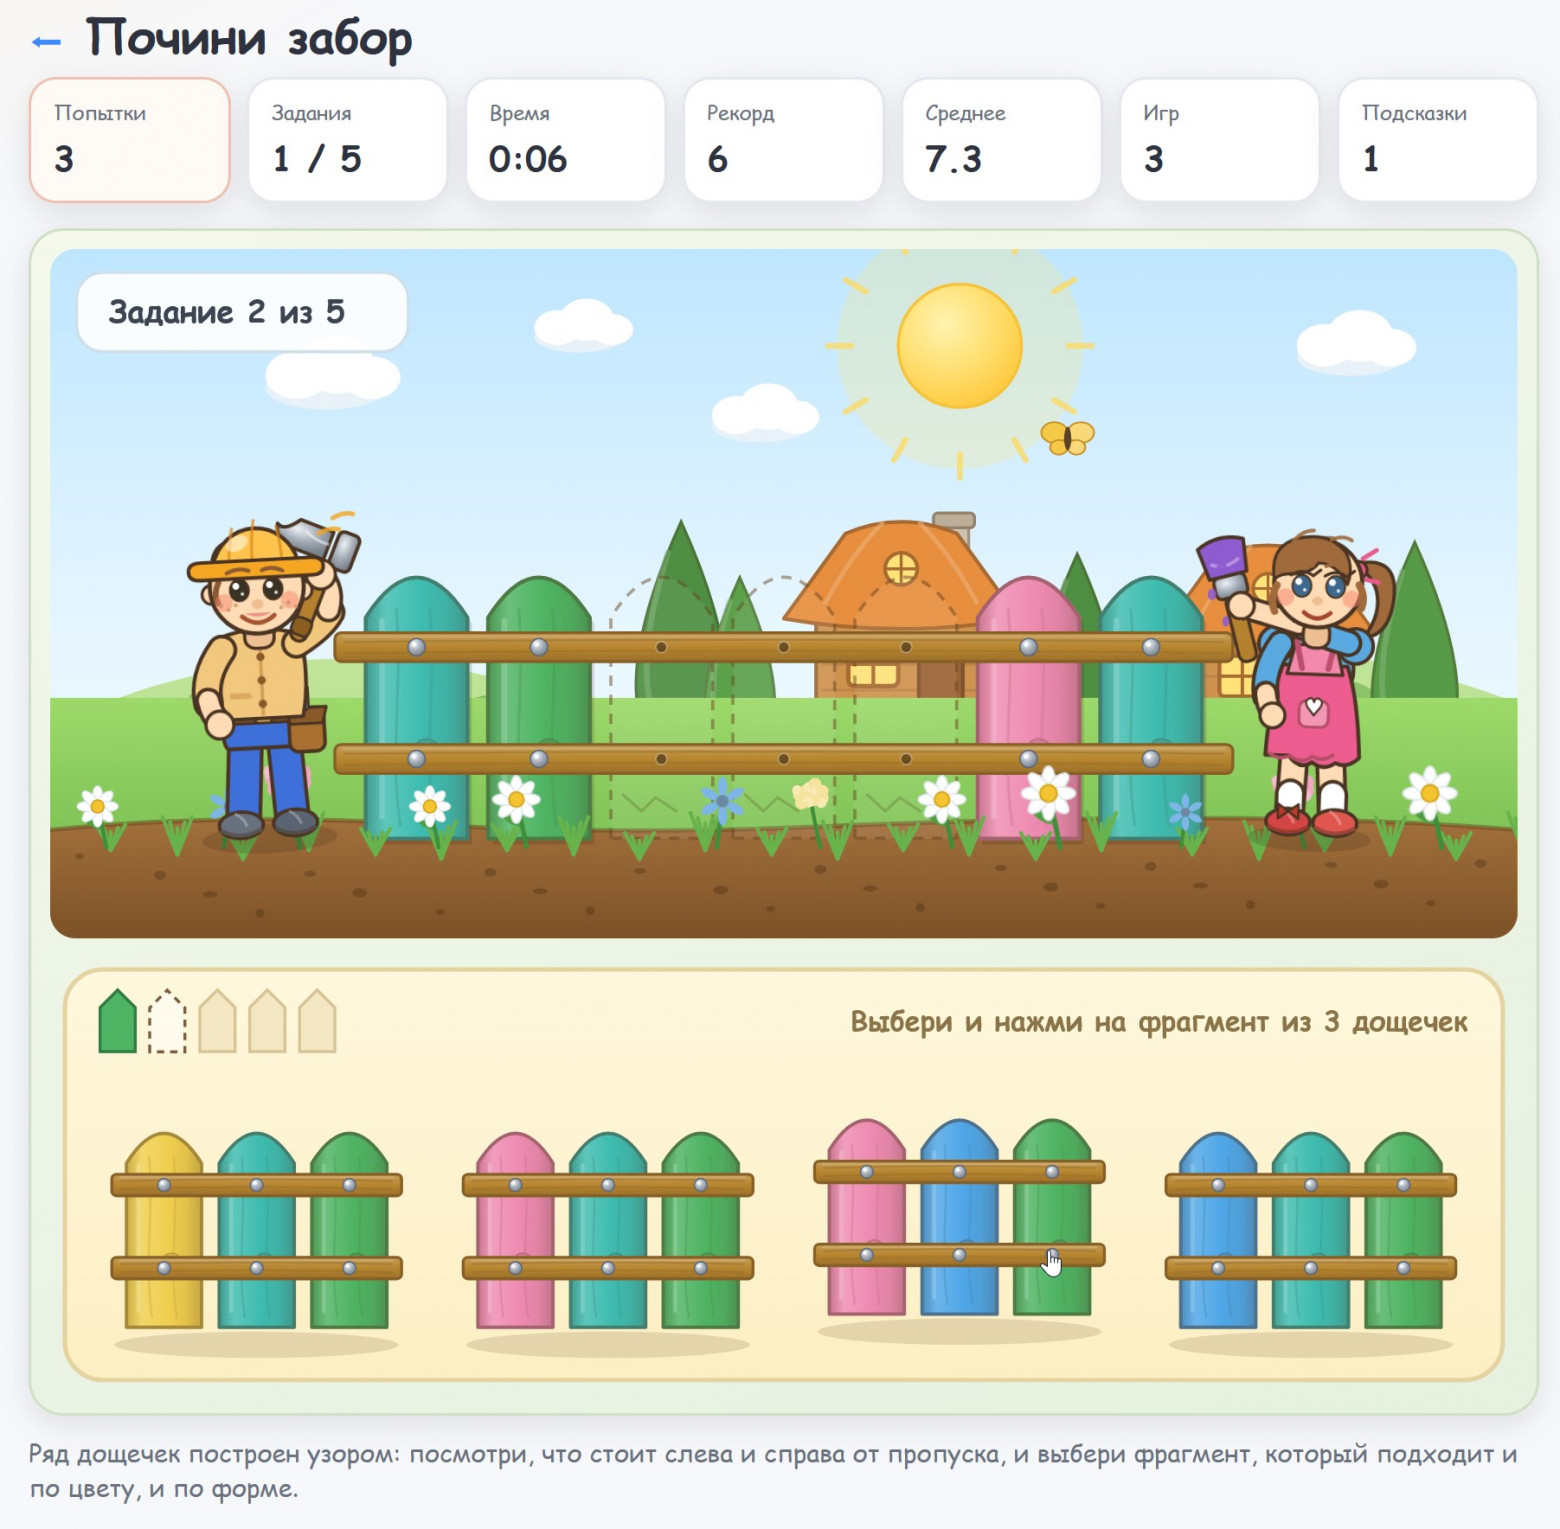
Таким же способом я добавил вторую игру с забором. Здесь SVG-рисунки выглядят ещё хуже, особенно изображения людей, причём даже после исправлений. Зато сама игра работает отлично и без ошибок, а спрайты можно локально сгенерировать в более подходящих инструментах, например ComfyUI + MiniMax H3.
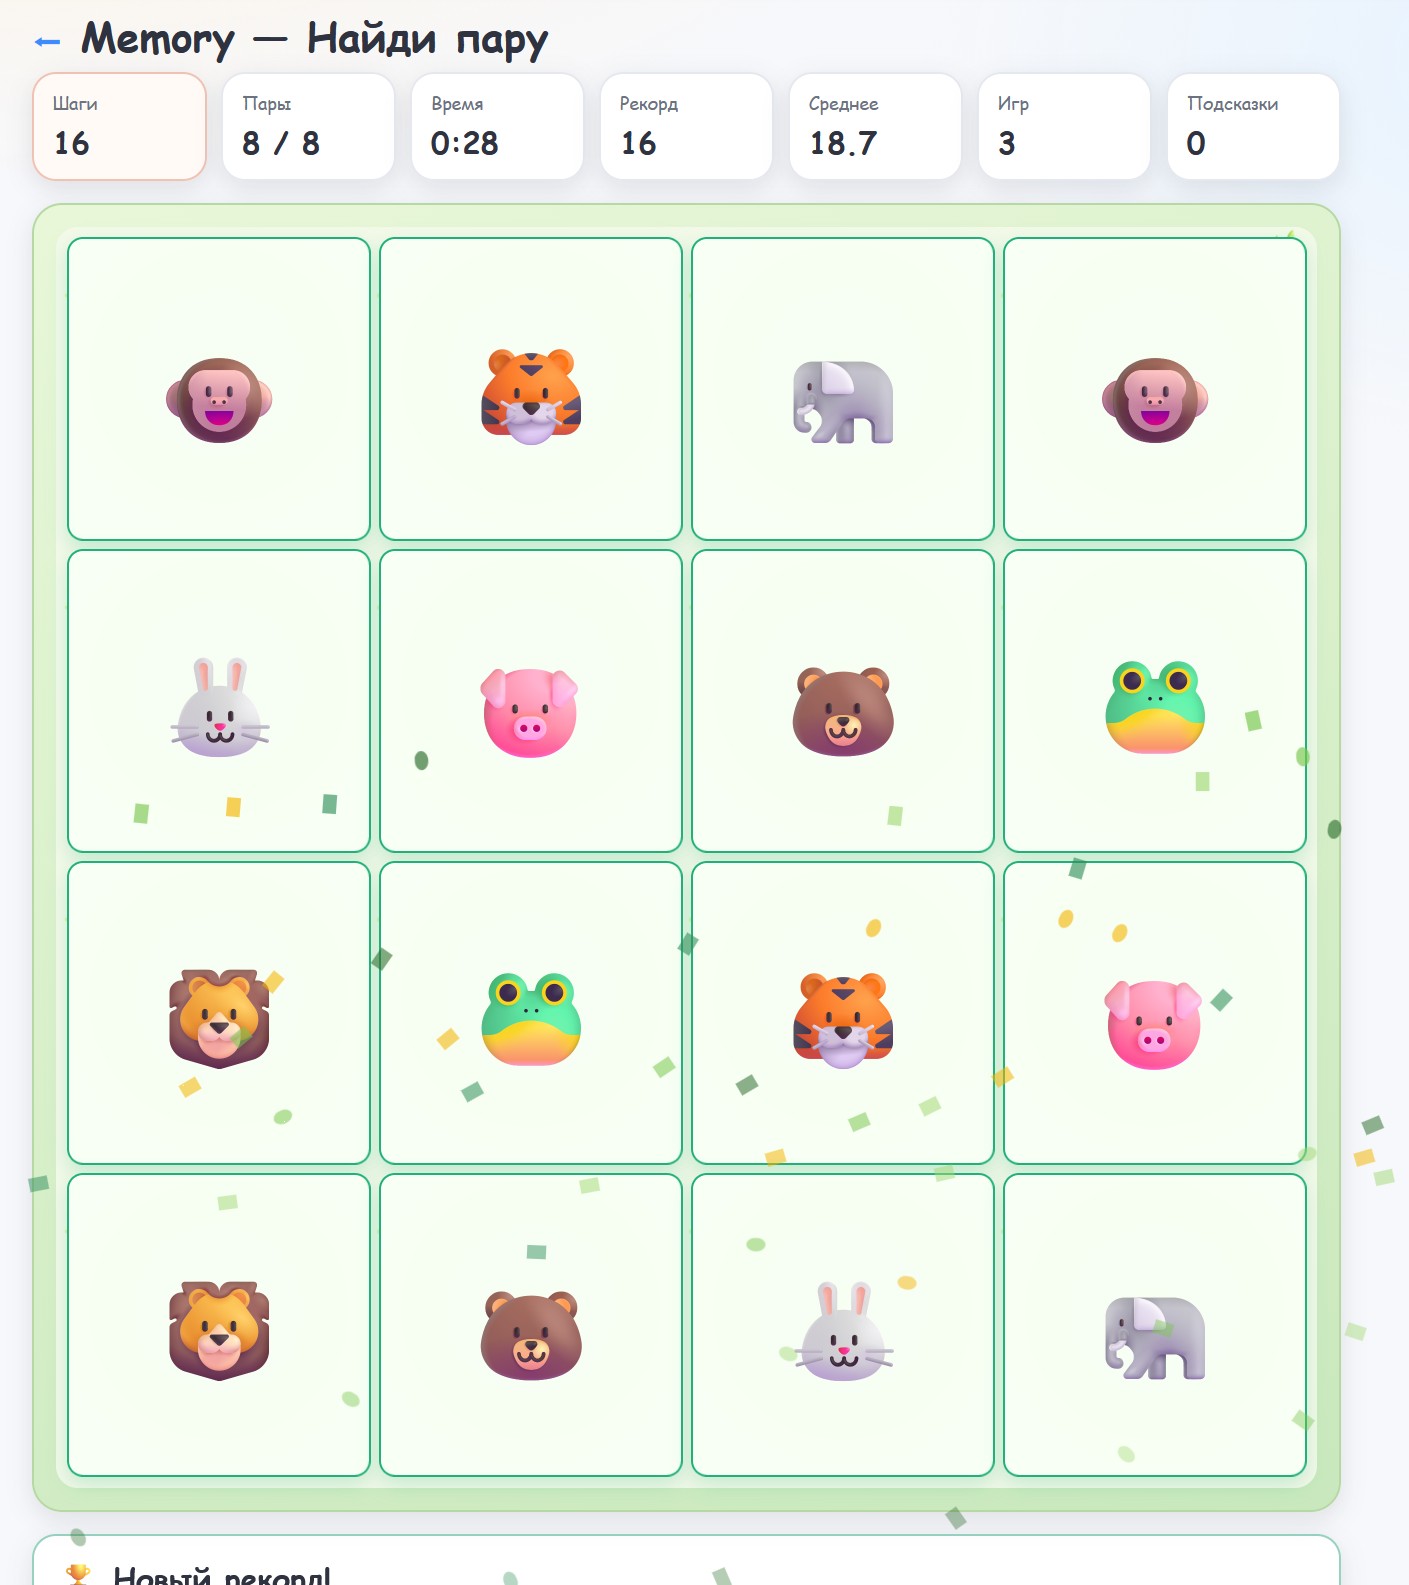
Классическая Memory Match тоже удалась. Правда, не сразу: поначалу закрытая карточка выглядела неровно, но после нескольких уточнений в чате всё заработало как надо.
Создание 3D-модели
Ради эксперимента я предложил модели ещё одну интересную задачу — создать 3D-модель корпуса. Освещением на моей кухне управляет ESP8266 с парой MOSFET-транзисторов и DC-DC-преобразователем. Я отправил фотографии устройства и сформулировал несколько запросов.
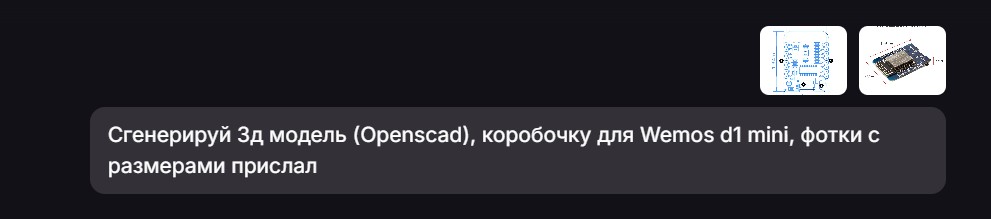
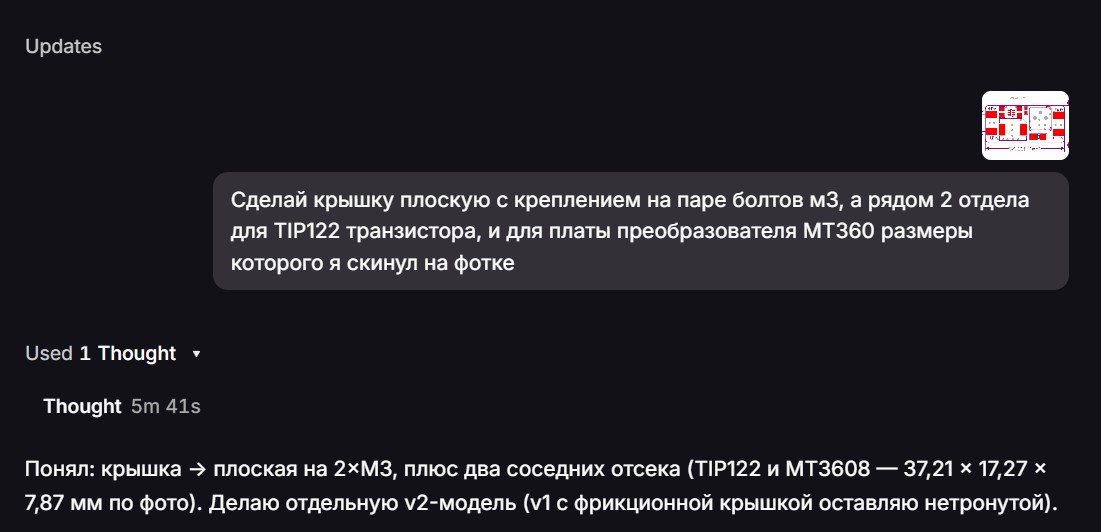
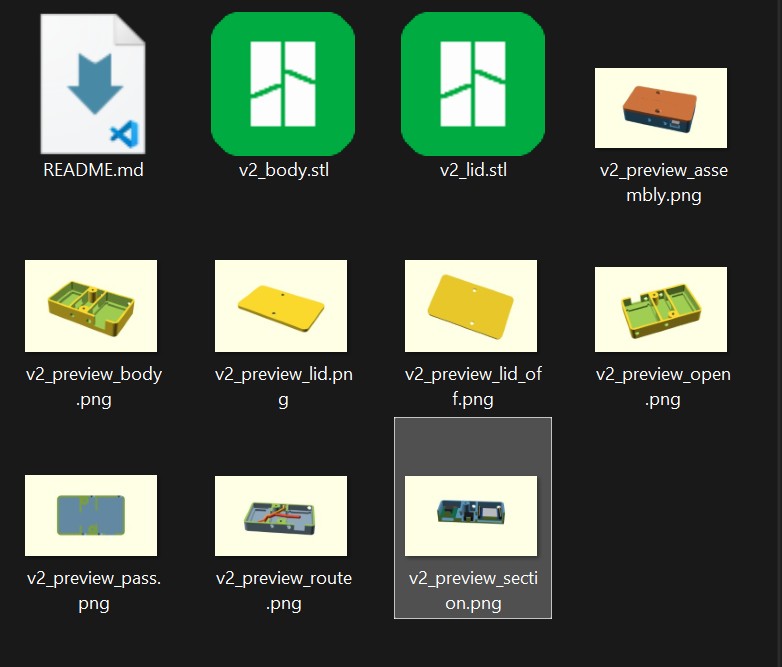
После пяти сообщений, трёх часов реального времени и четырёх итераций получился вполне приемлемый корпус в OpenSCAD. Любопытно, что LLM даже смоделировала прокладку проводов внутри, чтобы определить оптимальное расположение отверстий.
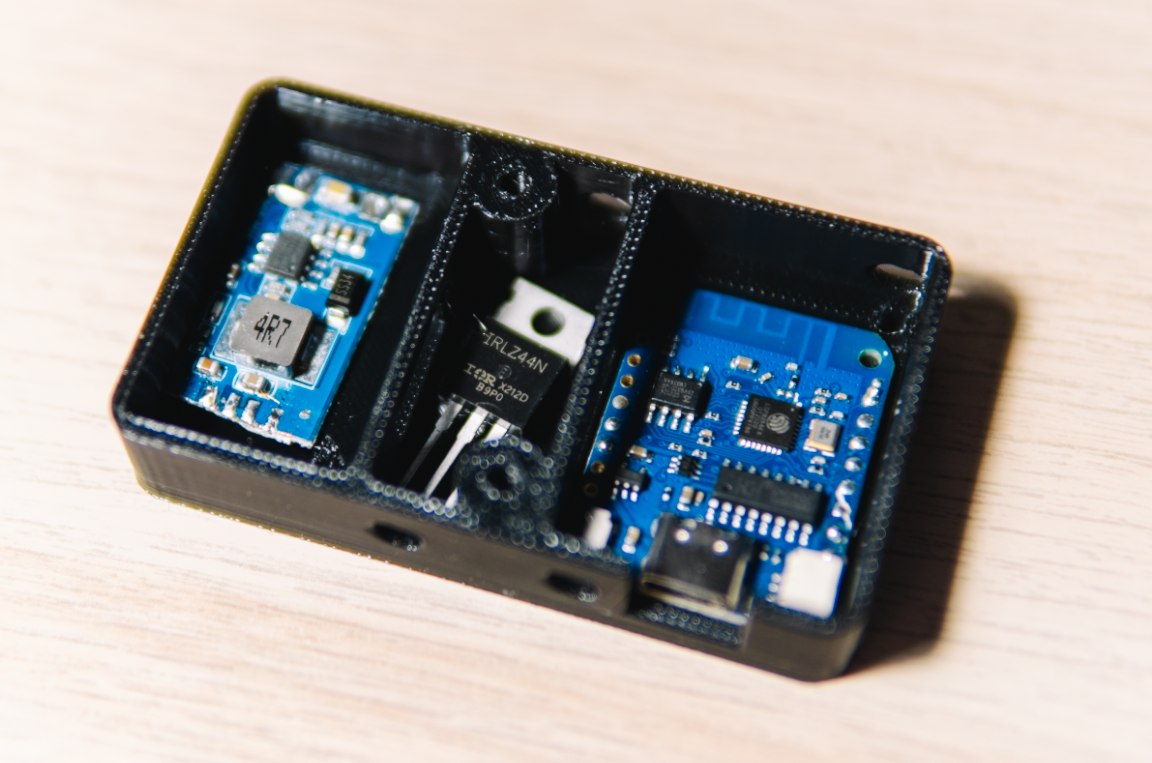
Разумеется, я распечатал корпус. Компоненты в него поместились, но зазоры оказались слишком велики. Пользоваться можно, если добавить немного клея. Впрочем, модель сама предупредила, что ориентировалась всего на пару изображений, поэтому размеры приблизительные. Для более точного результата она предложила мне самостоятельно измерить детали и передать ей данные.
Развитие торрент-поисковика
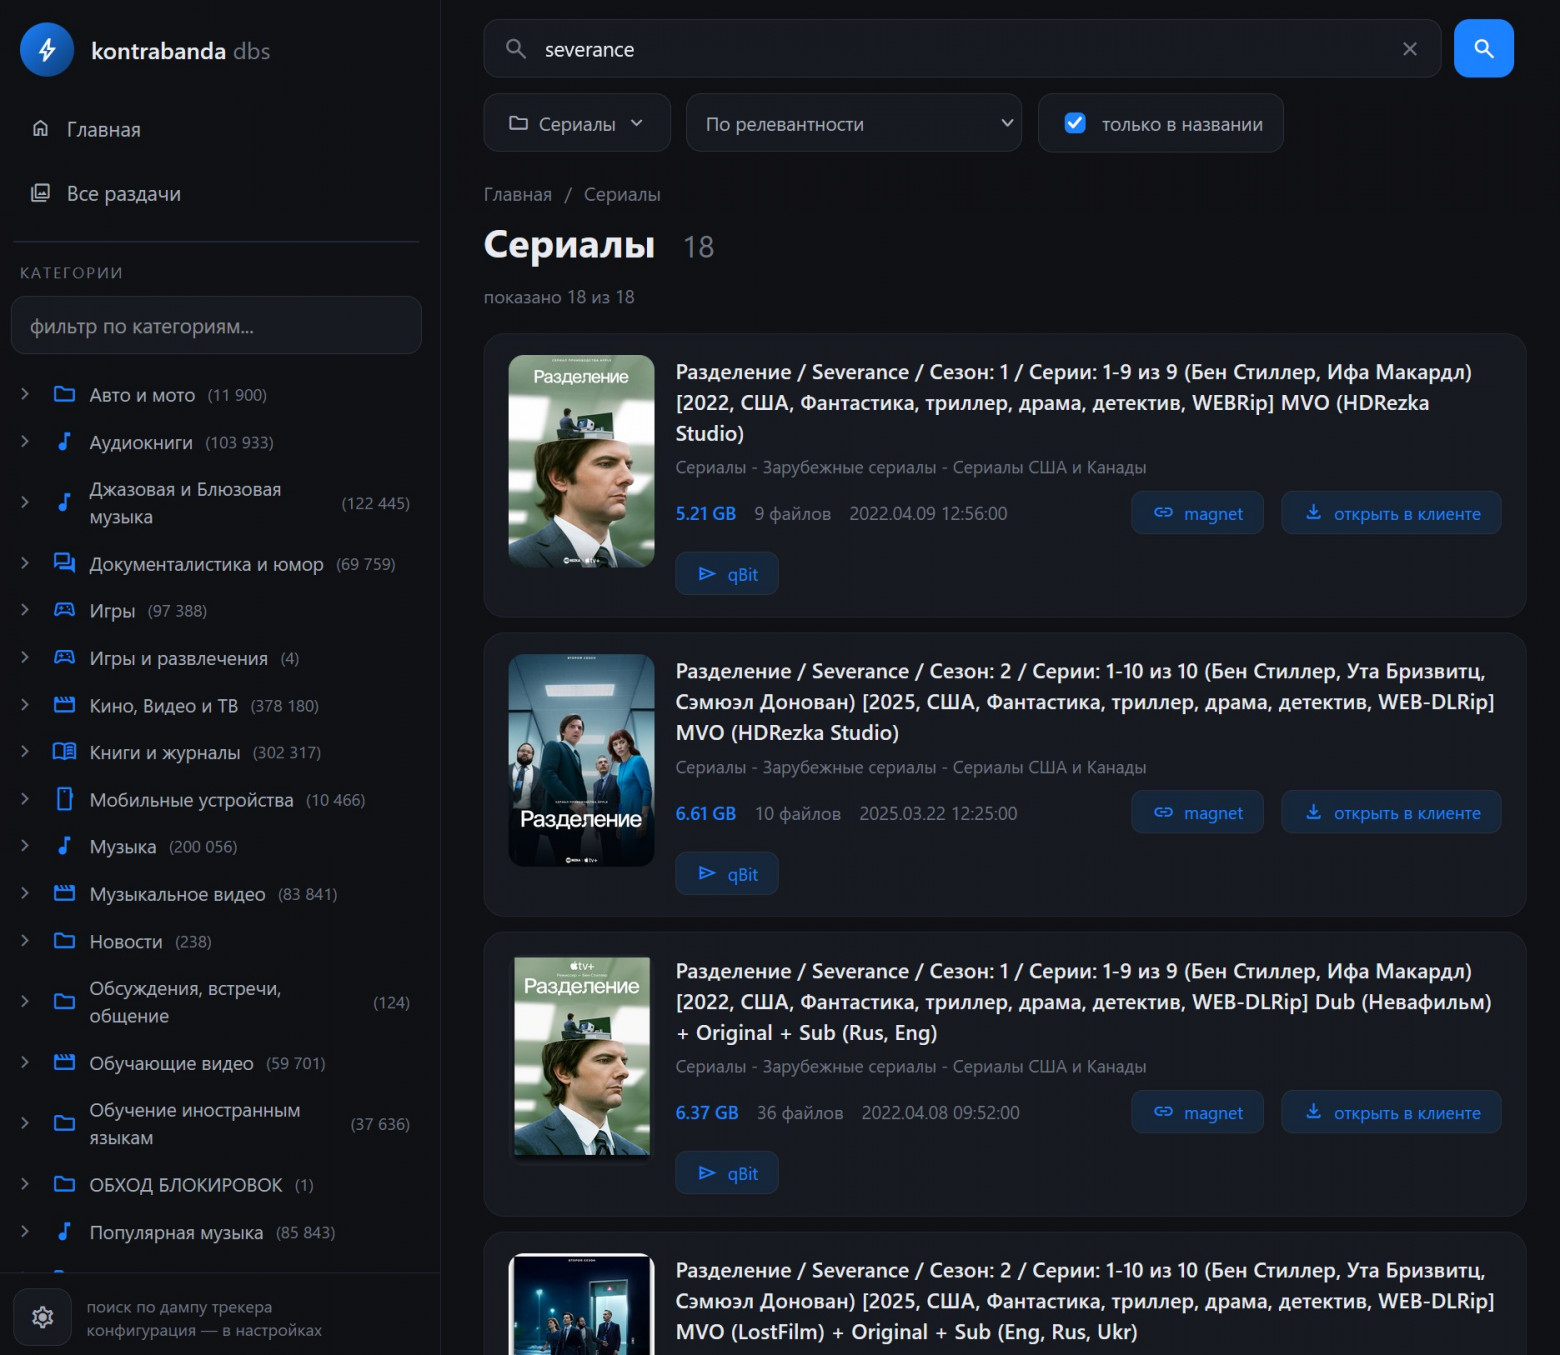
Ещё один пример — Kontrabanda-dbs, мой небольшой проект для изучения крупных баз данных и поиска по ним. За основу я взял базу RuTracker и с помощью Claude научился её парсить, переносить в SQLite и использовать модуль FTS5 для поиска с top-K.
Однако после интенсивной разработки Claude столкнулся с ограничениями: начал сбрасывать кэш, переписывать файл с нуля и обрываться на полуслове из-за исчерпания дневного лимита. Мой домашний аналог в лице Qwen без проблем справляется с подобной нагрузкой. С его помощью я улучшил дизайн, добавил интеграцию с qBitTorrent и его категориями, создал карточки торрентов и разделил проект, прежде состоявший из одного Python-файла, на логичные модули и веб-фронтенд. В дополнение настроил сборку Docker-образа.
Подключение к умному дому
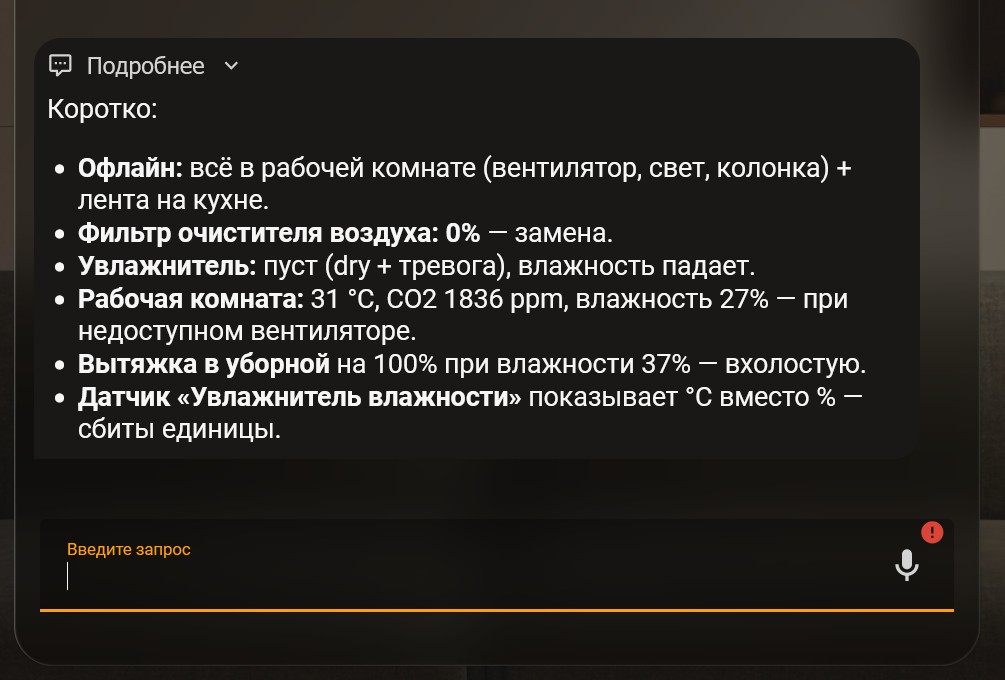
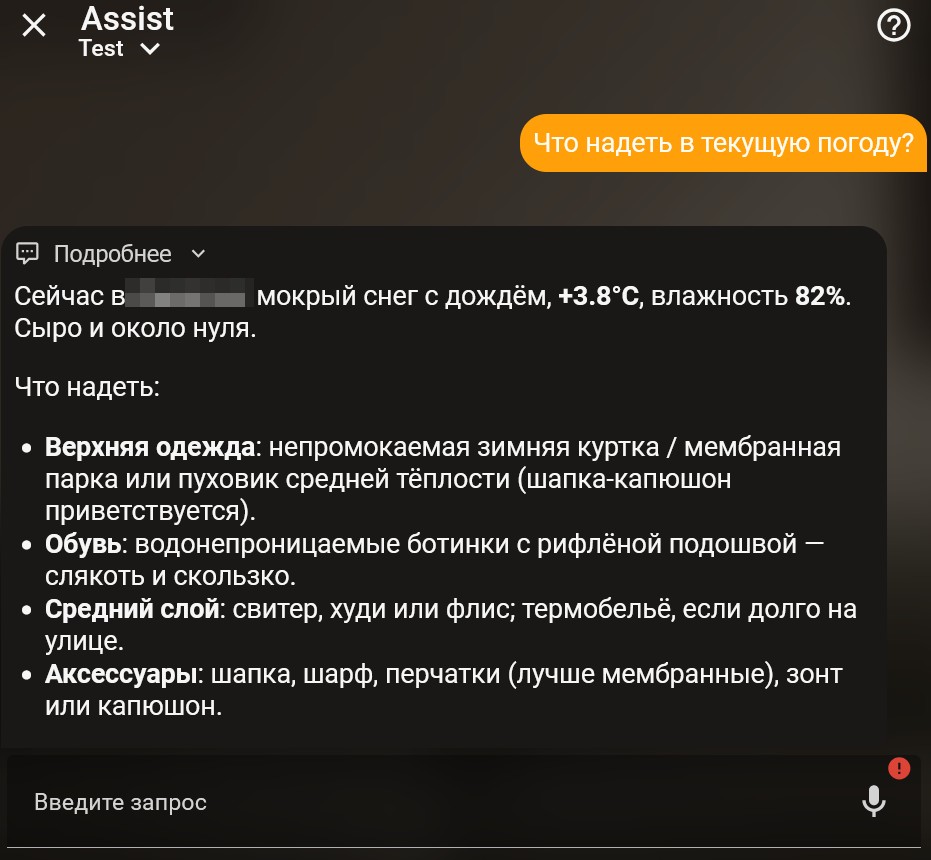
Конечно, для управления лампочками столь крупная LLM избыточна. Ранее я экспериментировал с Qwen 3.5 9B и получил отличные результаты: небольшая модель отвечала практически мгновенно при отключённых размышлениях и хорошо понимала задачи. Но что произойдёт, если подключить к умному дому большую и более способную модель?
Она отвечает столь же быстро и без затруднений управляет освещением и техникой. При этом её аналитические способности заметно выше.
Тем не менее собирать мощную систему для запуска LLM исключительно ради умного дома не стоит: с такими задачами справляются и более простые модели.
Бонус: запускаем Strata на слабом процессоре с памятью DDR3
Быстрая DDR5 и мощный Ryzen — это хорошо, но как Strata покажет себя на старой платформе с недорогой и медленной DDR3? Для проверки я использовал плату из предыдущего обзора. На ней установлен сравнительно слабый Intel D1581 с двухканальной памятью DDR3L: в тесте AIDA64 её пропускная способность составляет 20 ГБ/с, а задержка достигает 90 нс. SSD и видеокарта подключаются по шине PCIe Gen3. При этом я оставил RTX 2000 ADA 16 GB.
Собрав компоненты в корпусе сервера 2U, я установил и запустил Strata. На слабом оборудовании и установка, и запуск занимают заметно больше времени.
Результат ожидаем: всё работает, генерация идёт, а модель остаётся такой же способной, как и на более дорогой системе. Но скорость существенно ниже.
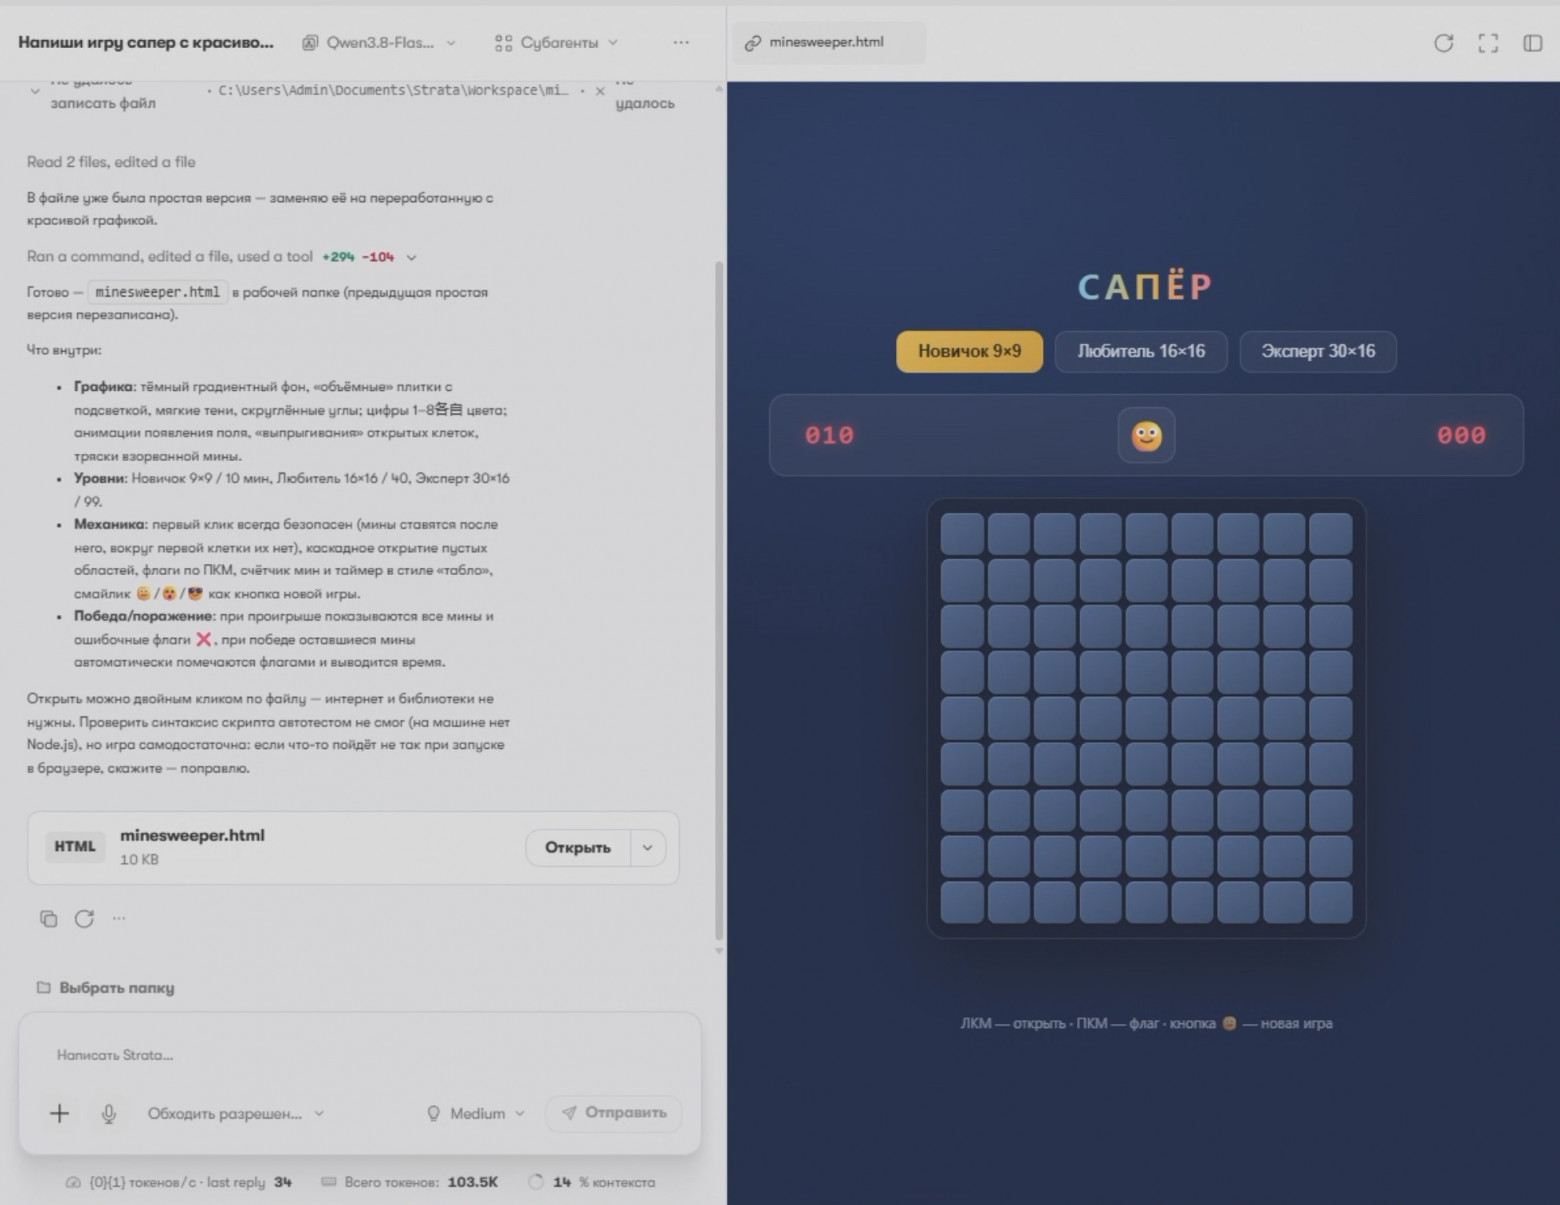
На создание того же «Сапёра» ушло три минуты. Игра заработала с первого раза и выглядит вполне приемлемо.
Скорость генерации снизилась с 35–70 до 19–55 т/с. При этом видеокарта загружена не полностью: во время работы она потребляет 30–62 Вт вместо максимальных 70. Похоже, платформа не успевает подготавливать данные для ГПУ. Скорость префила тоже заметно упала — 110–300 токенов в секунду, что довольно мало. На обработку 60K контекста, то есть половины от установленного окна в 120K, потребуется более трёх минут.
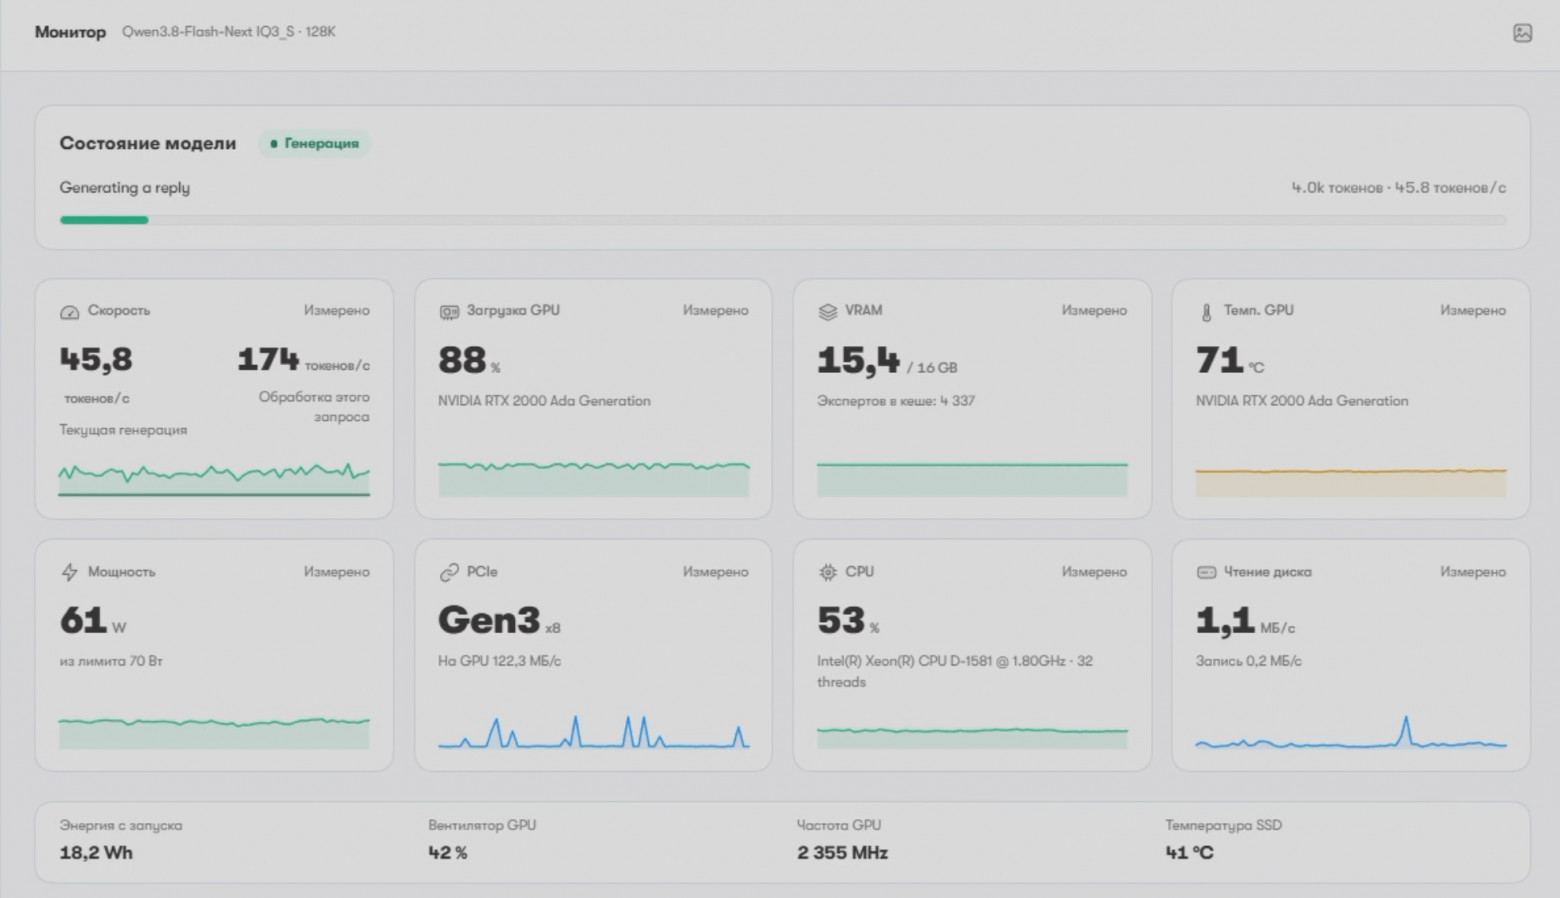
При таких показателях устанавливать видеокарту мощнее RTX 3060 с 12 ГБ памяти особого смысла нет. Зато можно собрать бюджетную машину для LLM на Nvidia P100: энтузиасты уже протестировали её и получили около 30 т/с. Для неспешной работы с кодом этого вполне достаточно.
Конечно, можно возразить: существуют же подписки. И действительно, доступные по подписке модели лучше, быстрее и предлагают больший контекст. Но надолго ли, особенно с учётом волн блокировок?
Итоги
Долгое время я воспринимал локальные LLM скорее как игрушки: доверить им что-то серьёзнее небольшого рефакторинга было сложно. Со Strata я впервые почувствовал, что не просто тестирую модели, а действительно решаю задачи на собственном оборудовании. Конечно, такое решение нельзя назвать совсем дешёвым, а для максимальной скорости придётся разобраться с ручными настройками. Но порог входа в мир локальных LLM ещё никогда не был настолько низким, а качество их работы — настолько высоким.
Так что пробуйте и экспериментируйте: на мой взгляд, это определённо того стоит, даже если ваше оборудование далеко не новое.
Мой Telegram-канал — заглядывайте: t.me/tiralab
© 2026 ООО «МТ ФИНАНС»
Похожие статьи
 Asus представила робота Gallop для предприятий электронной промышленности
 На всех смарт-телевизорах в России теперь обязателен RuStore
 Россия направит еще 3 млрд рублей на три Ил-114-300 для замены устаревших Ан-24
 Не Маск, а SK Hynix строит самый высокий в мире завод микросхем высотой с 50-этажный небоскрёб
 Google представила два новых TPU для ИИ-агентов и безопасных вычислений
 Главы технологических компаний подписали петицию о возвращении Дженсена Хуанга на пост гендиректора Nvidia
 Крупнейшая сеть зарядных станций в Китае запретила зарядку электровелосипедов и электромотоциклов
 LG готовит OLED-телевизоры 2027 года с диагональю до 83 дюймов