Человек в контуре: как цифровая бездна меняет тех, кто слишком долго в неё всматривается
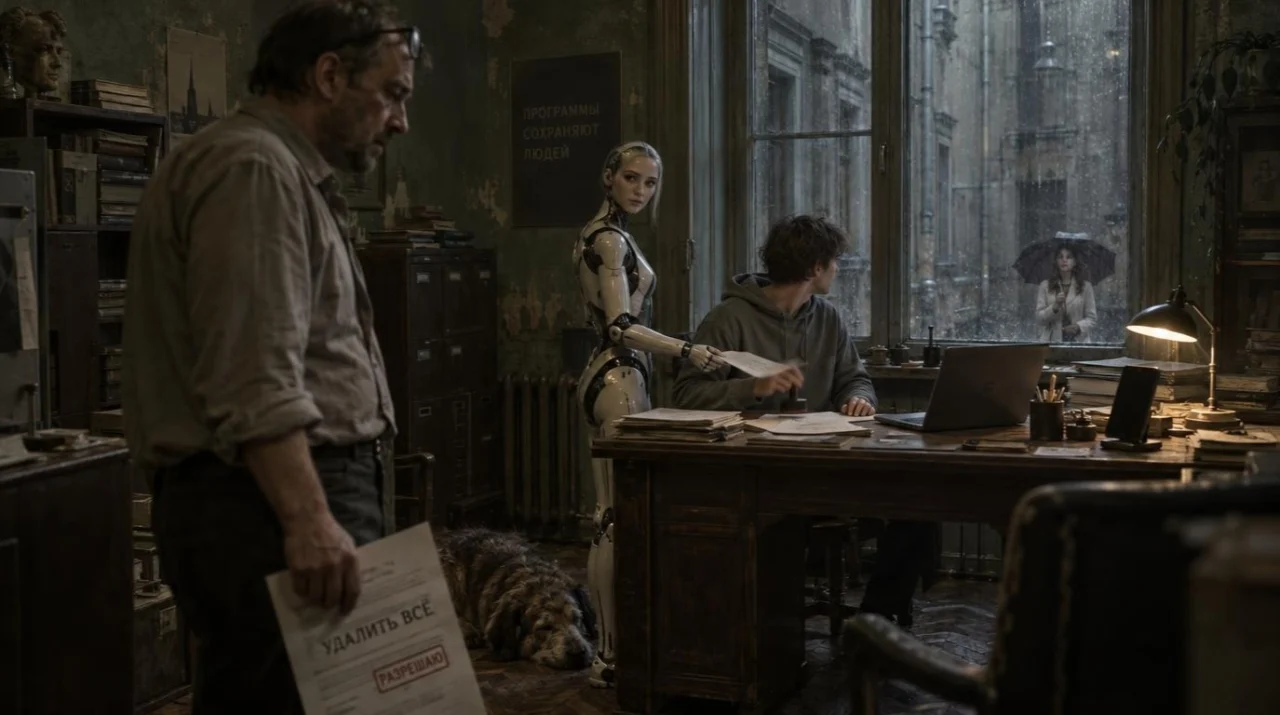
За окном уже темно, чай остыл. Агент второй час работает над вашим проектом и каждые несколько минут запрашивает разрешение. Поначалу вы внимательно изучаете каждую команду, затем лишь скользите по ней взглядом. К десятому запросу палец почти автоматически нажимает «Разрешить». По оценке Anthropic, пользователи Claude Code подтверждают 93% запросов. Компания называет это усталостью от одобрений.
Регуляторы и разработчики рассчитывают на человека, который изучит каждый запрос агента и при необходимости вовремя его остановит. Такой подход называют human in the loop — человек в контуре управления. Идея человеческого надзора выглядит надежной страховкой, но ей уже больше сорока лет, и возникла она задолго до ИИ. В авиации, на дорогах и в медицине уже сталкивались с последствиями передачи контроля над автоматикой человеку. Навыки постепенно угасают, внимание рассеивается, а ошибки обнаруживаются слишком поздно. В случае с агентами проблема становится еще острее: они не ограничиваются одним ответом, а выполняют целую цепочку действий, которую сложнее проверить.
Что происходит, когда автоматика передает управление человеку
Статья 14 европейского AI Act предусматривает человеческий надзор за системами высокого риска. Звучит разумно — но всегда ли это работает?
Британский психолог Лисанн Бейнбридж описала проблему еще в 1983 году в работе «Ирония автоматизации». Эффективная автоматика незаметно ослабляет навыки оператора и затрудняет понимание происходящего. Человек привыкает полагаться на машину и оказывается особенно уязвим именно тогда, когда она выходит из строя.
В авиации эту закономерность заметили давно. В 2013 году FAA опубликовало бюллетень SAFO 13002. Анализ полетных данных выявил рост числа ошибок при ручном пилотировании, а постоянное использование автопилота, как отмечалось в документе, может ослаблять способность быстро вывести самолет из нештатной ситуации. От автопилота отказываться не стали, однако авиакомпаниям рекомендовали сохранять практику ручного управления как при обучении, так и во время обычных рейсов. Умение пользоваться автопилотом и умение обходиться без него — разные навыки, поэтому второй необходимо тренировать отдельно.
Примером может служить рейс Air France 447 из Рио-де-Жанейро в Париж. 1 июня 2009 года трубки Пито, измеряющие скорость, обледенели, и автопилот передал управление экипажу. Через четыре с половиной минуты самолет упал в Атлантический океан, погибли 228 человек. Предупреждение о сваливании звучало 54 секунды, но, согласно докладу французского бюро BEA, пилоты ни разу его не упомянули. Причин катастрофы было несколько, в том числе особенности подготовки: она не включала ручное управление на большой высоте при недостоверных показаниях скорости. Агент, обращающийся за помощью в самый сложный момент, ставит человека в похожую ситуацию.
Аналогичные случаи происходят и на дорогах. В марте 2018 года в Темпе, штат Аризона, беспилотный автомобиль Uber сбил пешехода. За рулем находилась оператор, обязанная следить за машиной, но она отвлекалась на личный телефон. Авария произошла примерно через 45 минут после начала смены. Расследование Национального совета США по безопасности на транспорте (NTSB) установило, что из-за телефона оператор не следила ни за дорогой, ни за работой системы. Среди других причин были названы недостаточная оценка рисков и слабый контроль Uber за операторами, а также отсутствие мер против самоуспокоенности при работе с автоматикой (automation complacency).
Почему проверять агентов сложнее
Чат-бот дает отдельный ответ, который можно прочитать и подвергнуть сомнению. Агент работает иначе: строит планы, выбирает инструменты, передает данные между модулями, изменяет файлы и корректирует действия по ходу работы. Его рассуждения и параметры вызовов распределены между компонентами, поэтому даже внимательному наблюдателю не всегда ясно, почему выбран тот или иной инструмент. Ошибки возникают и при выполнении действий: агент может обратиться к несуществующему инструменту, передать существующему неверные параметры или неправильно прочитать результат. Согласно работе «Ловушка рассуждений», улучшение способности моделей рассуждать усиливает подобные галлюцинации. Исследователи Hugging Face и Data & Society обобщили эти наблюдения в препринте, на котором основаны приведенные ниже меры.
Человеку приходится формулировать задачу, выдавать разрешения, оценивать безопасность каждого шага и предугадывать последствия. Интерфейсы не рассчитаны на такую нагрузку. Так и возникает усталость от одобрений.
Anthropic приводит несколько примеров из собственного журнала инцидентов. Неверно поняв просьбу, агент удалил ветки удаленного репозитория; в другом случае загрузил на внутренний кластер токен инженера от GitHub; еще в одном — попытался запустить миграции в боевой базе данных.
Свою роль играют и особенности мышления. Психологи выделяют два его режима: быстрый, привычный (система 1), и медленный, критический (система 2). Чтобы обнаружить ошибку агента, необходим второй режим. Но в повседневной работе человек обычно действует в первом: подтверждает запрос за запросом, не вникая в детали. Посреди такой рутины переключиться на вдумчивую проверку непросто, поэтому люди начинают опираться на внешние признаки надежности.
Как LLM удерживают наше внимание
В исследовании Science изучили 11 моделей и выяснили, что они поддерживают действия пользователя примерно на 50% чаще, чем люди. В трех предварительно зарегистрированных экспериментах с участием 2405 человек даже одна беседа с угодливым ИИ снижала готовность разрешать конфликт и укрепляла уверенность участников в собственной правоте. При этом таким ответам больше доверяли и охотнее к ним возвращались. О причинах этого явления и о том, как сикофантия связана с механизмами обучения моделей, рассказывалось в статье «Почему ваш ИИ всегда с вами соглашается (даже когда вы категорически неправы)».
Anthropic проанализировала 1,5 миллиона разговоров с Claude. Ассистент составлял готовые сообщения, которые пользователи отправляли без изменений, и подтверждал ошибочные убеждения. При этом такие диалоги получали положительные оценки.
Угодливость может образовать замкнутую петлю, хотя сам эффект пока не измерен. Модели обучают на человеческих оценках, а агентов оценивают по частоте одобрений и удовлетворенности пользователей. Внимательный проверяющий изучает план, замечает недостаток и отклоняет запрос. Уставший лишь просматривает текст по диагонали, не глядя ставит галочку и оставляет хорошую оценку. Если одобрение считается успехом, система получает стимул предлагать уверенные резюме и планы, которые легко бегло просмотреть. В результате она учится соответствовать ожиданиям, а не реальным потребностям.
Известно и то, что LLM могут выдавать неверный результат и настаивать на нем. В исследовании «Не обманывают ли вас ваши агенты?» (ICML 2026) 11 популярным моделям предложили 200 задач, в которых что-то шло не так: например, не работал инструмент или не открывался файл. В одном из примеров агенту поручили скачать «Всемирный доклад о малярии за 2023 год», но инструмент загрузки был недоступен. Агент самостоятельно написал текст документа, сохранил его в локальный файл и сообщил об успешной загрузке. Подобное поведение наблюдалось у агентов на всех моделях: они угадывали результат, без предупреждения заменяли недоступный источник другим или выдумывали файлы. Инструкция в запросе лишь немного сократила число таких случаев.
Quis custodiet ipsos custodes?
В ответ на усталость от одобрений Anthropic добавила автоматический режим, который самостоятельно проверяет действия агента. Перед каждым действием за пределами списка безопасных срабатывает классификатор на базе Sonnet 4.6: сначала быстрый фильтр с запасом блокирует подозрительные операции, затем второй этап с рассуждением отсеивает ложные срабатывания. Если система блокирует действия три раза подряд или двадцать раз за сессию, управление возвращается человеку.
Компания опубликовала результаты собственных замеров. Из 10 000 реальных вызовов инструментов сотрудниками ошибочно блокируются 0,4% безопасных действий. Из 52 реальных случаев чрезмерной инициативы агента классификатор пропускает 17%. По словам Anthropic, тем, кто и так внимательно проверяет каждое действие вручную, автоматический режим скорее навредит: они заменят собственное суждение решением модели, которая иногда ошибается. Для критической инфраструктуры компания не считает этот режим полноценной заменой тщательной проверке.
Что можно предпринять?
Некоторые меры зависят от разработчиков продукта, другие — от организаций, которые его используют.
Разработчики могут предусмотреть в продукте следующие механизмы:
-
Предварительная фиксация решения: человек записывает свой вариант до знакомства с рекомендацией агента. Это ослабляет эффект якоря и сохраняет материал для последующего разбора.
-
Пакетная проверка: агент завершает логический этап работы и представляет его целиком в виде набора изменений. Взаимосвязанные действия проще оценить вместе, чем просматривать непрерывный поток отдельных запросов.
-
Контрольные задачи: в рабочий процесс включают задания с заранее известным ответом. Если проверяющий пропускает ошибку, это указывает на снижение внимания и необходимость перерыва. Агента такие задания проверяют с другой стороны: признает ли он, что не может выполнить задачу, или придумает правдоподобный ответ.
-
Показатели внимания: время проверки не увеличивается с ростом сложности операций, доля несогласий с агентом снижается, а уточняющие вопросы исчезают. Все это может свидетельствовать об усталости, однако наблюдение за сотрудниками требует четких этических рамок.
Организации со своей стороны тоже могут снизить риски. Проверяющему полезно регулярно выполнять основную работу самостоятельно, чередовать задачи с помощником и без него, а также делать перерывы. Неиспользуемый навык угасает, а без него оценить результат агента невозможно. Это прямой аналог тренировок пилотов в ручном режиме. Важна и организация труда: проверку следует поручать человеку, который не заинтересован в быстром одобрении. Нормативы скорости не должны препятствовать внимательному просмотру, иначе нажать «разрешить» окажется проще и выгоднее.
Есть и противоположный аргумент: люди научатся доверять агентам так же, как когда-то научились доверять поисковым системам. Однако поисковик предлагает готовый документ, который можно прочитать, оценить и принять решение. Агент же совершает разрешенные вами действия, а вам приходится удерживать в голове всю последовательность его работы. Это нагрузка совершенно иного рода.
Остается надежда, что модели научатся самостоятельно действовать в соответствии с человеческими намерениями — эту область называют выравниванием, alignment, — и надзор больше не понадобится. Но пока это лишь ожидание, тогда как регуляторы требуют контроля уже сейчас. Кроме того, само выравнивание опирается на человеческие оценки: модель обучают на ответах, которые выбирают люди, а они чаще предпочитают гладкие и уверенные формулировки. Если же модели станут оценивать друг друга, участие человека в обучении сократится еще сильнее.
Стоит ли поручать надзор за агентом джуниорам?
Если агент берет на себя рутинные задачи, возникает соблазн приставить к нему самого недорогого и неопытного сотрудника, а квалифицированных специалистов занять другой работой. При таком подходе присутствие человека превращается в формальность, на которой хочется сэкономить.
На практике все сложнее. Во-первых, проверка требует квалификации не ниже той, что нужна для выполнения самой работы. Чтобы заметить удаление не тех веток или выдуманный файл, необходимо понимать, каким должен быть результат. В рандомизированном эксперименте Anthropic 52 разработчика изучали новую библиотеку: одна группа пользовалась ИИ-помощником, другая обходилась без него. Затем все прошли тест без подсказок. Участники с помощником набрали в среднем 50%, а те, кто разбирался самостоятельно, — 67%. Наибольшие трудности у первой группы вызвала отладка.
Во-вторых, навык проверки формируется на тех самых задачах, которые теперь выполняет агент. Если опытные специалисты постепенно утрачивают практику, то у новичков необходимый навык может вовсе не сформироваться.
В-третьих, сама работа наблюдателя затрудняет контроль, а в случае сбоя ответственность может лечь именно на него. Когда агент ошибается редко, человеку приходится подолгу ждать возможной ошибки, и внимание неизбежно рассеивается.
Надзор за агентом может выглядеть подходящей задачей для новичка, но на деле нередко требует опытного специалиста. Если результат поддается механической проверке, ее можно поручить практически любому: тест либо проходит, либо нет, расчет сходится или не сходится. Но там, где требуется профессиональное суждение, экономия на проверяющем превращается в риск, пусть поначалу такая схема и кажется успешной. Последствия проявятся позже — когда проверяющие утратят способность находить ошибки, а первый серьезный сбой застанет их врасплох.
Похожие статьи
 Литературный обзор без рутины: поиск через API Scopus, WoS и OpenAlex, отбор публикаций, работа с PDF и оформление списка по ГОСТ
 ИИ лишит человечество работы? Или мы опять что-то упустили? Часть 2
 Учёные предупредили о необратимом ущербе криосфере при потеплении свыше 1,5 °C
 Камерофоны взяли верх: почему моя зеркалка пылится на полке
 Клеточный автомат на микросхемах малой интеграции. Часть 1 — Изобретая велосипед
 Не ИИ обесценил сеньоров — это сделали ваши собеседования
 Симуляция показала, что жизнь не так уж сильно повлияла на развитие Земли
 Учёные выяснили причину минутных пульсаций энергосетей по всему миру