Бюджетно и неточно: анализируем контроллер памяти LLM-агентов
В 2024 году администрация Нью-Йорка внедрила чат-бота MyCity — виртуального консультанта для предпринимателей малого бизнеса, призванного упростить навигацию по городским нормативам и законам. Однако на практике система выдавала вредоносные рекомендации, чреватые судебными исками и штрафами: например, она советовала удерживать часть чаевых у сотрудников или увольнять персонал за обращения по поводу домогательств.
При этом валидные данные сосуществовали в векторной базе с устаревшими регламентами. Выяснилось банальное: алгоритм оказался неспособен сделать выбор между корректной и ошибочной инструкциями, когда обе они присутствовали в контексте.
Уязвимости стандартного поиска
Традиционный подход с генерацией, дополненной поиском (RAG, retrieval-augmented generation), устроен предельно прозрачно. Поисковый движок отбирает релевантные запросу текстовые фрагменты и передает их языковой модели в качестве контекста, на основе которого та формирует итоговый ответ.
Здесь кроется фундаментальный изъян. Модель способна оценить соответствие текста запросу, но степень доверия к источнику ей недоступна. Если загрузить в индекс противоречивые данные, поисковик сочтет их равноправными. Отсеивать достоверную информацию от ложной он не умеет, да и не проектировался для этого.
Исследователи из Тяньцзиньского технологического университета продемонстрировали это эмпирически. В бенчмарке TruthfulQA при смешении верифицированных фактов и устоявшихся мифов классический RAG продуцирует галлюцинации в 53% случаев. Для сравнения, модель без внешней базы демонстрирует ошибочные результаты в 23% сценариев.
Вывод очевиден: в цепочке от найденного документа до генерации ответа отсутствует критический этап проверки на достоверность, хотя сам поиск функционирует исправно.
Концепция MDL: три метрики и биомиметический подход
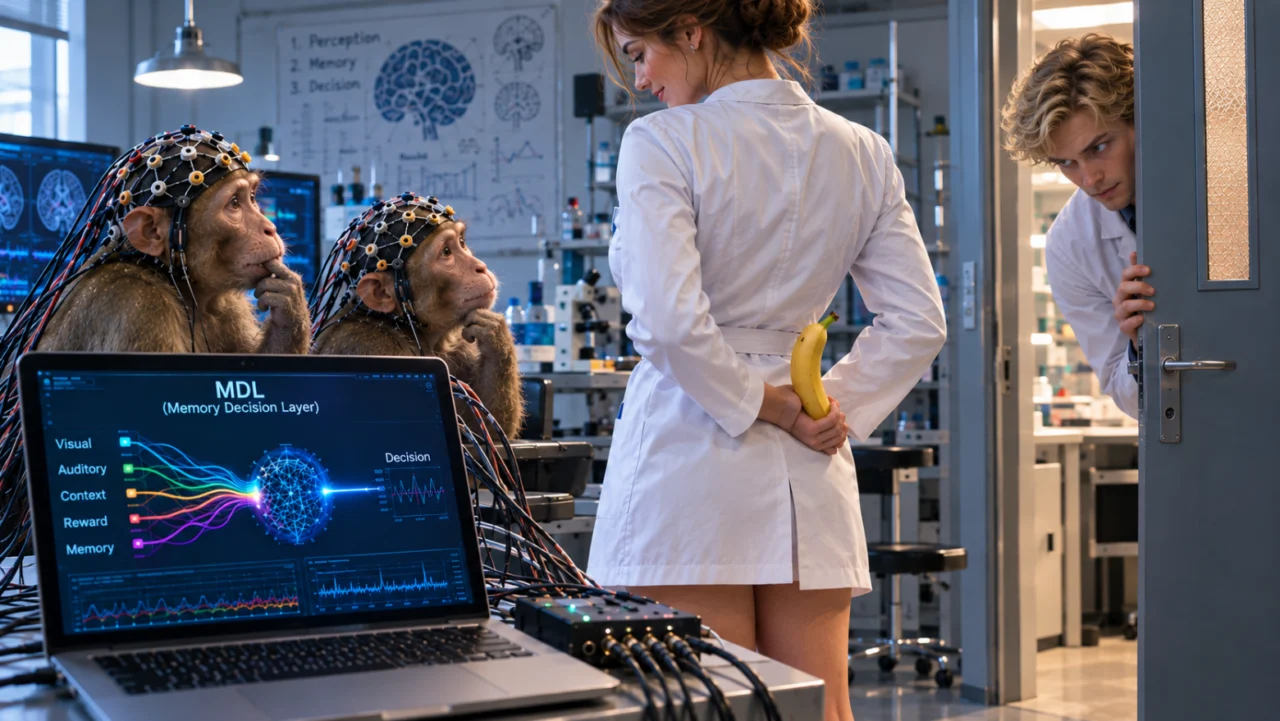
Источником вдохновения для создателей архитектуры послужило исследование нейрофизиологов, анализировавших работу префронтальной коры макак-резусов.
Наблюдая за приматами во время тестов на оперативную память и фиксируя электрическую активность нейронов, ученые установили: принимая решение о надежности воспоминания, мозг не полагается на единственный показатель его интенсивности. Разрозненные нейронные ансамбли параллельно обрабатывают множество параметров — от прогнозируемого времени удержания следа памяти до накопленного опыта прошлых попыток и общего уровня возбуждения. Эти потоки интегрируются в единый управляющий импульс, инициирующий поведенческий акт.
Авторы MDL (Memory Decision Layer — слой верификации памяти) имплементировали эту парадигму в программный код. Ключевая идея заключается в отказе от универсальной интегральной оценки. Характеристики документа обрабатываются автономно и объединяются лишь на финальном этапе.

Контроллер оценивает документ по трем независимым критериям.
Релевантность (M) — степень смыслового соответствия запросу, определяемая через классическое косинусное расстояние между векторными представлениями.
Надежность (R) — наличие или отсутствие внутренних противоречий в тексте. Специальный лингвистический анализатор фиксирует отрицания, антонимичные конструкции и инверсии полярности. При наличии внутренних конфликтов этот показатель снижается.
Рискоемкость (A) — потенциальный ущерб от некорректного ответа. Запросы из юридической, медицинской, финансовой сфер или области конспирологии автоматически получают весовой коэффициент риска от 0,70 и выше.
Стоит сделать оговорку: прямая аналогия с нейронной активностью макак носит метафорический характер, поскольку биологические нейроны не компилируют Python-код.
Архитектурные особенности реализации
Упомянутые три метрики намеренно не суммируются и не усредняются. Примитивное сложение неизбежно приводит к ситуации, когда доминирующий сигнал нивелирует остальные — например, высокая семантическая релевантность документа полностью маскирует содержащиеся в нем логические несостыковки.
Вместо этого каждый показатель трансформируется в отдельный вектор, проходящий через QR-декомпозицию для распределения по ортогональным математическим подпространствам. Это напоминает независимые каналы связи: изменение одного параметра никак не влияет на значения остальных. Высокая релевантность не способна затушевать противоречивость текста. Синтез итогового индекса доверия происходит лишь после завершения изолированных вычислений по каждому вектору.

Особого внимания заслуживает обработка фактора риска. В сценариях с повышенной критичностью темы коэффициент риска вычитается из единицы, уменьшая общую длину результирующего вектора доверия. Если итоговый показатель опускается ниже заданного порогового значения, система блокирует генерацию ответа по существу, уведомляя пользователя о высокой чувствительности темы и сомнительности источников.
При этом модель лишена когнитивного понимания происходящего: вердикт выстраивается на основе чистой геометрии векторов без семантического анализа, занимая около 40 микросекунд.
Результаты тестирования и скрытые нюансы
Заявленная эффективность впечатляет. В условиях конфликтных баз данных стандартный RAG ошибается в 53% случаев, тогда как MDL снижает этот показатель до 23,3%, а на высокочувствительных запросах демонстрирует нулевую погрешность.

Тем не менее детальный анализ экспериментов выявляет ряд серьезных ограничений.
Во-первых, результативность сильно зависит от базовой языковой модели. На относительно слабой gemma-4-E4B-it контроллер дает кратный прирост точности, в то время как более мощная deepseek-v4-flash удерживает уровень галлюцинаций в пределах 4,3% и без защитных механизмов. Интеграция MDL меняет этот показатель до 4,7% — разница укладывается в статистическую погрешность, а реальная польза проявляется лишь в узких высокорисковых доменах.
Во-вторых, даже после прохождения верификации контроллером 8% ответов содержат галлюцинации. Одобрение системы не гарантирует абсолютной чистоты: примерно в каждом двенадцатом случае алгоритм пропускает сгенерированную дезинформацию.
В-третьих, наиболее уязвимое место обнаруживается на пересечении высокой релевантности и высокого риска. В этом сегменте точность контроллера проседает до 55,6%, что едва превосходит случайное угадывание. Парадокс в том, что именно опасная, но убедительная информация должна вызывать максимальные подозрения, однако алгоритм хуже всего фильтрует релевантный, но деструктивный контент.
Нельзя не упомянуть и прагматический аспект. При сопоставлении геометрического метода с классическими алгоритмами машинного обучения вроде логистической регрессии или градиентного бустинга (которым скормили те же три сигнала) результаты оказались не в пользу новинки. Логистическая регрессия продемонстрировала 63,3%, бустинг — 64,6%, а геометрический контроллер — 61,2%. Традиционные модели, обученные на минимальной выборке, показали себя точнее.
Резюме
Модуль MDL функционирует как бюджетный предохранитель, минимизирующий частоту галлюцинаций, но не устраняющий их полностью. Решение демонстрирует сбои на критических направлениях, проигрывает в точности классическим ML-алгоритмам и сохраняет ощутимую долю ошибок даже после позитивного вердикта.
Безусловным достоинством подхода остается быстродействие: одна итерация занимает порядка 0,14 миллисекунды. Это в пятьдесят раз быстрее поисковой выдачи и на несколько порядков быстрее самопроверки силами самой языковой модели. Для сценариев, где критически важна скорость, такой компромисс выглядит оправданным.
Разделение понятий семантического соответствия и надежности источника — здравая и перспективная инженерная мысль. Однако текущая реализация скорее выступает временным патчем для существующей архитектуры RAG, нежели полноценным решением ее фундаментальных проблем.
Похожие статьи
 Куда исчезают 69 гигабайт с каждого терабайта и почему это стало причиной судов с производителями
 Как школьная алгебра за 7 класс спасает softmax от затухания градиентов
 Как Анри Беккерель совершенно случайно обнаружил радиоактивность
 Создаём энергоэффективную систему визуального мониторинга морской акватории
 Парадокс голосования обрёл геометрию: он оказался бутылкой Клейна
 Шесть версий, шесть неудач: почему программа не понимает, что пульт отключён?
 Динамика 12 индексов риска и их слепые зоны
 Как мы проверяли, насколько предсказания LLM соответствуют нормам профессиональных кодексов