
Артур Валиев: моя первая в жизни научная работа. Z3R0
Спустя 34 месяца я наконец делюсь проектом, которому посвятил несколько лет. =) Собственный ИИ — звучит забавно, правда?
Прежде всего хочу выразить признательность.
Spore, eligibilit, e-prop, NEST Simulator, BindsNET, Brian2, Norse.
Низкий поклон авторам этих проектов. Я восхищаюсь их работой и считаю их команды выдающимися исследователями, а их экспериментальные стенды — настоящими святынями. Желаю авторам всего доброго, а их исследованиям — блестящего будущего. Аминь.
Простите, если дальше я буду слишком торжественно говорить о своих достижениях. Без людей, перечисленных выше, этой работы просто не было бы. Вы лучшие.
Отдельного упоминания заслуживает Spore — другой инженерный проект для управления задачами ИИ, не связанный с одноимённым нейроморфным модулем.
Я искренне благодарен всем, кто создавал эти системы, изучал пластичность, разрабатывал математические методы и открыто публиковал исходный код.
Эти команды кажутся мне гениальными, а их экспериментальные стенды — почти священными. Разумеется, не в религиозном смысле. Хотя, когда в третий раз за ночь проверяешь причинность изменения синаптических весов, невольно задумываешься: может быть, некоторым уравнениям и правда нужен собственный храм.
И ещё раз простите за возможный пафос в рассказе о моих результатах. Без упомянутых исследователей значительной части этой работы не существовало бы. Наука начинается не тогда, когда я открываю редактор и создаю файл main.rs.
Её история началась задолго до меня.
С трудов Тьюринга, Хебба, Розенблатта и Эшби. С исследований пластичности, нейрофизиологии, обучения с подкреплением, стохастических процессов и динамических систем. С десятилетий работы людей, стремившихся понять, как нервная система связывает действия с их последствиями.
Поэтому я не стану объявлять себя изобретателем спайковых сетей или человеком, разгадавшим природу интеллекта.
Я лишь поставил собственный вопрос и проявил достаточно упорства, чтобы экспериментально проверить несколько возможных ответов.
SE7EN запомнит.
А теперь продолжим.
Что меня не устроило в обычных нейросетях?
Я разработчик и привык к детерминированным системам: вход, вычисление, результат. Каким бы сложным ни был внутренний механизм, его состояние можно проследить, события — зарегистрировать, инварианты — проверить, а время выполнения — измерить.
Но однажды меня заинтересовало фундаментальное различие между вычислением и обучением.
Рассмотрим обычную функцию:
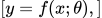
где (x) — входные данные, (\theta) — параметры, а (y) — результат.
Эту функцию можно усложнять почти бесконечно: добавлять слои, механизмы внимания, рекуррентные связи и внешнюю память. В результате система способна демонстрировать чрезвычайно сложное и полезное поведение.
Однако меня интересует не только функция (f).
Мне важно понять, как возникают и меняются её параметры.
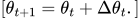
Что должно определять изменение параметров?
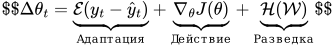
Признаюсь, я немного пьян и устал, но здесь через интерференцию можно разложить и другую формулу:
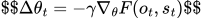
Или рассмотреть задачу через классическое обучение с подкреплением:
Что происходит, если система существует в неизвестном мире, действует в нём, изменяет его и наблюдает последствия? Впрочем, это всё нам уже знакомо — не будем задерживаться на очевидном.
Может ли она использовать накопленный опыт так, чтобы в следующем неизвестном мире ей не пришлось обучаться заново?
Это уже не сводится к аппроксимации функции.
Речь идёт о прижизненной адаптации воплощённой динамической системы.
Я не утверждаю, что распространённые методы машинного обучения не справляются с подобными задачами. Справляются, и весьма успешно. Но меня интересует конкретное направление: обучение спайковой нервной системы при непрерывном взаимодействии с собственным телом и окружающей средой.
Так появился Z3R0 — Artificial Neural Organism.
От мембранного потенциала к движению
В одной из основных экспериментальных конфигураций Z3R0 используются 256 искусственных нейронов типа LIF — Leaky Integrate-and-Fire.
У каждого нейрона есть мембранный потенциал (V_j): он накапливает входящие воздействия и постепенно затухает.
Дискретная динамика модели описывается следующим выражением:
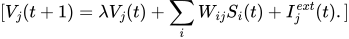
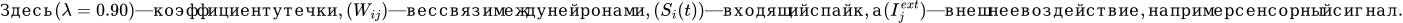
Когда потенциал мембраны достигает заданного порога (V_{th}=1.0), нейрон генерирует спайк:
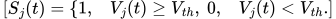
Затем потенциал сбрасывается.
Даже на этом уровне появляются интересные свойства: пороговая нелинейность, накопление и затухание сигналов во времени, зависимость активности от предыдущего состояния.
Но мне хотелось создать не просто очередной симулятор нейронов.
Поэтому я дал сети тело.
Организм получил две хемосенсорные антенны, двигательные органы и непрерывную двумерную арену с источником пищи.
Чувствительность каждой антенны задавалась функцией:
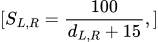
где:

— расстояние от соответствующего рецептора до источника.
Движение тела описывается кинематическими уравнениями:
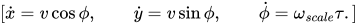
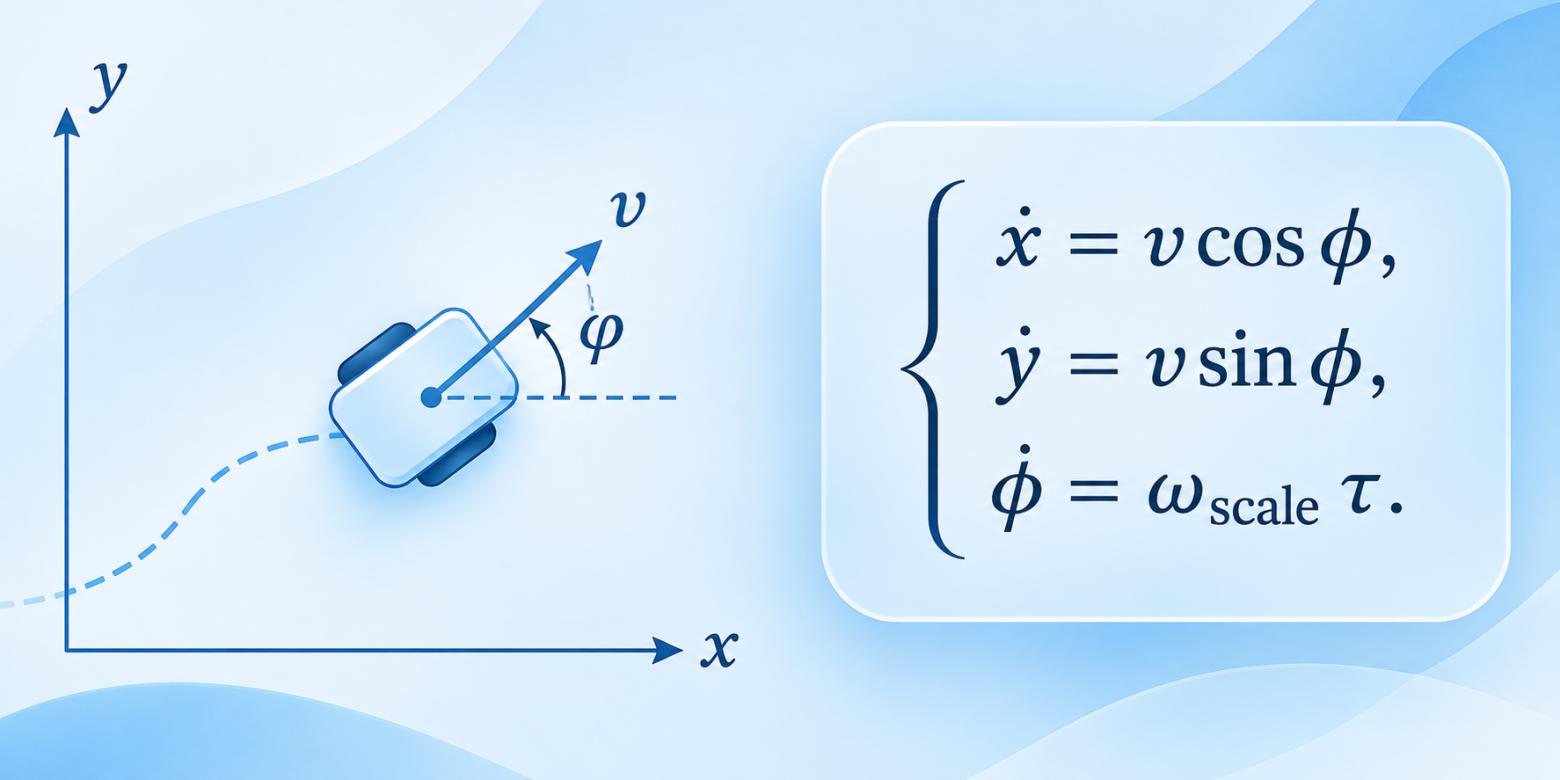
Поворотный момент определяется разностью управляющих воздействий левого и правого моторов:
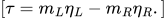
Здесь

— эффективность физических приводов. Почему это так трудно объяснить?
И вот главное: нейросеть больше не решает статическую задачу классификации.
Её выход теперь меняет положение тела. Положение влияет на показания рецепторов, а новые сигналы снова поступают в сеть.
Получается замкнутый контур:
Рецепторы → нейронная сеть → моторы → физическое тело → среда → рецепторы.
Состояние организма определяется не только текущим входом, но и всей предыдущей траекторией взаимодействия.
Перед нами задача управления динамической системой с обратной связью.
Именно в таких условиях я и хотел наблюдать обучение.
Почему SPORE был для меня так важен
Один из первых вопросов, с которым я столкнулся: что вообще значит «синапс учится»?
В простейшем случае можно воспользоваться правилом Хебба:
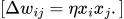
Активность передающего и принимающего нейронов определяет изменение силы связи. Но усиление коррелированной активности само по себе не показывает, было ли вызванное ею поведение полезным.
Можно добавить третий фактор — модулирующий сигнал, функционально аналогичный подкреплению. Можно, конечно, его проигнорировать, но тогда результаты начинают ухудшаться.
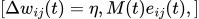
где

— локальный след активности,

— сигнал, влияющий на обучение.
Это позволяет связывать локальные нейронные события с их внешними последствиями.
Но возникает трудность: если награда поступает через несколько шагов после действия, какой именно синапс должен получить положительное обновление?
И сколько синапсов следует «наказать», если организм не достиг цели?
SPORE интересен мне именно тем, что в нём исследуется обучение спайковых сетей с помощью подкрепления и стохастической синаптической пластичности.
При стохастическом подходе обновление параметров может одновременно включать направленное воздействие целевой функции, априорное ограничение и случайную диффузию.
В общем виде такую динамику удобно записать так:
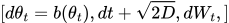
где:

— направленный дрейф параметров, (D) — интенсивность диффузии, а (W_t) — винеровский процесс.
Это принципиально отличается от представления о нейросети как о статичной матрице раз и навсегда обученных весов.
Синапсы могут меняться и дальше.
Однако непрерывные изменения сами по себе ещё не означают обучения.
Случайное блуждание — не интеллект.
Чтобы адаптация приносила пользу, изменения должны статистически улучшать поведение системы в интересующей нас среде.
Именно это обстоятельство стало решающим для всего моего исследования.
e-prop и проблема распределения ответственности
Ещё одно изученное мной направление — eligibility propagation, или e-prop.
В рекуррентной нейросети результат действия зависит от множества состояний, распределённых во времени.
Возникает вопрос: как вычислять полезное изменение параметров, не сохраняя всю историю динамики и не распространяя ошибку обратно через неё целиком?
Одна из ключевых идей e-prop — разложение градиента на локальные следы пригодности и обучающие сигналы:
![\sum_t L_j(t)e_{ji}(t), ]](https://habrastorage.org/getpro/habr/formulas/f/fc/fc4/fc4c7dceb6a4870f69f3116501772526.svg)
где

характеризует локальную чувствительность нейронной динамики к параметру, а

— обучающий сигнал. При точном обучающем сигнале такое разложение позволяет представить градиент; практические реализации e-prop используют приближения, доступные во время работы сети.
Здесь меня интересует не столько сама производная, сколько вопрос философского характера.
Как локальный элемент системы получает информацию о глобальном результате?
Нейрон не наблюдает всю траекторию тела.
Синапс не знает, где находится источник пищи.
Мотору неизвестно, насколько полезной окажется команда через десять шагов.
И всё же системе необходимо как-то распределить ответственность за результат между огромным числом локальных событий.
Это не риторический вопрос.
Это вполне конкретная математическая задача.
И Z3R0 дал мне возможность исследовать её на физически интерпретируемом примере.
Я повредил тело своего организма
Сначала я смоделировал неисправность одного из моторов.
Например:

Левый привод стал слабее правого.
На первый взгляд нейросеть должна была освоить новый навык компенсации.
Однако контрольные испытания выявили неприятную особенность.
В 4000 независимых миров базовая сеть достигала успеха в 40,1% случаев с исправным телом и в 39,3% — при ослаблении одного мотора.
Разница составила всего 0,8 процентного пункта.
Выяснилось, что существующий сенсомоторный контур уже частично компенсировал повреждение за счёт обратной связи.
Тогда я понял, что допустил фундаментальную ошибку при постановке задачи.
Невозможно доказать приобретение нового навыка, если исходный навык почти не пострадал.
Эксперимент пришлось изменить.
Я поменял моторные команды местами.
Вместо обычного момента:
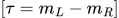
получился:
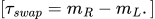
Теперь привычное управление действовало наоборот.
У одной базовой сети успешность снизилась с 40,1% до 10,4%.
Вот это уже был полноценный стресс-тест способности к адаптации.
Но прежде чем ожидать обучения, я решил проверить ещё один важный вопрос.
Есть ли вообще полезное решение в доступном пространстве синаптических весов?
Я заморозил внутреннюю нейросеть и применил внешний метод Evolution Strategies для поиска весов связей, ведущих к моторным нейронам.
Вес параметризовался через ограниченную координату:

Такая параметризация сохраняет исходный знак ненулевой связи и ограничивает изменение её абсолютной величины приблизительно множителями от 0,301 до 3,320.
Для одного организма внешняя оптимизация повысила успешность после Swap с 10,4% до 33,2%.
В группе из десяти организмов средняя успешность найденных ES-конфигураций составила 44,68% против 24,18% у исходных замороженных сетей.
Это не абсолютный теоретический предел и не доказательство способности к самостоятельному обучению.
Но эксперимент выявил важную вещь: в проверенном ограниченном пространстве параметров существуют конфигурации, которые позволяют значительно лучше управлять повреждённым телом.
Иными словами, проблема заключалась не в отсутствии допустимых полезных весов.
Оставалось самое сложное.
Научить организм находить их самостоятельно.
SMSS: когда красивое уравнение ещё не означает интеллект
Опираясь на изученные подходы, я экспериментировал с Motor Synaptic Sampling — SMSS.
В выбранной конфигурации к моторной предактивации добавляется гауссово возмущение:
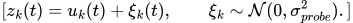
Затем моторная команда проходит через сигмоидальную функцию:
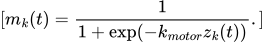
Для гауссовой политики по зашумлённой предактивации score-function даёт:
![\frac{\xi_k}{\sigma_{probe}^2} \frac{\partial u_k}{\partial\theta_i}. ]](https://habrastorage.org/getpro/habr/formulas/5/52/524/5247fc59fadbdca7e8bd1c2c6a2904b6.svg)
Таким образом формируются синаптические следы, связывающие параметры моторного считывателя с исследовательскими возмущениями.
Накопленный сигнал применяется для обновления параметров. В нашей реализации это обновление объединяет градиентный компонент, априорный якорь и шум Ланжевена:
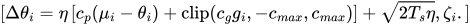
Здесь

— оценка обучающего градиента по накопленным следам,

— параметр интенсивности стохастического сэмплирования,

— стандартный нормальный шум.
С математической точки зрения подход интересен.
Однако я снова возвращаюсь к главному.
Присутствие обучающего сигнала в уравнении ещё не доказывает, что обучение приносит пользу.
Поэтому я провёл контрольные испытания: замороженные веса, сэмплирование без градиента, полноценный SMSS и отдельная внешняя оптимизация ES.
После 200 эпизодов индивидуальной жизни десяти организмов результаты оказались такими:
|
Метод |
Успешность |
|---|---|
|
Frozen |
24,18% |
|
Zero-Gradient |
23,62% |
|
Full SMSS |
22,02% |
|
Конфигурации, найденные ES |
44,68% |
Разница между SMSS и Zero-Gradient составила −1,60 процентного пункта. Парный статистический тест дал результат (p\approx0.098).
Убедительных свидетельств того, что обучающий компонент SMSS в этой конфигурации превосходит контроль без градиента, мы не получили.
И я не намерен выдавать это за победу.
Синаптические веса действительно менялись.
Но восстановить навык при жизни организма в проверенном режиме нам не удалось.
Я мог бы выбрать несколько удачных траекторий, рассказать о пластичности, добавить красивую визуализацию нейронов и объявить, что искусственный организм научился приспосабливаться к повреждённому телу.
Но тогда я перестал бы исследовать интеллект.
Вместо этого я исследовал бы собственное желание его обнаружить.
Что я понял за годы работы
Я понял, что в нейроморфных исследованиях недостаточно построить нейроны, генерирующие спайки. Недостаточно реализовать правило Хебба, добавить дофамин или случайно менять веса и получить улучшение в нескольких эпизодах.
Необходимо отличать корреляцию от причинности, случайность — от направленного поиска, а устойчивость готового контроллера — от приобретения нового навыка.
И главное — нужно уметь показать, что конкретный механизм обучения создаёт эффект, который не возникает без него.
Именно для этого и нужны контрольные группы.
Когда моя гипотеза не прошла проверку, я получил не эффектный ответ о происхождении интеллекта, а гораздо более скромный вывод: для выбранного организма, физической задачи и алгоритма одного добавления стохастической синаптической пластичности оказалось недостаточно.
Это не опровергает ни SPORE, ни e-prop, ни локальное обучение и тем более не даёт окончательного ответа о природе интеллекта.
Это ограниченный отрицательный результат моей собственной реализации, воспроизводимый в рамках описанного протокола.
И для меня он важен.
Потому что я больше не хочу заменять отсутствие ответа красивой гипотезой.
Теперь меня занимает следующий вопрос: если организм не способен эффективно определить последствия собственных моторных возмущений по одному только отложенному подкреплению, сможет ли он научиться их предсказывать?
Например:
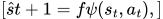
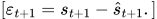
Здесь =):

— внутренняя предиктивная модель, а

— ошибка между ожидаемым и фактическим сенсорным состоянием.
Такая архитектура могла бы предоставить системе дополнительные сведения о том, как её собственные действия меняют мир. Однако даже точный предсказатель сам по себе не гарантирует более эффективного управления. Это новая гипотеза, которую ещё предстоит проверить, а не уже полученный результат.
Теперь каждый эксперимент я начинаю именно с разграничения возможного, предполагаемого и доказанного.
Я не знаю, где начинается интеллект.
Не знаю, достаточно ли для него памяти, пластичности, предсказания, внутренней модели тела или требуется нечто иное.
Не знаю, может ли небольшая спайковая сеть стать основой более универсального обучающегося организма.
Но одно я знаю точно: если однажды замечу в Z3R0 поведение, которого не предвидел, первым делом я попытаюсь опровергнуть своё объяснение.
Отключу обучение.
Перемешаю сигналы.
Заморожу веса.
Изменю начальные состояния.
Проверю независимые среды.
Поищу самое простое альтернативное объяснение.
И лишь если эффект выдержит эти испытания, я позволю себе назвать его приобретённым навыком.
Мне не нужен искусственный интеллект, в существовании которого я убедил только самого себя.
Я хочу найти тот, чьё существование смогу доказать.
Спасибо всем, кто занимается этой наукой. Спасибо авторам SPORE, e-prop, NEST, BindsNET, Brian2, Norse и множества других работ, до которых я ещё не успел добраться.
Но это не делает проведённые эксперименты бессмысленными.
Я продолжаю работу не потому, что уверен в победе.
Я продолжаю, потому что хочу узнать ответ.
Спасибо, что прочитали.
Артур Валиев, EVERTY.
За мечтателей! =)
Похожие статьи
 Растения и животные мира под чёрным солнцем
 НАСА подписало контракты на транспортные, технологические и научные проекты для лунной базы
 Кто открыл тёмную материю: Фриц Цвикки или Вера Рубин?
 В кадре весь класс, но слушаться надо учителя: как M2 распознаёт свои руки среди чужих
 Я воспроизвёл литиевую проблему космологов, смоделировав первые 400 тысяч лет существования Вселенной
 Во сколько обходится создание ИИ?
 Создаём лабораторного помощника на локальной Qwen 3.8 с 16 ГБ видеопамяти
 НАСА открыло приём заявок в новый отряд астронавтов