Анатомия кодов: как устроены штрихкод, QR и Data Matrix
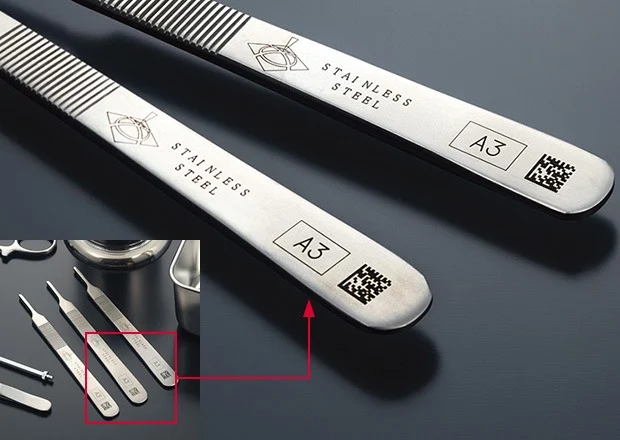
DataMatrix на медицинских инструментах
Несколько десятков темных линий некогда перевернули глобальную торговлю: кассирам больше не требовалось вручную вбивать стоимость каждого продукта, а магазины впервые получили инструмент автоматического складского учета. Со временем полосы превратились в квадраты, емкость носителей выросла в разы, а поврежденные коды научились самовосстанавливаться по уцелевшим фрагментам. Сферы применения давно вышли за рамки ритейла, охватив логистику, здравоохранение, маркетинг и множество других индустрий. Давайте разберем эволюцию линейных штрихкодов, QR-кодов и Data Matrix, выясним их различия и функционал.
И самое главное — почему на пакетах с молоком красуется именно Data Matrix? Ответы ждут вас далее.
Просканируй это!
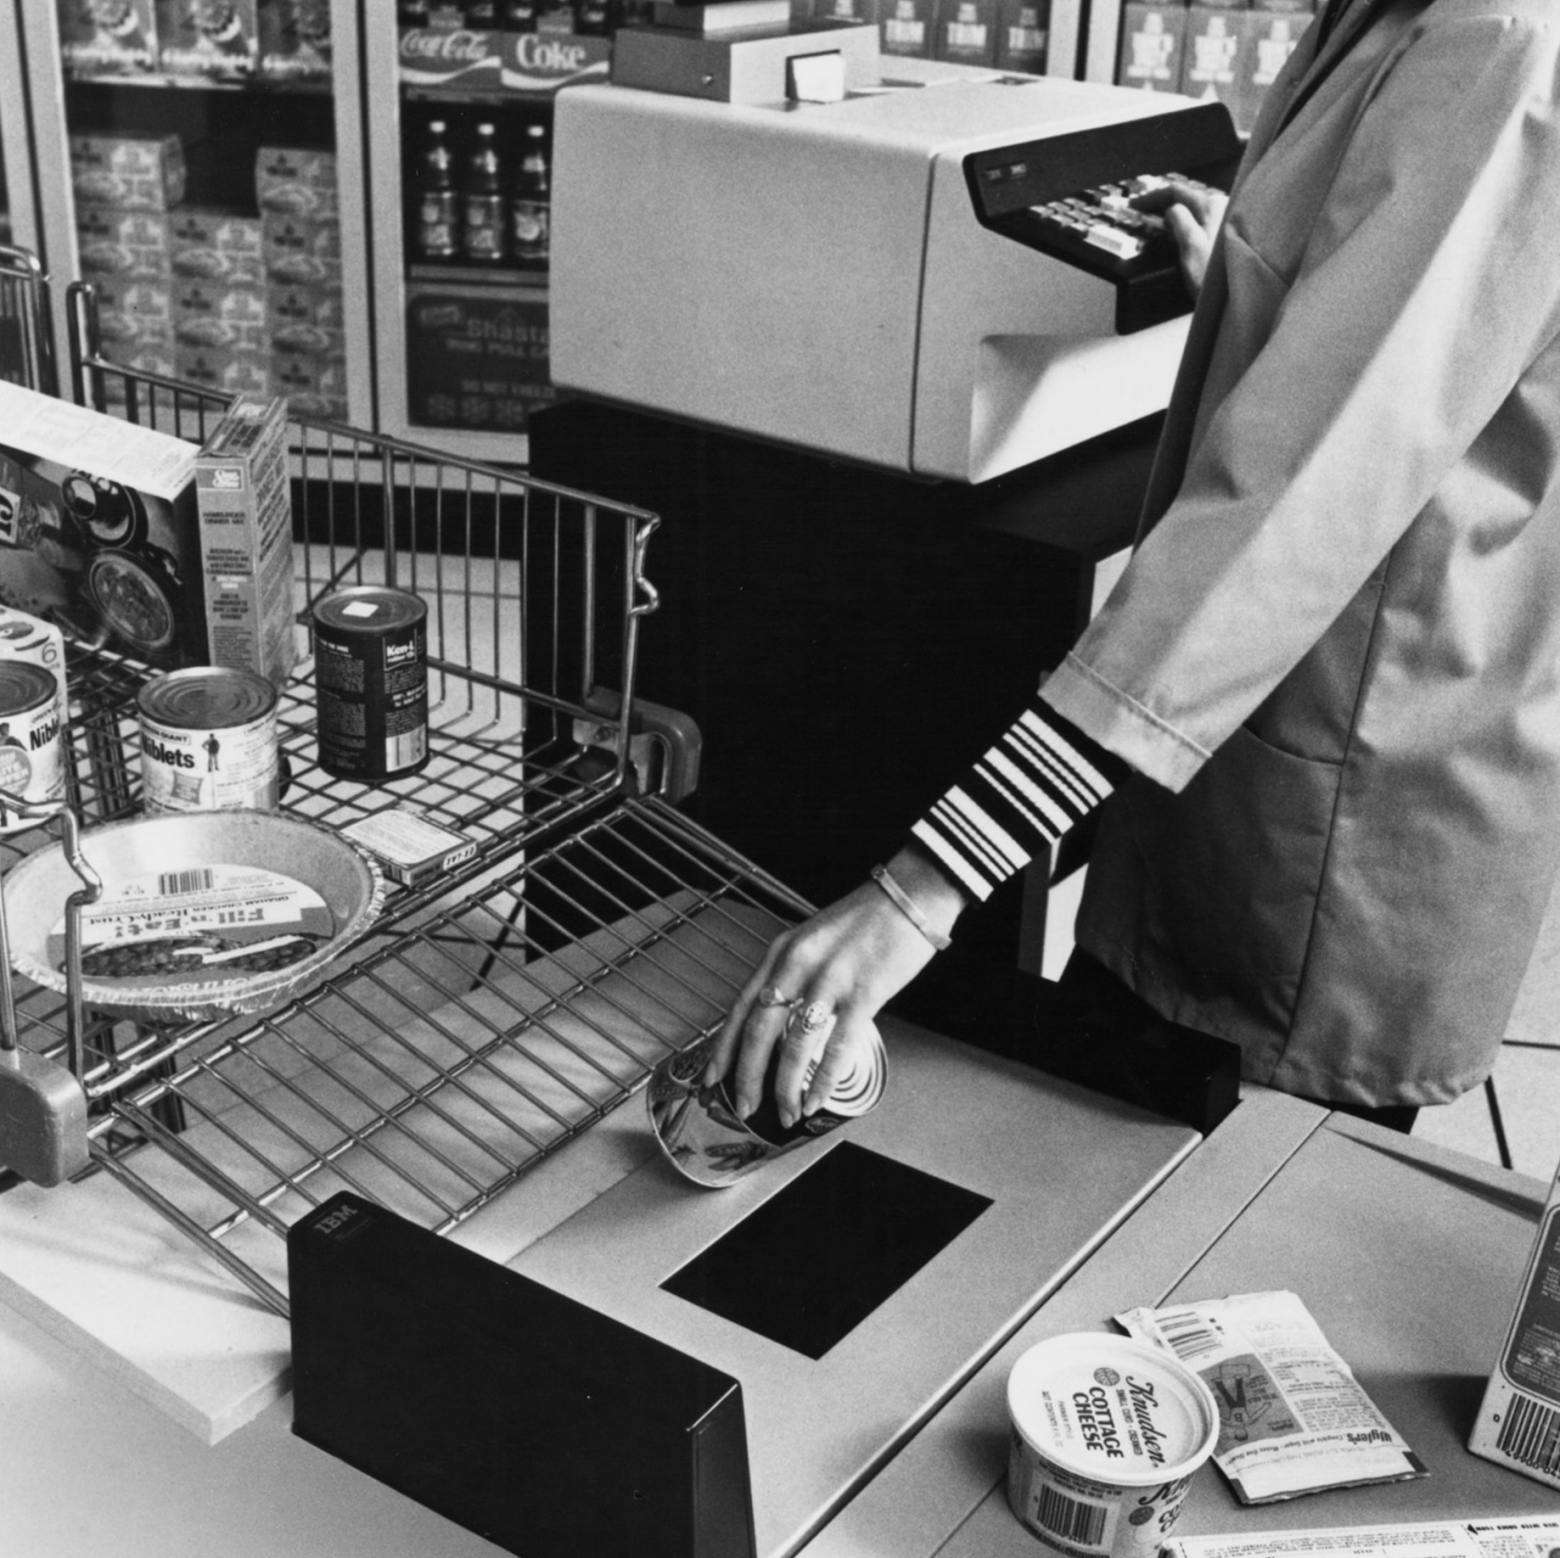
Каноническая дата отсчета — 26 июня 1974 года, ровно 8:01 утра. Супермаркет Marsh в Трое, штат Огайо: кассир Шэрон Бьюкенен, специалист по R&D Клайд Доусон и блок из десяти пачек жевательной резинки Juicy Fruit за 67 центов. Так состоялось первое в истории сканирование UPC-кода на кассе. Вопреки популярному мифу, та самая пачка не осела в музее — ее оставил себе Доусон. Зато в Смитсоновском институте бережно хранятся другой аналогичный блок Wrigley’s и один из прародителей сканеров.
Скрытый текст
UPC (Universal Product Code) — двенадцатизначный североамериканский стандарт штрихкодирования, задействованный для товарного учета в магазинах и каталогизации музыкальных релизов на стримингах.
Секунду. Успешный дебют UPC зафиксирован тогда, но экспериментальные автоматизированные кассы со считывателями штрихкодов тестировались и раньше. Еще 3 июля 1972 года торговая точка сети Kroger Kenwood Plaza в Цинциннати запустила аппаратный комплекс RCA (Radio Corporation of America). Правда, кодировка там была круглой — знаменитый «бычий глаз» из патента Вудланда и Сильвера, состоящий из концентрических окружностей разной толщины.
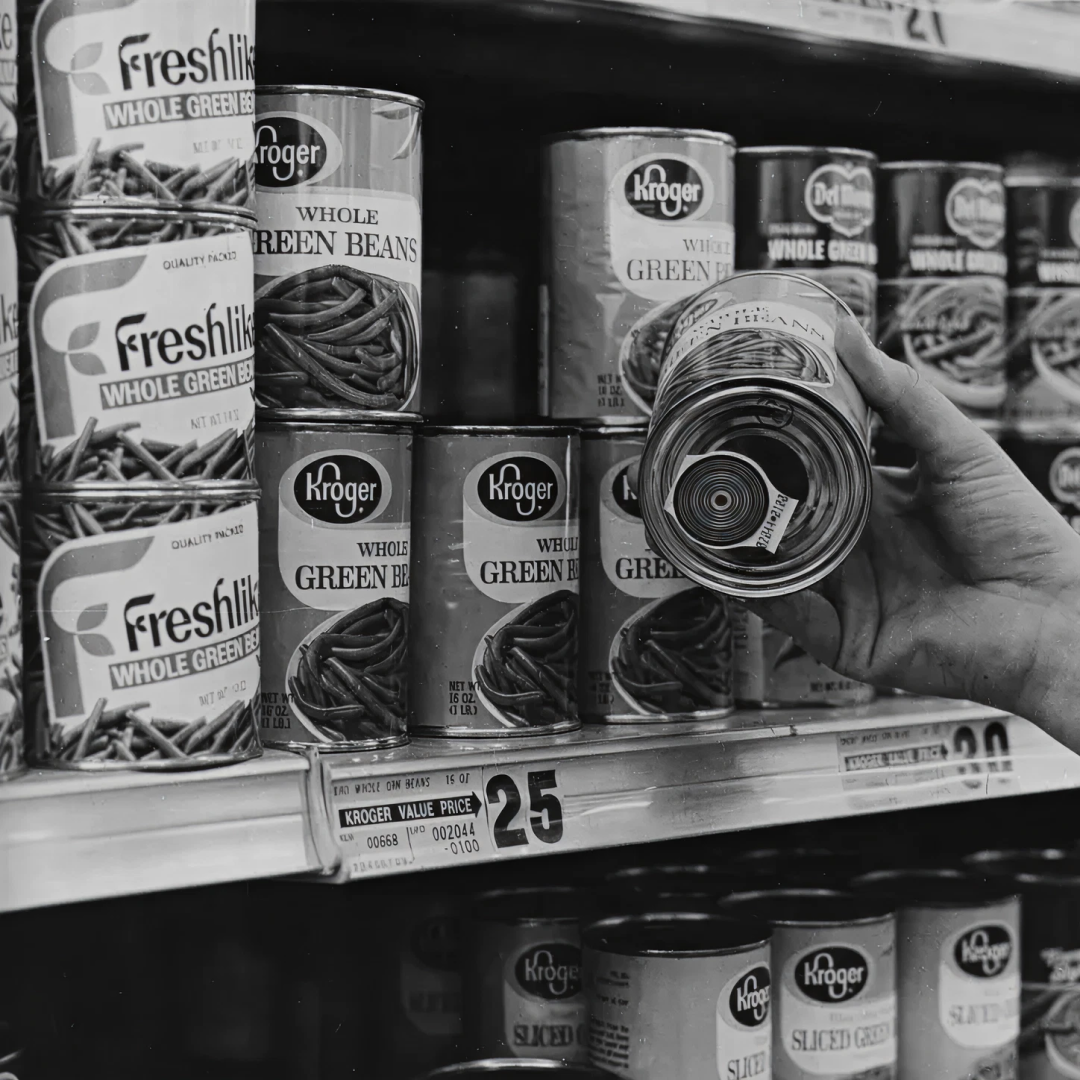
Почему же эта технология не прижилась? В 1973 году отраслевой консорциум выбирал универсальный стандарт символики для американского ритейла, и RCA с ее круговой мишенью, прошедшей полевые испытания, выглядела бесспорным фаворитом. Окружность считывалась под любым углом — ради этого Вудланд ее и разработал. Однако триумфатором в итоге стал прямоугольный патч от IBM, спроектированный Джорджем Лорером, который мы сегодня и называем привычным штрихкодом. В чем причина?
Разгадка кроется в несовершенстве печатных станков той эпохи. Тогдашнее оборудование грешило тем, что размазывало краску по ходу движения бумажного полотна.
При подобных дефектах круговой символ неизбежно деформировался в овал, радиальная толщина колец искажалась, делая код нечитаемым. Вертикальные же полосы при аналогичном браке просто удлинялись по вертикали, так как излишки краски стекали вверх или вниз. Линии становились выше, но их ширина оставалась неизменной ни на микрон. Лорер позднее подчеркивал в мемуарах, что обеспечить необходимые технологические допуски при печати круговых кодов было практически нереально.
Что касается информационной емкости, то заказчики требовали строго десять цифр — ни больше ни меньше, по расчетам привлеченных экспертов. Все остальное относилось к служебным нуждам: символ должен был наноситься стандартными упаковочными станками, занимать не более полутора квадратных дюймов с учетом цифр и допускать максимум одну ложноположительную ошибку на 20 000 сканирований.
В сухом остатке, победу штрихкоду обеспечили технологические ограничения полиграфии той поры.
Штриховой код наших дней
Перенесемся в современность. Общепринятый формат EAN-13, красующийся на любом отечественном товаре, состоит из 13 цифр — например, 4601234567893. Каким образом зашифрована эта последовательность?
Структура штрихкода насчитывает 95 модулей — минимальных вертикальных полос единичной ширины, окрашенных либо в черный, либо в белый цвет. Компоновка выглядит следующим образом: 3 стартовых модуля защитной комбинации слева (черный-белый-черный), 42 модуля под первую шестерку цифр, 5 модулей центрального разделителя, еще 42 модуля под правую шестерку и 3 завершающих модуля справа. Суммируем: 3 + 42 + 5 + 42 + 3 = 95.
На каждую цифру отводится ровно семь модулей. Возникает закономерный вопрос: раз на цифровые блоки выделено 84 модуля, то где же прячется 13-я цифра? Делим 84 на 7 и получаем 12. Этот нюанс мы запомним, он крайне важен.
Было бы заблуждением полагать, что кодировка каждого знака неизменна. Существует не один, а три вариативных метода кодирования: A, B и C. Набор A содержит нечетное количество черных модулей для каждого знака, набор B — четное, а набор C представляет собой банальный инверсивный негатив набора A.
К примеру, цифра «шесть» в палитре A кодируется как 0101111: пробел, линия, пробел и утолщенная полоса в четыре модуля. В наборе C мы увидим 1010000 — ту же конфигурацию, но с инверсией цветов. Набор B воспроизводит 0000101, что зеркально повторяет последовательность C в обратном порядке.
Зачем понадобилась столь изощренная криптография? Какой гений шифрования это спроектировал?
Весь секрет в том, что правый блок из шести цифр всегда формируется таблицей C. А вот левая шестерка генерируется комбинацией таблиц A и B, причем именно порядок их чередования и задает ту самую заглавную, тринадцатую цифру. Для нуля все левые знаки берутся из набора A (именно поэтому классический американский 12-значный UPC-A является прямым подмножеством EAN-13). Для нашего примера с четверкой последовательность выглядит так: A B A A B B.
Сканирующее устройство считывает левые шесть символов, анализирует четность темных модулей в каждом из них и по полученному паттерну извлекает из внутренней таблицы ту самую первую цифру, которой физически нет на упаковке. Она как бы размазана по паритету остальных знаков.
У этого инженерного решения есть и второй важнейший плюс. Поскольку слева задействованы наборы A и Б, а справа — исключительно C, считыватель по первому же распознанному знаку безошибочно определяет ориентацию кода. Товар перевернули вверх тормашками? Считается. Протянули сканер справа налево? Тоже распознается. А всенаправленное сканирование на кассе достигается за счет увеличенной высоты штрихов и многолучевой оптики, которой паритет подсказывает вектор прочтения. Стоит подрезать высоту штрихов ради экономии места в макете, как кассовый сканер тут же начнет сбоить.
Для абсолютной надежности предусмотрена контрольная сумма. Алгоритм ее расчета таков: берем первые 12 цифр нашего примера (4 6 0 1 2 3 4 5 6 7 8 9). Каждую вторую цифру, начиная со второй позиции, умножаем на 3, остальные оставляем в первозданном виде, после чего суммируем результаты.
Складываем знаки с нечетных позиций (1-я, 3-я, 5-я и т.д.): 4 + 0 + 2 + 4 + 6 + 8 = 24.
Суммируем четные позиции: 6 + 1 + 3 + 5 + 7 + 9 = 31, умножаем на тройку и получаем 93.
Общая сумма: 24 + 93 = 117. Теперь определяем, сколько не хватает до ближайшего числа, кратного десяти. Ближайшее сверху — 120, разница составляет 3. Эта тройка и становится контрольным разрядом. Если бы итоговая сумма изначально равнялась, скажем, 120, контрольной цифрой стал бы ноль.
Сканирующий аппарат дублирует эту арифметику: 117 + 3 = 120, делится на 10 — считывание прошло успешно. Не делится — произошел сбой, процедуру нужно повторить. Подобная верификация успешно выявляет любую одиночную ошибку чтения и почти любую перестановку соседних знаков. Слово «почти» здесь ключевое: если поменять местами цифры, разница между которыми составляет ровно 5, контрольный сумматор не изменится. Это уязвимость EAN-13, хотя вероятность столкнуться с ней на практике невелика.
Скрытый текст
Специфика штрихкодов базируется на элементарной, но неочевидной математике. Вернемся к нашему примеру: возьмем соседние цифры 1 и 2 (позиции 4 и 5). Согласно правилу умножения каждой второй на 3, единица обладает весовым коэффициентом 3, а двойка — единицей. В сумме они дают 1*3 + 2*1 = 5. Поменяем их местами: теперь тройка умножается на двойку, а единица — на единицу (2*3 + 1*1 = 7). Итоговая сумма изменилась на 2, потеряв кратность десяти, и сканер немедленно фиксирует ошибку. Все работает.
А теперь возьмем пару соседей 2 и 7. По правилу: 2*3 + 7*1 = 13. Меняем местами: 7*3 + 2*1 = 23. Разница между результатами составляет ровно 10. Поскольку алгоритм проверяет лишь кратность суммы числу 10, этот избыточный десяток остается незамеченным. Искаженный код с переставленными двойкой и семеркой успешно пройдет проверку на подлинность.
Двигаемся дальше
Итак, что же зашито в этих 95 модулях? Исключительно цифровой идентификатор. Внутри скрывается префикс компании в системе GS1 плавающей длины, артикул изделия и контрольный символ. При этом префикс включает код национальной организации GS1 и персональный идентификатор производителя, поэтому четкой границы между «кодом предприятия» и «кодом товара» не существует.
Важная ремарка: префикс вовсе не указывает на страну происхождения товара, как многие ошибочно полагают. Диапазон 460–469 означает лишь то, что комбинация выдана российским представительством ассоциации GS1 — организацией «ЮНИСКАН». Иные трактовки — миф.
К слову, «ЮНИСКАН» прошел официальную регистрацию в Моссовете 22 марта 1991 года. Издание «Коммерсантъ» опубликовало тогда примечательную заметку под заголовком «Штрих-коды в СССР: заплатите нам 300 долларов, и мы наставим вам палок». Присвоение фирменного кода предприятию действительно стоило триста американских долларов; до этого момента интересы СССР в европейской структуре EAN представляла исключительно Торгово-промышленная палата. Массовая раздача идентификаторов отечественным фабрикам и заводам пришлась на закат Советского Союза, хотя членство в EAN страна имела и ранее.
Поскольку штрихкод содержит лишь уникальный номер, у супермаркетов есть хитрая лазейка. Диапазоны кодов GS1 с 20 по 29 зарезервированы под внутренние нужды предприятий: регламенты для них устанавливают национальные офисы, и за пределы локальных сетей такие номера не выходят. Как правило, их используют для весового товара внутри конкретного ритейлера. Именно поэтому ценник на весовых конфетах или салатах начинается с двойки: торговая сеть самостоятельно кодирует в нем номенклатурный номер, а также точную массу или стоимость продукта.
Стоит упомянуть префикс 977, зарезервированный под периодику (стандарты ISSN), а также 978 и 979, отданные книгоиздателям.
Супермаркетный бунт
Раз в структуре штрихкода отсутствует цена, откуда она берется в фискальном чеке? Из внутренней базы данных магазина. Касса отправляет зашифрованный номер товара, сервер моментально возвращает актуальную стоимость. Сегодня эта схема кажется банальной и самоочередной, но в 1974 году она спровоцировала настоящий социальный кризис.
Дело в том, что до эпохи сканеров ценник наклеивался вручную на каждую единицу продукции. Торговые предприятия горели желанием избавиться от этой повинности: переоценка товаров при малейшем изменении прайса съедала колоссальные бюджеты, и разработчики обещали инвесторам ликвидировать эту статью расходов. Общества защиты прав потребителей уловили подвох мгновенно и подняли бунт: сегодня касса считывает код, а завтра ценники исчезнут с банок вовсе. И ведь действительно исчезли бы, если бы не сопротивление масс.
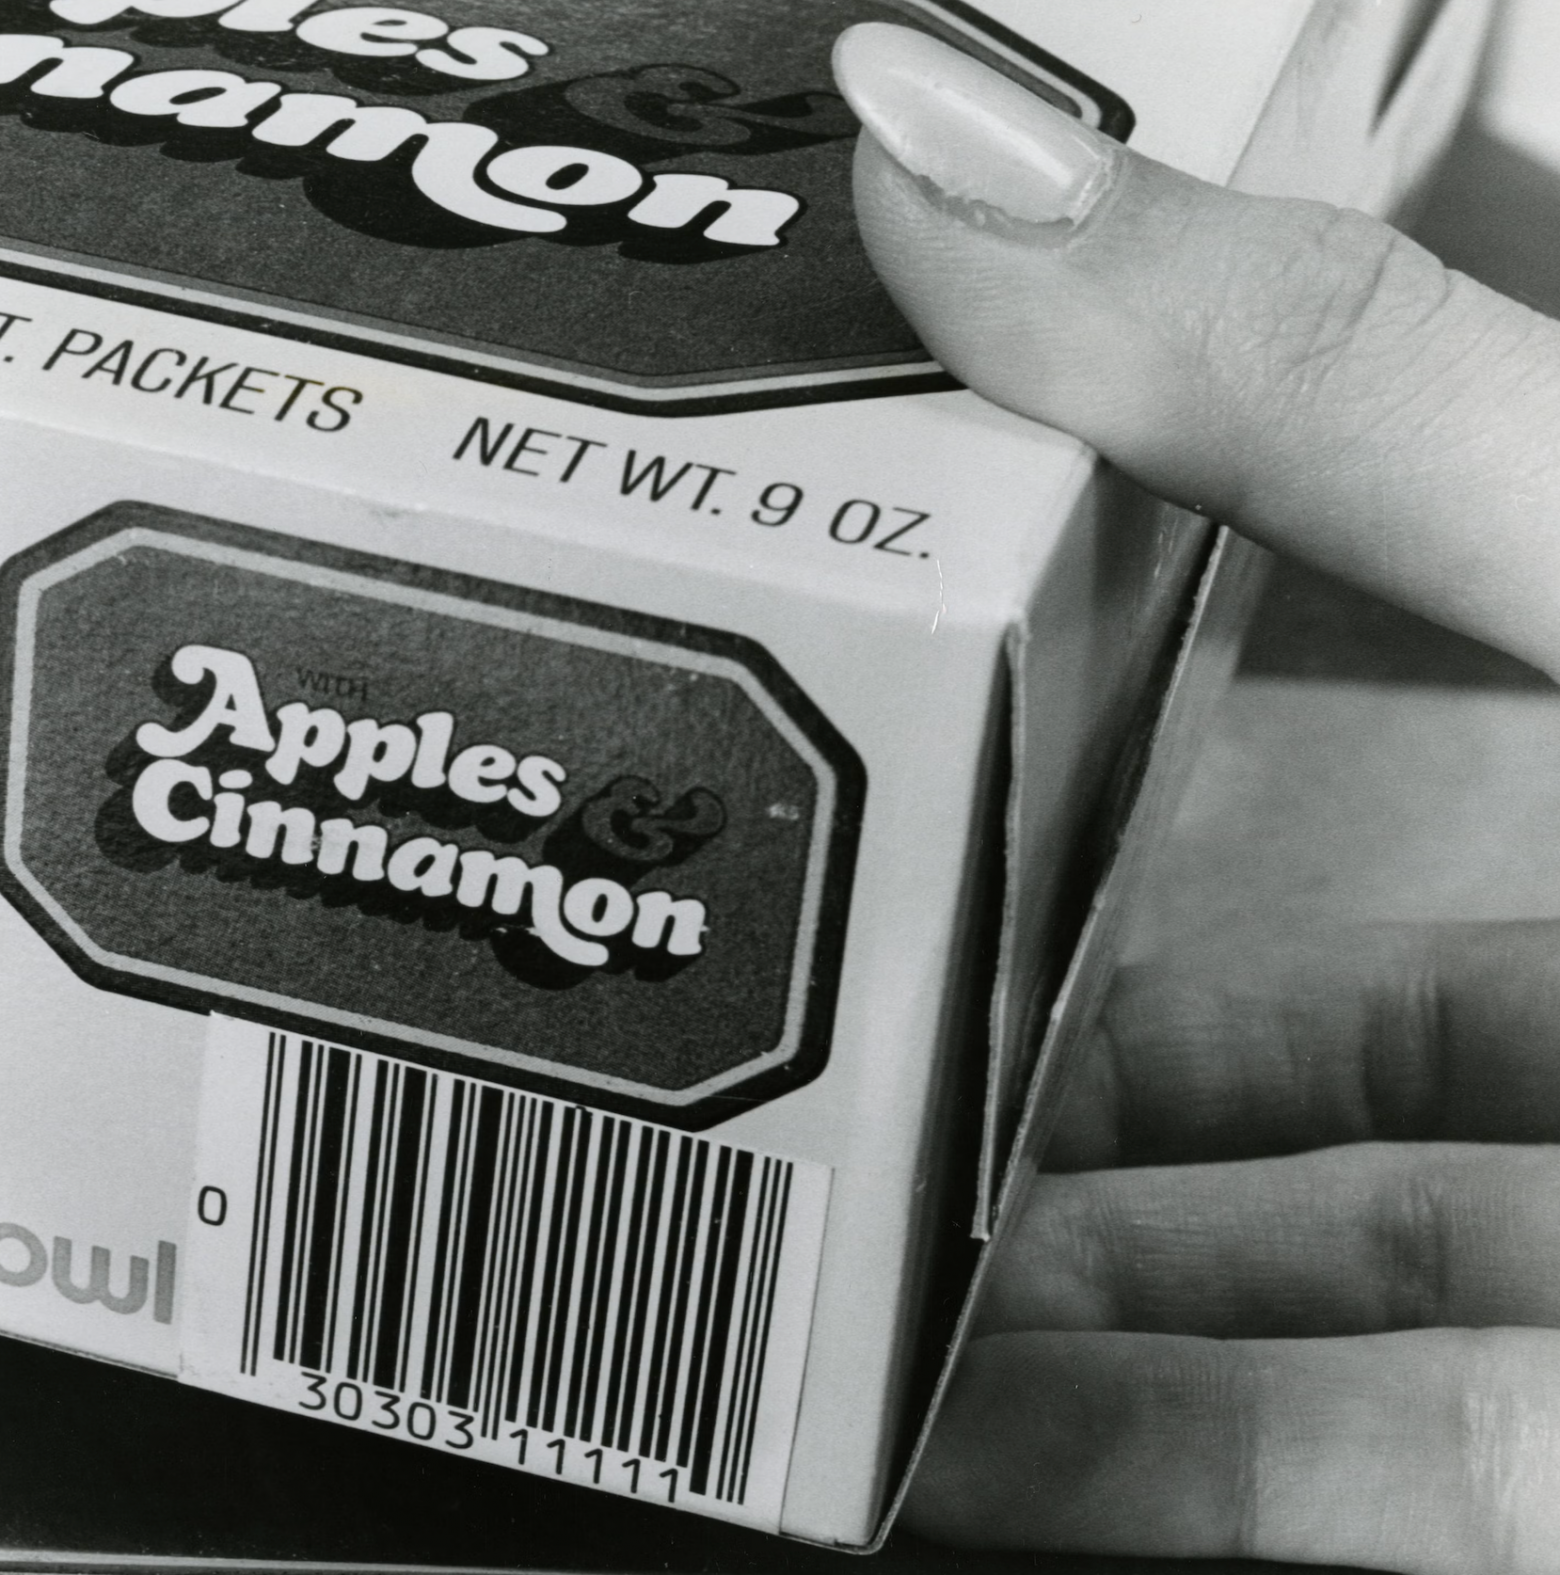
Дальнейшее развивалось по классическому сценарию. Летом 1974 года тема стала главным сюжетом ток-шоу Фила Донахью, в декабре Сенат США созвал специальный симпозиум по универсальным товарным кодам, а у входов в открывающиеся магазины дежурили пикетчики. К марту 1978 года уже в шести американских штатах приняли законодательные акты, обязывающие магазины дублировать цену на каждой упаковке независимо от наличия сканеров.
Права покупателей отстояли, сэкономить на ручной переклейке ценников ритейлерам не удалось. Однако практичность полосатого маркета была очевидна. В 1978 году сканирующее оборудование стояло менее чем в 1% продовольственных магазинов США. К середине 1981-го этот показатель вырос до 10%, а к 1984 году достиг трети торговых точек.
Помимо ускорения расчетов на кассе, штрихкоды принесли неожиданные дивиденды в сфере аналитики. В 1999 году аудиторская компания PwC оценила совокупный годовой экономический эффект от внедрения UPC в продуктовой индустрии США в 17 миллиардов долларов. Прогнозы же разработчиков из 1970-х скромно варьировались от 40 миллионов до полутора миллиардов. Откуда взялась такая пропасть? Ответ прост — большие данные.
Уже в январе 1980 года аналитическая фирма IRI запустила сервис BehaviorScan, обрабатывавший массивы кассовой статистики. Магазины приобретали сканеры ради экономии на кассирах, а получили в свое распоряжение беспрецедентный инструмент маркетинговой аналитики. В эпоху цифровой маркировки мы воспринимаем это как должное, но раньше сбор точных рыночных данных был головной болью менеджмента. Теперь же внедрение штрихкодов открыло золотую жилу ценнейшей информации.
Двадцать знаков и тупик
Все шло отлично, но отрасль уперлась в технический предел. Линейный штрихкод масштабируется исключительно в одном измерении — в длину.
Компания Denso, о которой пойдет речь далее, оценивала практическую емкость классического штрихкода примерно в 20 буквенно-цифровых знаков. Конечно, теоретически можно уместить и больше, но физическитипографская этикетка такого монстра просто не вместит.
Первым логическим шагом стало размещение нескольких штрихкодов вертикальной стопкой. Так родились многоуровневые (стековые) коды: Code 49, представленный компанией Intermec в 1987 году, и популярный PDF417 от Symbol (1991). По сути, это те же полосы, только уложенные в несколько этажей, которые лазерный сканер может считывать последовательным движением луча. Но давайте взглянем на задачу с позиции сканирующего устройства.
Лазерный луч не воспринимает изображение целиком, его задача — проанализировать единственную световую линию. Луч скользит по коду, фотодиод фиксирует отражение, выдавая временной электрический сигнал: свет-темно-светно-темно.
Стековые форматы вроде PDF417 были переходным этапом: данные уже распределялись по двум осям, но отдельные строки по-прежнему сканировались построчно лазерным растром. Когда же информация распределяется по плоскости в виде единой матрицы (как в QR или Data Matrix), сканеру требуется принципиально иной приемник — матричная камера. Ей приходится решать совершенно иную задачу: не «где границы штрихов», а «где на этом снимке расположен сам код, каков угол его поворота, где его угловые реперы и каков масштаб сетки».
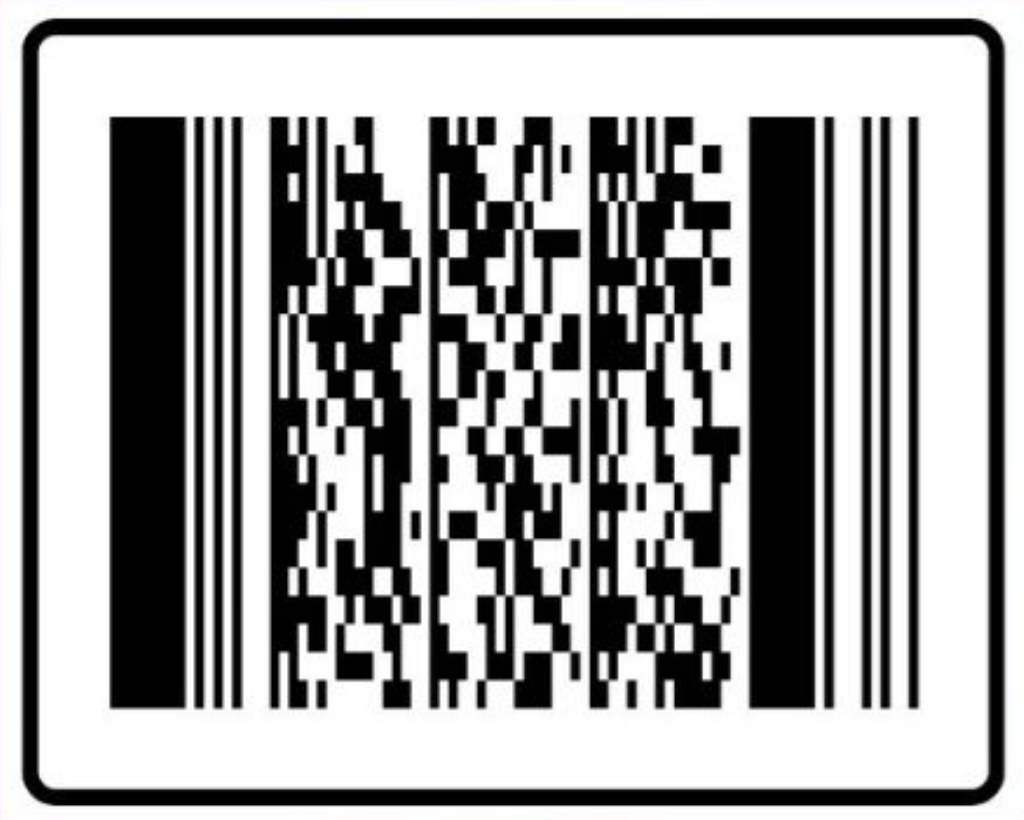
Это была масштабная инженерная проблема. Переход к двумерной координатной сетке кардинально усложнил математику распознавания и потребовал принципиально нового «железа». Тем не менее, это препятствие было успешно преодолено.
Высокоточная маркировка
В начале 1990-х годов на линиях отгрузки автомобильных комплектующих японской компании Denso (ключевого поставщика концерна Toyota) на каждую тару с запчастями приходилось наклеивать до десятка линейных штрихкодов подряд. Каждый — лимитирован двадцятью символами. Масахиро Хара, изобретатель будущего QR-кода, вспоминал, что логистические операции больше напоминали расшифровку клинописи, нежели сборку промышленных узлов. А если коробку случайно пачкали машинным маслом, штрихкод становился нечитаемым наглухо.
Руководство поставило перед инженерами тривиальную задачу: придумать универсальное решение. Требовалось увеличить объем данных (включая поддержку иероглифов), ускорить процесс считывания и обеспечить максимальную стойкость к загрязнениям.
Рабочая группа состояла всего из двух человек, включая самого Хару. Сроки — Хара пообещал шефу уложиться в два года (хотя официальная летопись Denso скромно упоминает полтора); работы стартовали в 1992 году и завершились в марте 1994-го.
Изначально инженеры склонялись к идее многоэтажного штрихкода. Однако Хара был страстным поклонником настольной игры го. Партии за обеденным перерывом навели его на мысль отказаться от громоздких полос в пользу черных и белых фишек на игровой сетке. Именно так следовало структурировать информацию — матричная компоновка оказалась намного проще и эффективнее! И возразить было нечего. Если бы не один нюанс.
Камера фиксирует коробку целиком: на картоне напечатан текст, рекламные логотипы, полосы скотча, старые стикеры. Как алгоритму за доли секунды отыскать среди этого визуального шума закодированный блок? Требовался маркер позиционирования, аналогов которому в традиционной полиграфии просто не существовало.
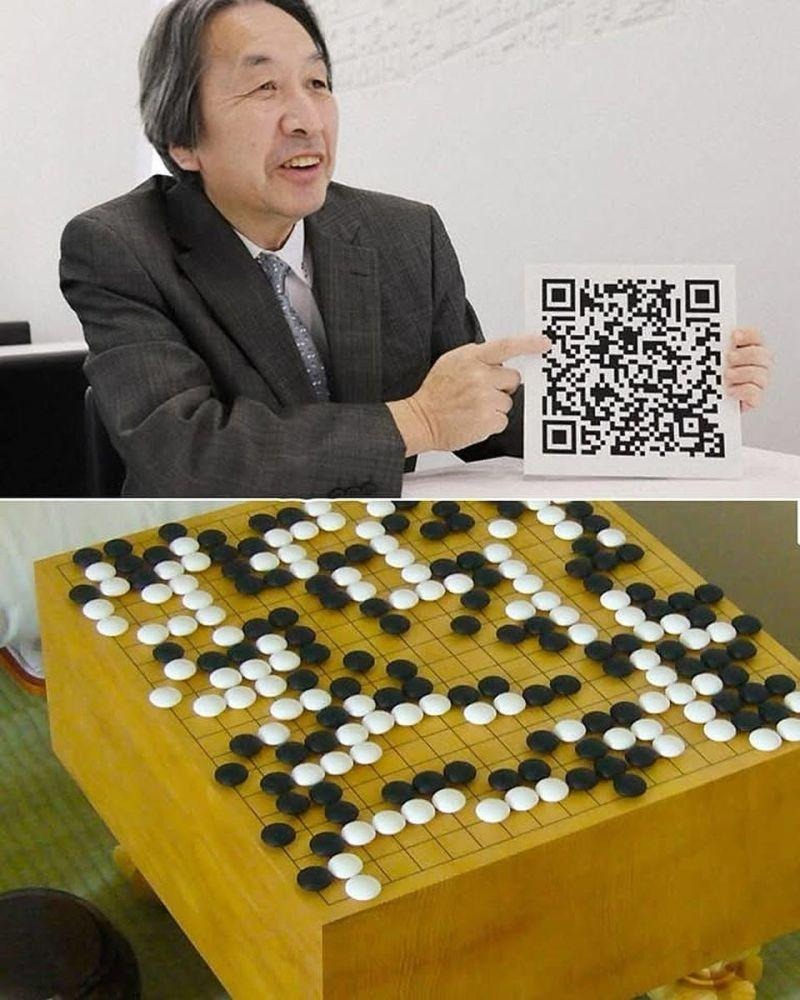
По словам Хары, концепция уникальной метки осенила его при взгляде на архитектуру городского здания из офисного окна: верхние этажи выделялись нестандартным ритмом оконных проемов. При этом маркер должен был быть предельно простым, иначе на его обработку уходило бы слишком много процессорного времени — например, определенное соотношение ширины элементов, аналогичное штрихкоду, но с уникальной пропорцией, не встречающейся в обычных печатных текстах.
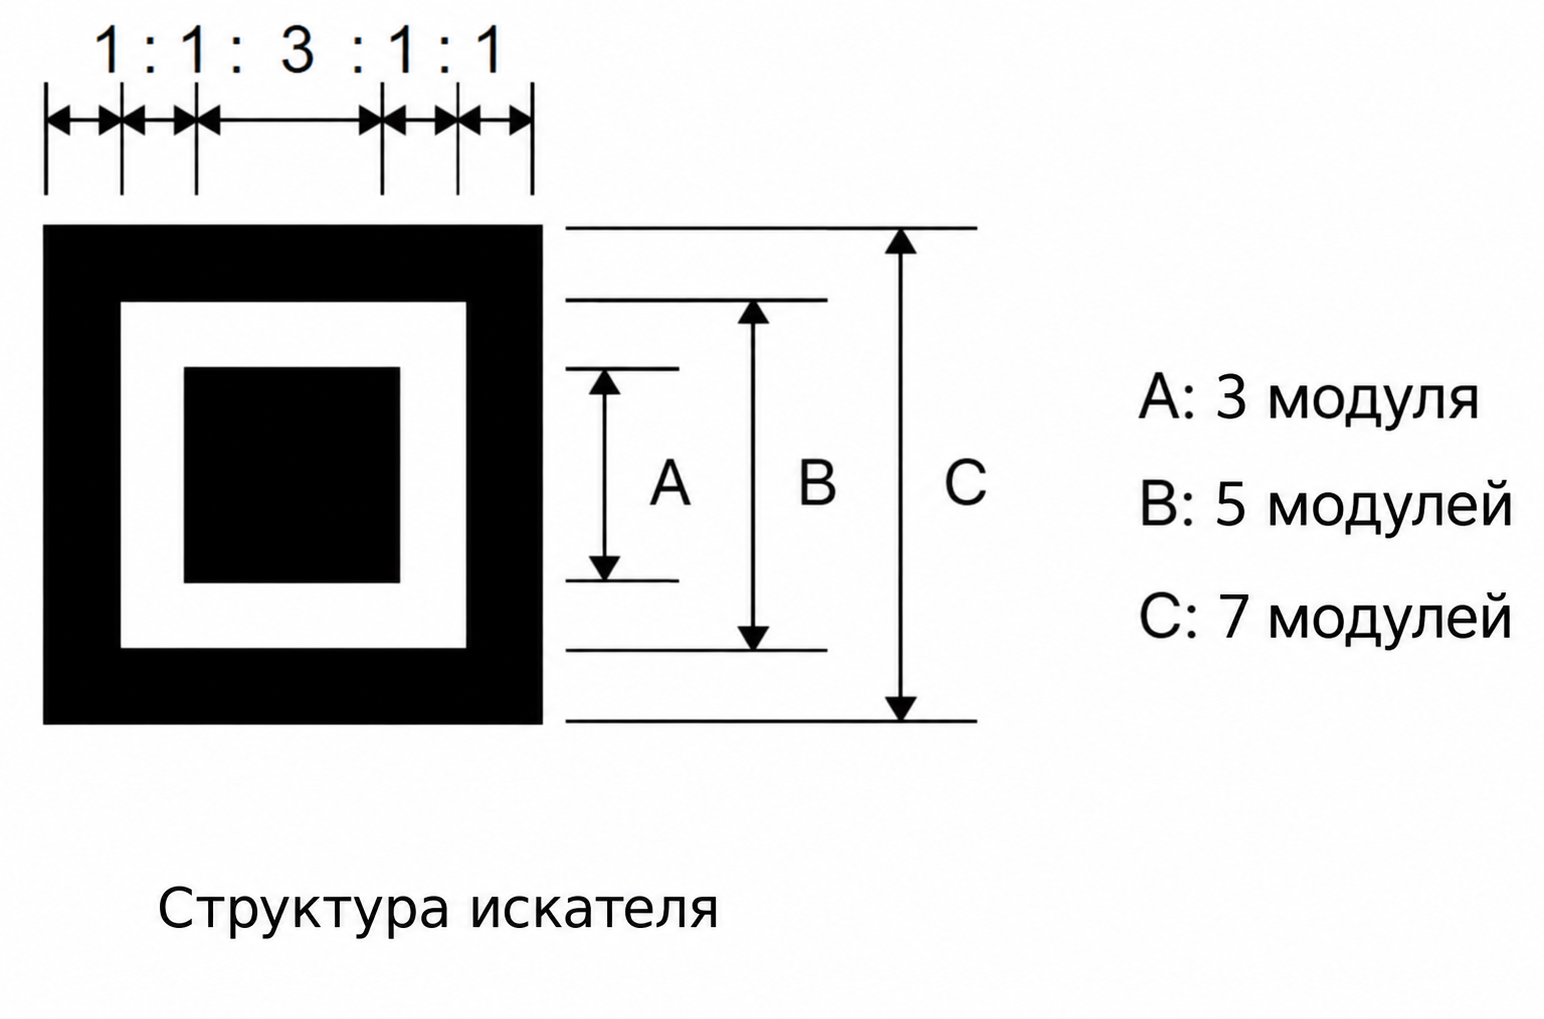
Далее последовала кропотливая аналитическая работа, нетипичная для внезапных озарений. Хара месяцами сканировал газетные полосы, глянцевые журналы, рекламные буклеты, упаковочный картон, прогоняя их через тестовую программу для подсчета соотношения темных и светлых участков. Самой редкой пропорцией в полиграфической практике оказалось соотношение 1:1:3:1:1.
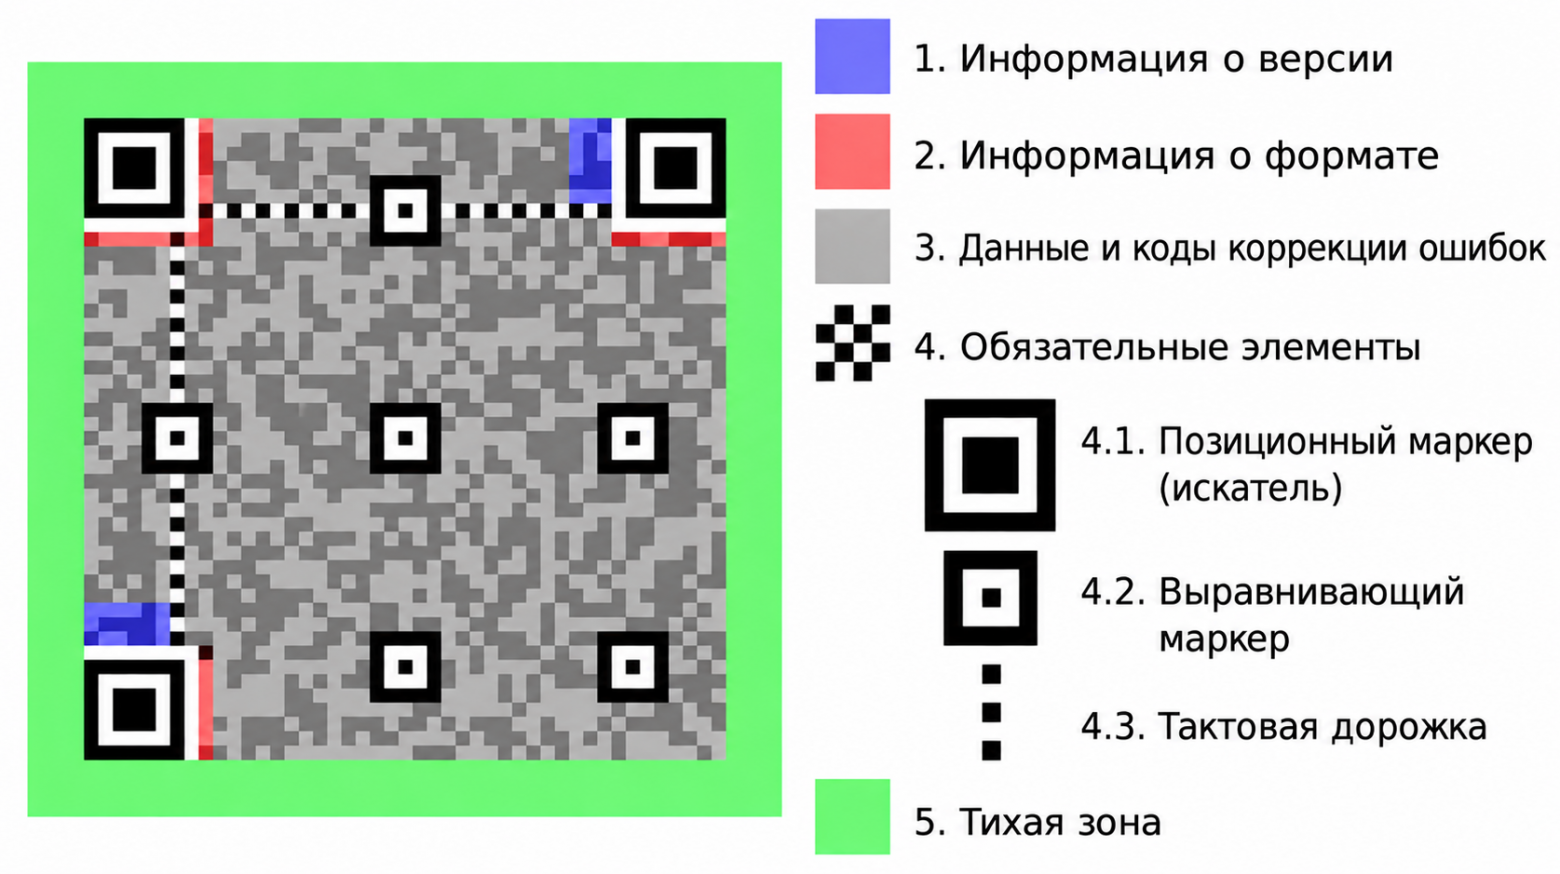
Взгляните на любой стандартный QR-код. Три массивных квадрата по углам — это оно и есть. Каждый репер представляет собой маттрешку: черная рамка толщиной в один модуль, белый зазор в один модуль и черная центральная сердцевина в три модуля. Проведите через центр такого квадрата линию под любым углом — горизонтально, вертикально или по диагонали — и чередование черных и белых отрезков всегда будет строго соответствовать формуле 1:1:3:1:1. Оптический сенсор построчно сканирует снимок в поисках пяти подряд идущих отрезков с заданными пропорциями. Обнаружив три такие точки, система мгновенно вычисляет углы матрицы, физический размер кода и угол его поворота.
По данным Denso, скорость считывания такого кода превосходила существующие аналоги более чем в 10 раз. Отсюда и лаконичное название: Quick Response («быстрый отклик»). Ставка делалась не на максимальный объем данных, а на скорость обработки.
Скрытый текст
Корпорация Denso оформила патенты на QR-технологию, но отказалась от лицензионных сборов за базовые спецификации. Логика менеджмента была предельно прагматичной и характерной для японского бизнеса: никто не станет массово внедрять то, за что требуют роялти. Основной доход компания планировала получать в смежных областях. Denso производила считывающее оборудование, и новый стандарт служил локомотивом продаж фирменных сканеров.
Разумеется, производить аппаратные сканеры мог любой желающий, однако разработка требовала времени, в то время как у Denso уже были готовы готовые серийные образцы.
Патенты остались в портфолио компании, но публичное заявление гарантировало свободу использования стандарта QR Code без выплаты отчислений. При этом торговая марка «QR Code» по сей день остается зарегистрированным товарным знаком DENSO WAVE.
Ближе к делу: разбор устройства QR
Как устроен QR-код? С поисковыми маркерами мы разобрались, но какие еще элементы входят в его структуру? Давайте проследим алгоритм работы считывателя шаг за шагом.
Шаг первый — обнаружение базового паттерна. Для этого и задействованы те самые три крупных угловых квадрата с пропорциями 1:1:3:1:1. В обычной полиграфии подобные геометрические комбинации практически не встречаются, поэтому три обнаруженных маркера с вероятностью 99% указывают на углы матрицы. Опираясь на эти координаты, софт определяет локацию, габариты и ориентацию кода. Четвертый угол намеренно отсутствует: асимметричное расположение трех реперов исключает двусмысленность ориентации, позволяя декодировать матрицу вверх тормашками или под наклоном. Эти элементы называются поисковыми узорами.
Шаг второй — разбиение изображения на ячейки сетки. Матрица состоит из элементарных модулей — черных и белых квадратиков. Сканеру необходимо знать точное количество ячеек по каждой стороне и расположение разделительных границ. Эту функцию выполняют две тонкие соединительные дорожки из чередующихся пикселей, протянутые между угловыми маркерами по горизонтали и вертикали (тактовые дорожки). Подсчитав количество элементов на дорожке, процессор определяет размерность сетки, а по их физическому положению калибрует искажения перспективы, даже если носитель помялся или сфотографирован под острым углом. В более емких версиях кодов предусмотрены дополнительные внутренние маркеры в виде миниатюрных квадратов с точкой по центру, служащие для коррекции геометрии на сложных изгибах.
Шаг третий — извлечение информации. Рядом с угловыми реперами зарезервировано 15 ячеек служебных данных: пара бит кодирует выбранный уровень коррекции ошибок, три бита определяют одну из восьми математических масок (об этом ниже), а оставшиеся десять защищают служебный блок от повреждений. Эта критически важная информация дублируется в двух разных зонах на случай локального затирания. Расшифровав служебный заголовок, декодер понимает структуру макета. Далее чтение данных идет зигзагообразными парами столбцов справа налево: сначала снизу вверх, затем сверху вниз и так далее. Ячейки интерпретируются как двоичные биты: темная — единица, светлая — ноль. Восемь бит формируют байт. Из байтовых последовательностей собирается полезная нагрузка: первые четыре бита определяют режим кодирования (числа, буквенно-цифровые символы, байты или иероглифы), затем следует указатель длины и сами данные.
Пара слов о маскировании. Представьте ситуацию, когда исходные данные случайно сформировали крупное белое поле или, что еще хуже, по центру случайно образовался паттерн 1:1:3:1:1: оптический модуль примет его за ложный угол, и алгоритм «поплывет». Чтобы исключить подобные сбои, перед печатью бинарную матрицу «перемешивают», накладывая одну из восьми шахматных или полосатых масок, инвертирующих цвета ячеек по строгому математическому алгоритму. Из восьми вариантов выбирается тот, который минимизирует количество длинных одноцветных линий, сплошных блоков 2×2 и ложных угловых маркеров, приближая общее соотношение темных и светлых модулей к 50%. Номер примененной маски как раз и фиксируется в тех трех служебных битах. Сканер, прочитав служебный заголовок, накладывает идентичную маску повторно и восстанавливает исходную матрицу. По сути, это простая договоренность: «я зашифровал по правилу №5, расшифруй обратно, и все встанет на свои места».
И еще один важный нюанс. QR-код требует обязательного обрамления однородной охранной зоной контрастного цвета (в терминологии стандарта — «тихой зоной» или Quiet Zone). Она необходима для стабильного позиционирования сканера. Маркетологи обожают обрезать это поле или окрашивать его в фоновые оттенки, снижая контрастность, чем вводят электронику в ступор.
Шаг четвертый, ключевой — исправление ошибок. В структуре кода наряду с полезной информацией всегда заложены избыточные контрольные байты. Не следует путать их долю с условными процентами L, M, Q, H: эти градации обозначают лишь ориентировочную долю поврежденных кодовых слов, которую способен восстановить алгоритм, тогда как физический объем проверочных байтов жестко привязан к версии матрицы и уровню коррекции. Вычисления базируются на кодах Рида — Соломона, опубликованных еще в 1960 году. Если описать концепцию максимально упрощенно: через две точки можно провести единственную прямую. Если же передать приемнику не две, а пять точек той же прямой, система сможет потерять любые три из них и по оставшимся двум восстановить исходную траекторию. Более того, если одна из поступивших точек окажется искаженной и отклонится от прямой линии, алгоритм легко вычислит и отбросит ее. Метод Рида — Соломона оперирует аналогичной логикой, но вместо прямых линий задействует сложные полиномы, а вместо точек — байты. Информационная часть задает кривую, а проверочные байты служат избыточными контрольными точками на ней. Разумеется, это лишь геометрическая аналогия: в реальном алгоритме QR-кода вычисления производятся в терминах полиномов над конечным полем GF(256).
У этого математического метода есть ахиллесова пята: он эффективно исправляет отдельные поврежденные байты. Однако банальная кофейная клякса на поверхности кода повредит не разрозненные байты, а целую группу подряд идущих элементов. Чтобы нивелировать этот риск, в крупных матрицах информационные потоки разбивают на блоки и наносят вперемешку: байт первого блока, байт второго, третьего и снова первого. Капля кофе затронет каждый блок лишь фрагментарно, и каждый из них легко восстановится за счет собственного пула проверочных байтов.
Вот, в общих чертах, и вся анатомия QR-кода.
Семь тысяч символов мелким почерком
Каков же предел емкости QR-кода? В спецификациях задекларирована цифра в 7089 символов.
Да, это действительно так. Но речь идет о версии 40 — гигантской матрице размером 177×177 модулей с минимальным уровнем коррекции L.
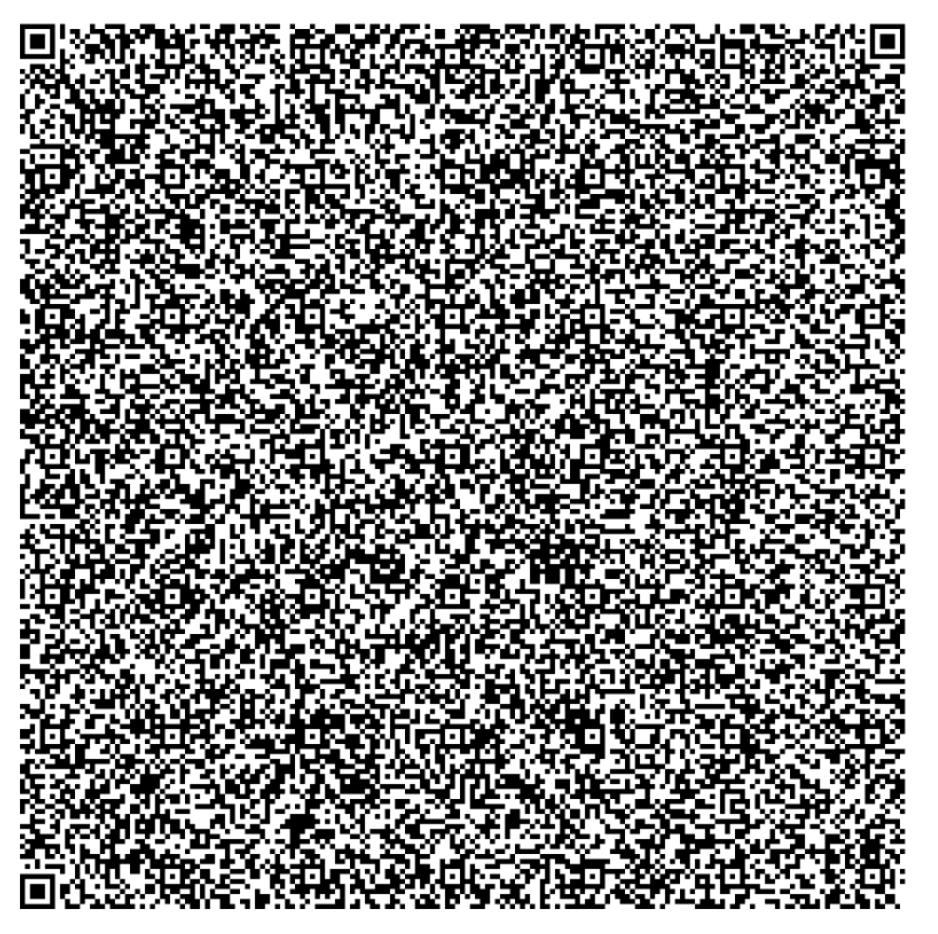
Всего стандартизовано 40 версий: первая имеет сетку 21×21 модуль, и каждая последующая увеличивается на четыре модуля с каждой стороны. При стандартном размере единичного модуля 0,33 мм матрица сороковой версии превращается в квадрат со стороной почти 6 сантиметров. Поистине «незаменимая» вещь на визитной карточке [сарказм]. Разумеется, на практике такие монстры почти не используются.
Типичный QR-код, содержащий короткую веб-ссылку, соответствует второй или третьей версии. URL длиной в 30 байт при минимальной коррекции L прекрасно умещается во вторую версию (25×25 модулей). Если же выбран уровень M, рекомендуемый разработчиками из Denso как универсальный, потребуется третья версия (29×29).
Система коррекции ошибок здесь весьма надежна. Четыре уровня защиты — L, M, Q, H — обеспечивают восстановление примерно 7, 15, 25 и 30 процентов данных соответственно, причем Denso подчеркивает, что проценты рассчитываются от общего числа кодовых слов, а не от физической площади изображения.
В первой версии матрицы заложено всего 26 кодовых слов по 8 бит. При уровне L из них 19 отведено под полезные данные и 7 — под проверочные байты, что позволяет исправить максимум 2 поврежденных слова. При переключении на уровень H соотношение меняется: 9 слов данных и 17 проверочных, что дает компенсацию до 8 повреждений. Иными словами, мы отдаем две трети емкости матрицы ради права потерять треть информации.
Существует важный нюанс, который эти проценты не покрывают. Алгоритм Рида — Соломона защищает кодовые слова в информационной зоне. Угловые маркеры поиска и тактовые дорожки этой защитой не охвачены (служебное поле защищено собственным коротким кодом BCH и дублированием). Поэтому заявленные 7–30% вовсе не означают, что можно безболезненно вырезать аналогичную долю из любой точки QR-кода. Незначительные повреждения реперов алгоритм еще скомпенсирует, но разрушение одного из больших угловых квадратов приведет к тому, что сканер вообще не распознает структуру, и вероятность успешного чтения упадет до нуля.
К слову, именно этим объясняется работоспособность брендированных логотипов в центре QR-кода: фирменный значок забирает часть данных из резерва коррекции ошибок, оставляя угловые поисковые маркеры в неприкосновенности.
Пятнадцать лет в ожидании сканера
Итак, QR-код был изобретен в 1994 году. От патентных отчислений разработчики отказались в 1996-м. Стандартизация по ISO завершилась в 2000-м. Почему же в США и Европе массовый бум этого формата начался лишь в период пандемии, спустя четверть века?
Ответ кроется в вопросе, который мы задавали ранее: с помощью какого устройства считывать двумерную матрицу? Специализированные промышленные терминалы существовали, но для подлинно массового распространения требовалось устройство, которое уже есть на руках у каждого пользователя. Например, мобильный телефон.
В Японии пионером стал сотовый аппарат Sharp J-SH09, выпущенный оператором J-Phone в августе 2002 года. Уже в феврале 2005 года социологическое исследование Infoplant среди почти десяти тысяч абонентов сети i-mode показало, что 53,8% респондентов регулярно пользуются QR-кодами. Большинство населения! И это в 2005 году.
Западный мир безнадежно отстал. Слово «отстал» здесь даже слишком мягкое. Продукция Apple научилась распознавать QR-коды штатным приложением «Камера» лишь с релизом iOS 11 — 19 сентября 2017 года. Пропасть между дебютом J-SH09 и iOS 11 составила 15 лет. В экосистеме Android встроенный сканер в камере появился у Google лишь в смартфонах Pixel 3 в 2018 году, а остальные производители внедряли функцию вразнобой.
Все эти годы спецификация кода оставалась абсолютно неизменной. Проблема заключалась в банальном отсутствии массового оптического приемника.
И лишь к моменту пандемии камера смартфона оказалась в кармане каждого человека, превратившись в универсальный инструмент, не требующий установки сторонних утилит.
Квадратик с уголком
Data Matrix часто путают с QR-кодом или ошибочно считают его разновидностью последнего. Это заблуждение. Во-первых, Data Matrix старше своего знаменитого собрата. Во-вторых, он спроектирован по совершенно иным принципам.
Заявку на патент на эту технологию Деннис Придди и Роберт Цимбальски подали 5 мая 1988 года, а патент был официально зарегистрирован 3 июля 1990-го. В исходной спецификации уже фигурировал фирменный конструктив: две сплошные стороны рамки и две перпендикулярные стороны, состоящие из чередующихся темных и светлых модулей. Компания-разработчик впоследствии сменила нескольких владельцев, а символику передали в общественное достояние — с оговоркой «в той мере, в какой это необходимо для отраслевой стандартизации».
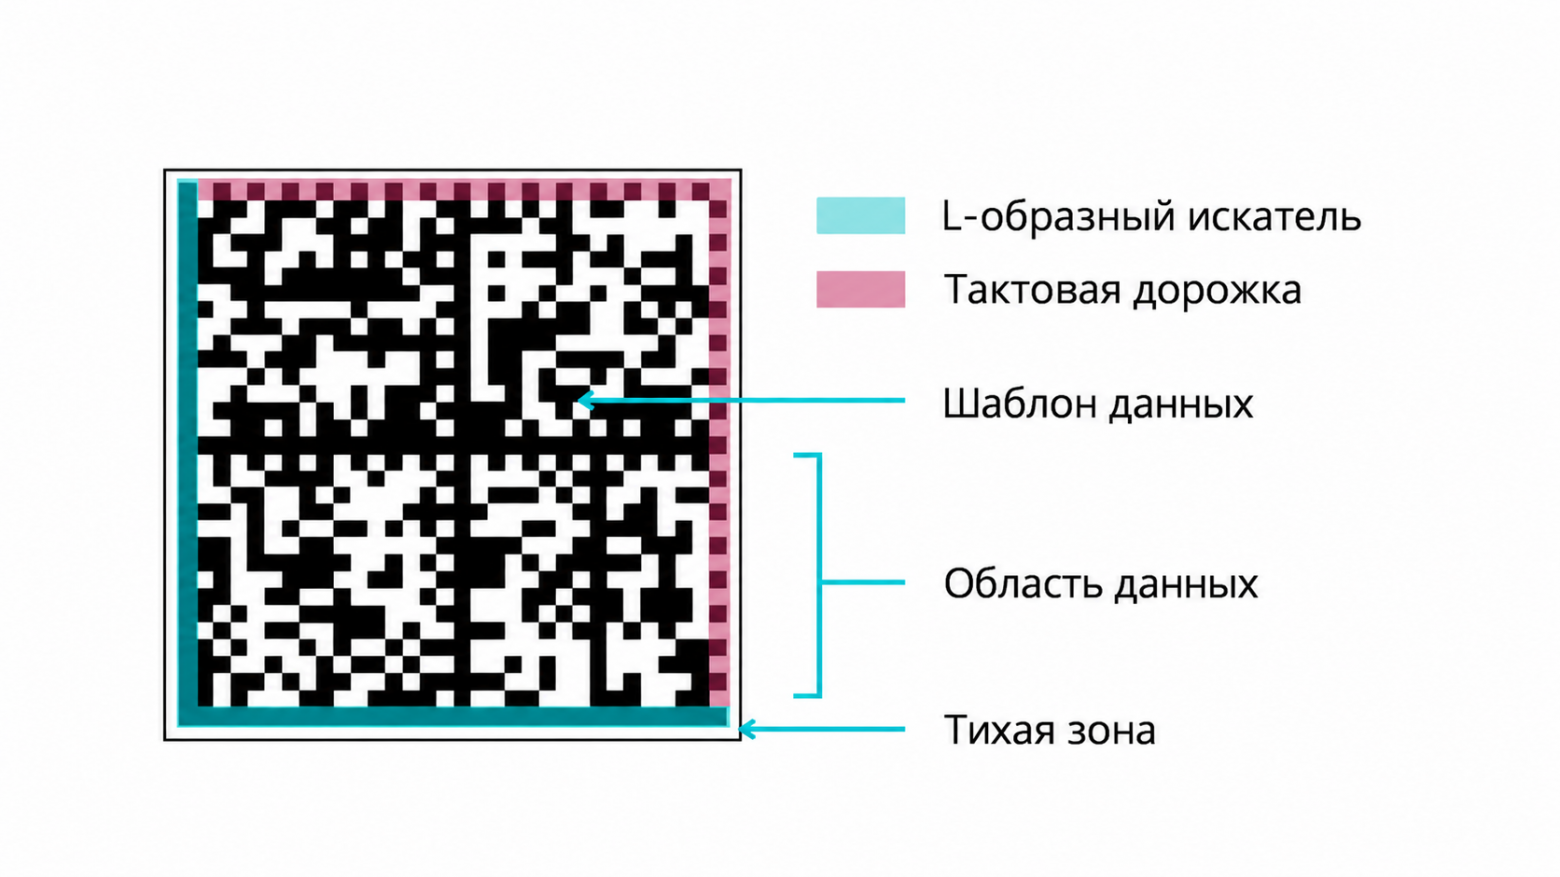
Присмотритесь внимательно к любому коду системы «Честный Знак». Слева и снизу проходит сплошная черная линия, образующая латинскую букву L. Сверху и справа тянется пунктир из чередующихся пикселей. Это и есть весь поисковый маркер.
Сплошной уголок указывает декодеру расположение кода, угол его наклона и наличие геометрических искажений. Пунктирная рамка выполняет функции тактовой дорожки: по ней процессор вычисляет количество строк, столбцов и физический масштаб ячеек. Все те же задачи, что у QR-кода, только реализованные не через три массивных квадрата, а по всему периметру матрицы.
Внутри информационной зоны — ноль служебных ячеек. Почти. В крупных символах появляются дополнительные калибровочные линии, но стандартных молочных матриц размером 20×20 модулей это не касается.
В основе кодирования лежит все тот же алгоритм Рида — Соломона, но с принципиальным отличием: выбрать уровень коррекции ошибок здесь нельзя. Избыточность жестко привязана к габаритам матрицы. В спецификации Data Matrix ECC 200 (единственной актуальной на сегодня) размеры строго четные: от квадратов 10×10 до 144×144 модулей, а также прямоугольные форматы от 8×18 до 16×48 (плюс расширенный в 2020 году пул вытянутых прямоугольников по стандарту ISO/IEC 21471 для маркировки ампул). Каждому фиксированному размеру соответствует строго определенное соотношение полезных данных и проверочных кодовых слов.
Микроскопическая матрица 10×10 содержит всего 8 кодовых слов: 3 информационных и 5 проверочных, что дает колоссальную избыточность в 62,5%. Формат 24×24 оперирует 36 информационными и 24 проверочными словами (избыточность 40%). Для крупных массивов этот показатель составляет около 28%. Самый большой символ 144×144 содержит 1558 слов данных и 620 проверочных блоков, распределенных по 10 чередующимся потокам. Максимальная емкость достигает 3116 цифровых знаков или 1555 байт — вдвое меньше, чем у сороковой версии QR-кода.
Стоп. Получается, что компактный код с уголком проигрывает конкурентам по информационной емкости? Не совсем…
Почему компактный Data Matrix побеждает на миниатюрной упаковке
Давайте проведем простой расчет. Стандартный код маркировки на пачке молока состоит из 30 символов плюс один служебный разделитель. Закодируем этот набор двумя способами. В стандарте Data Matrix эти данные идеально ложатся в матрицу 20×20 модулей, с учетом минимальной охранной зоны в один пиксель общие габариты составляют 22×22. Для QR-кода при выборе уровня M и стандартной сегментации потребуется уже вторая версия сетки (25×25 модулей), а с учетом обязательной для QR четырехмодульной тихой зоны итоговый размер составит 33×33 пикселя.
Сравниваем площади: 484 элемента против 1089. QR-код занимает примерно в 2,25 раза большую площадь на упаковке.
И это при том, что Data Matrix 20×20 способен восстанавливать около 22% кодовых слов — практически на уровне QR с коррекцией Q (не спрашивайте, зачем йогурту такая избыточность, такова специфика геометрической сетки). Используется тот же математический аппарат Рида — Соломона, но занимаемая площадь меньше более чем вдвое. Причина тривиальна: три громоздких поисковых маркера и широкие охранные зоны QR-кода на малых объемах данных обходятся слишком дорого с точки зрения топологии.
Для рекламного плаката это не имеет никакого значения. Но для крышки йогурта, миниатюрной ампулы или блистера с таблетками разница критична: тот же объем критически важных данных размещается на значительно меньшей площади.
Профильная ассоциация GS1 на вопрос, почему для медицинской сферы рекомендован именно GS1 DataMatrix, а не привычный QR, дает аналогичный ответ: максимальная плотность данных при минимальных габаритах, возможность лазерной маркировки микроскопических хирургических инструментов прямо по металлу, а также исторический факт: фарминдустрия внедрила Data Matrix задолго до того, как GS1 официально сертифицировала QR. Плюс жесткое правило «одна упаковка — один код», поскольку наличие двух разных штриховых символов на лекарственном препарате создает риск путаницы на конвейере.
Европейский регламент 2016/161 предписывает наносить на упаковки медикаментов код Data Matrix ECC 200 с полиграфическим качеством не ниже класса 1,5 по стандарту ISO/IEC 15415; дедлайн полномасштабного внедрения датирован 9 февраля 2019 года. Италия и Греция воспользовались отсрочкой до 2025 года, тогда как Бельгия перешла на новые правила одновременно с остальными. Для кодов GS1 DataMatrix на фармацевтических упаковках регламент задает размер модуля в диапазоне от 0,254 до 0,495 мм (целевое значение — 0,380 мм). Более крупные модули (до 0,615 мм) допускаются исключительно в сценариях прямой маркировки самих изделий, а не картонных пачек.
Система «Честный Знак» и ее особенности
Как известно, для национальной системы маркировки «Честный Знак» в нашей стране выбрали именно Data Matrix. Но в специфической модификации.
От классического аналога российский вариант отличается служебным префиксом FNC1 в самом начале последовательности. Сканер, зафиксировав этот маркер, передает в кассовый софт строку с идентификатором ]d2 (если активирована соответствующая настройка передачи), сигнализируя кассе о начале полей GS1 со специальными идентификаторами применения. Поля переменной длины разделяются управляющим символом GS с кодом 29 (0x1D) по таблице ASCII. Постановления правительства РФ описывают этот механизм практически дословно, вплоть до формулировки «с использованием FNC1 в качестве признака символики».
Для молочной продукции согласно правительственному постановлению № 2099 от 15 декабря 2020 года структура кода выглядит так: префикс (01) и 14 цифр GTIN товара, префикс (21) и 6 символов серийного номера, служебный разделитель, префикс (93) и 4 символа криптографической проверки. Итого 30 знаков плюс разделитель — те самые параметры, которые мы просчитывали выше. Это спецификация для товаров фиксированного объема; для весовых позиций (например, сыров) добавляется блок с массой, и общая длина кода увеличивается. Физический размер модуля — от 0,255 мм, рекомендованные габариты матрицы 20×20, полиграфическое качество — не ниже класса 1,5 по ISO/IEC 15415.
Обратите внимание на длину проверочного хвоста: всего 4 символа. Это усеченный криптографический маркер проверки подлинности, используемый государственной системой. Сам по себе этот четырехсимвольный хвост не является полноценной цифровой подписью в привычном IT-понимании. И вот здесь кроется самое интересное.
В фармацевтической отрасли этот защитный хвост изначально насчитывал 88 символов. Восемьдесят восемь!
Согласно отчету о производственных испытаниях на 34 фармпредприятиях, опубликованному «Российской газетой», при длине подписи в 88 символов более чем в 80% тестовых прогонов процент брака исчислялся десятками, а некоторые заводы вообще не смогли нанести код на линию. Фармацевтический гигант «Акрихин» при скорости конвейера 350 упаковок в минуту зафиксировал 78% брак при 88 символах, тогда как переход на 32 символа снизил показатель брака до 0,1%. Не вдвое и не в десять раз. В 780 раз.
Код элементарно не помещался на упаковку.
Постановление правительства № 1118 от 30 августа 2019 года официально сократило длину криптохвоста для лекарств до 44 символов. По грубым инженерным прикидкам, версия с 88 символами требовала матрицу Data Matrix 40×40 или даже 44×44, в зависимости от криптографического наполнения, тогда как с 44 символами упаковка укладывалась в формат 36×36.
Фармбизнес настаивал на дальнейшем сокращении до 32 символов, однако те же тесты показали успешное прохождение лишь в двух третях попыток. В итоге остановились на компромиссном варианте в 44 знака. А для высокоскоростных категорий вроде молочной продукции и табачных изделий разработчики сразу утвердили короткий четырехсимвольный криптохвост, переложив процедуру проверки подлинности на облачные серверы системы. Кассовый терминал запрашивает статус кода у государственной платформы, а не верифицирует криптоподпись локально.
Табачная пачка — вообще уникальный кейс. На сигаретном картоне наносится не GS1 DataMatrix, а стандартный Data Matrix без идентификаторов применения и без префикса FNC1: постановление правительства № 224 от 28 февраля 2019 года сделало для табака исключение. Конструкция состоит из четырех слитных групп: 14 цифр товарного кода, 7 знаков серийного номера, 4 символа максимальной розничной цены в закодированном виде и 4 символа криптопроверки. Итого скромные 29 знаков.
Цена в четырех символах — это показатель копеек, рассчитанный по системе счисления с основанием 80 и записанный комбинацией цифр, латинских букв и спецсимволов. Так что расхожее утверждение «в штрихкоде цены не бывает» в отношении отечественных табачных кодов не работает. Правда, речь идет не о ценнике разовой продажи, а об установленной государством максимальной розничной цене, зашитой непосредственно в идентификатор.
Сведем все факторы воедино. 1973 год: форм-фактор кода диктовали возможности печатного станка. 1993 год: геометрию поискового маркера определяла статистика полиграфического брака. 2019 год: длину криптографического хвоста диктовал каплеструйный принтер на конвейере, физически не успевавший наносить 88 символов при скорости 350 пачек в минуту.
Информационная емкость во всей этой истории неизменно оказывалась на втором, а то и на третьем месте.
Немного о сканирующем железе
Лазерный сканер, как мы выяснили, выхватывает лишь одну световую линию и матричный код обработать не в состоянии. Многоуровневые коды растровый лазер еще может осилить, но матричные — исключительно имиджеры, то есть специализированные камеры, дополненные мощными процессорами обработки изображений.
Первые ручные имиджеры появились в конце 1990-х (например, модель Welch Allyn IMAGETEAM 4400 по спецификациям 1998 года), однако в массовом ритейле они долго оставались экзотикой. Внедрение обязательной маркировки перевернуло рынок. Фискальный чек на маркированный товар по закону обязан содержать реквизит «код товара», извлечь который из линейных полос невозможно, поэтому 2D-сканер на каждой кассе стал стандартом де-факто.
С экранами смартфонов лазерные сканеры работают отвратительно, но по иной причине. Дисплей, в отличие от бумажной этикетки, практически не рассеивает падающий луч: обратно в объектив возвращается зеркальный блик от защитного стекла, интенсивность которого одинакова над светлыми и темными пикселями матрицы, а поляризационные фильтры старых ЖК-панелей дополнительно гасят отражение. Для лазерного датчика светящиеся и темные пиксели экрана сливаются в сплошной темный массив.
Имиджер легко справляется с этой задачей, поскольку фиксирует полноценное изображение, а не измеряет отраженный луч: заметив светящийся экран, электроника приглушает подсветку и корректирует выдержку затвора. Более сложные алгоритмы с многокадровой съемкой и подсветкой под разными углами задействуются уже для чтения кодов с бликующих металлических поверхностей или глянцевых упаковок. Именно поэтому посадочный талон с экрана смартфона уверенно считывается имиджером и безнадежно игнорируется устаревшим лазерным пистолетом.
Пара слов о молочной отрасли. В декабре 2022 года объединение «Союзмолоко» оценивало долю нечитаемых на кассах кодов примерно в 2%; ритейлеры называли цифры, превышающие 10%. Причины банальны: мягкая полиэтиленовая упаковка, конденсат на поверхности, чернила, нанесенные струйным принтером на летучем конвейере. Проблемы те же, что и в 1973 году, только вместо смазанной типографской краски фигурируют капли влаги на пленке.
Торговым сетям тогда предоставили временную отсрочку: до 1 июня 2024 года разрешалось продавать без сканирования кода не более 2% месячного объема молочной продукции. А с 1 апреля 2024 года вёлся поэтапный запуск разрешительного режима: кассовый терминал перед продажей каждого товара отправляет запрос в систему «Честный Знак», проверяя легитимность кода. Первыми под удар попали табачные изделия и пиво в кегах, с 1 мая — питьевая вода и молочка в сетях с количеством точек от 50 магазинов, а с 1 сентября 2024 года — аналогичные категории во всей рознице без исключения. Далее к системе подключились остальные товарные группы.
Заключение
За прошедшие полвека технологии маркировки прошли огромный путь усложнения, но базовая концепция осталась неизменной: побеждает не тот формат, в который удается втиснуть максимум информации, а тот, который удается быстро, дешево и надежно напечатать, считать и расшифровать в суровых реальных условиях.
Именно поэтому для простой товарной нумерации когда-то хватило линейных полос, для интерактивных ссылок идеален QR-код, а для компактной поштучной идентификации незаменим Data Matrix. Архитектуру каждого символа всегда определяет прикладная задача.
Есть лишь одна маленькая проблема… Когда на пачке молока мирно соседствуют линейный штрихкод, рекламный QR и государственный Data Matrix — бог весть, что именно инстинктивно подносить к сканеру… Прошу прощения, к имиджеру.
Размещайте облачную инфраструктуру и масштабируйте сервисы с надежным облачным провайдером Beget.
Эксклюзивно для читателей SE7ENа мы даем бонус 10% при первом пополнении.

Похожие статьи
 Эффективный менеджмент знаний: подборка книг о том, как монетизировать опыт персонала
 Как пауки превращают жидкий шелк в самый прочный материал на Земле
 Зарисовки из зала суда: правосудие на карандаше
 Где женщины на вершине успеха?
 Как связаны между собой выборы и бутылка Клейна
 ИИ всегда на вашей стороне: почему это опасно для подростков?
 Шахматная классика для тех, кто взял 1500 на Lichess: книги, обязательные к прочтению
 Куда исчезают 69 гигабайт с каждого терабайта и почему это стало причиной судов с производителями