[Перевод] Майнинговую CMP 170HX превратили в A100 на 80 ГБ: глитч напряжения позволил записать фьюзы
В майнинговой карте NVIDIA CMP 170HX используется тот же кристалл GA100, что и в A100. На плате установлено около 80 ГБ памяти HBM, однако карте доступно лишь 8 ГБ. Эти ограничения задаются электронными предохранителями eFuse на самом кристалле. Мне удалось обнаружить в GA100 уязвимость к кратковременному изменению напряжения, которая позволяет прожигать произвольные фьюзы. С её помощью я превратил свою CMP 170HX 8GB в устройство, по существу эквивалентное A100-80G.
Более того, разблокированные карты работают примерно в 1,2 раза быстрее серийной A100. В них активны все исправные SM — около 120–126, в зависимости от конкретного кристалла, — тогда как в серийных A100 NVIDIA оставила только 108, чтобы повысить выход годных устройств. Этот же метод позволяет включить отключённые в CMP функции: NVLink, PCIe Gen4, NVJPG, NVDEC и MIG. Впрочем, NVJPG, NVDEC и MIG я отдельно не проверял.
Вот как выглядит и работает моя «A100-80G».
$ nvidia-smi --query-gpu=index,pci.bus_id,pci.device_id,name,memory.total; nvidia-smi topo -m
index, pci.bus_id, pci.device_id, name, memory.total [MiB]
0, 00000000:81:00.0, 0x20C210DE, NVIDIA Graphics Device, 81920 MiB
1, 00000000:C1:00.0, 0x20C210DE, NVIDIA Graphics Device, 81920 MiB
	GPU0	GPU1	CPU Affinity	NUMA Affinity	GPU NUMA ID
GPU0	 X 	NV12	0-127	0		N/A
GPU1	NV12	 X 	0-127	0		N/A
Производительность FP16 FMA:
|
Карта |
TFLOP/s |
По сравнению с серийной A100 |
|---|---|---|
|
Серийная A100 |
72,488 |
1,00× |
|
CMP 170HX с аппаратной разблокировкой |
85,858 |
1,18× |
Полный результат теста OpenCL:
.-----------------------------------------------------------------------------.
|----------------.------------------------------------------------------------|
| Device ID    0 | NVIDIA Graphics Device                                     |
| Device ID    1 | NVIDIA Graphics Device                                     |
|----------------'------------------------------------------------------------|
|----------------.------------------------------------------------------------|
| Device ID      | 0                                                          |
| Device Name    | NVIDIA Graphics Device                                     |
| Device Vendor  | NVIDIA Corporation                                         |
| Device Driver  | 610.43.03 (Linux)                                          |
| OpenCL Version | OpenCL C 3.0                                               |
| Compute Units  | 124 at 1410 MHz (7936 cores, 22.380 TFLOPs/s)              |
| Memory, Cache  | 81338 MB VRAM, 3472 KB global / 48 KB local                |
| Buffer Limits  | 20334 MB global, 64 KB constant                            |
| Max Workgroup  | 1024 threads                                               |
|----------------'------------------------------------------------------------|
| Info: OpenCL C code successfully compiled.                                  |
| FP64   Compute   (double, fma  )                     11.287 TFLOPs/s (1/2 ) |
| FP32   Compute   (float , fma  )                     22.781 TFLOPs/s ( 1x ) |
| FP16   Compute   (half2 , fma  )                     85.858 TFLOPs/s ( 4x ) |
| INT64  Compute   (long  , a*b+c)                      2.759  TIOPs/s (1/8 ) |
| INT32  Compute   (int   , a*b+c)                     22.769  TIOPs/s ( 1x ) |
| INT16  Compute   (short2, a*b+c)                     20.273  TIOPs/s ( 1x ) |
| INT8   Compute   (char4 , dp4a )                     81.169  TIOPs/s ( 4x ) |
| Memory Bandwidth ( coalesced read      )                       1883.17 GB/s |
| Memory Bandwidth ( coalesced      write)                       2137.93 GB/s |
| Memory Bandwidth (misaligned read      )                       1460.81 GB/s |
| Memory Bandwidth (misaligned      write)                        250.13 GB/s |
| PCIe   Bandwidth (send                 )                         13.10 GB/s |
| PCIe   Bandwidth (   receive           )                         11.69 GB/s |
| PCIe   Bandwidth (        bidirectional)            (Gen3 x16)   11.58 GB/s |
|-----------------------------------------------------------------------------|
'-----------------------------------------------------------------------------'
NVIDIA использует фьюзы для разделения продуктов на сегменты, реализации защитных функций и других любопытных способов управления доступом. При этом для некоторых функций прожжённый фьюз на кристалле NVIDIA, напротив, расширяет доступ. В корректно защищённой схеме прожиг фьюза должен всегда переводить чип в более ограниченное состояние: восстановить его экономически практически невозможно. Однако в архитектуре NVIDIA ограничения можно ослабить, прожигая дополнительные фьюзы!
Далее я расскажу о кристалле GA100, его контроллере фьюзов, применении кратковременных сбоев напряжения (voltage fault injection, VFI) и возможных направлениях дальнейшей работы. Часть материалов, на которых основано исследование, опубликована здесь.
Благодарности
Эта работа опирается на предыдущее исследование Джона Прая (Jon Pry) и вклад многих других людей, посвятивших немало времени изучению GA100. Я публикую результаты после того, как ту же уязвимость независимо обнаружил другой специалист по безопасности: считаю, что раскрытие этой информации отвечает общественным интересам. До выхода статьи результаты были переданы команде безопасности продуктов NVIDIA.
Разновидности GA100
GA100 — кристалл NVIDIA, лежащий в основе почти 20 различных SKU. Самый известный из них — A100. Я не буду разбирать все SKU, а сосредоточусь на вариантах GA100, значимых для этой работы: различных версиях CMP 170HX и A100.
Изначально GA100 содержит 128 SM, 12 FBP, пять блоков NVDEC, контроллер PCIe Gen4 x16 и, в зависимости от объёма видеопамяти, от четырёх до шести стеков HBM в одном корпусе с кристаллом. С помощью eFuse NVIDIA управляет выходом годных устройств и сегментацией: одинаковые кристаллы GA100 превращаются в более урезанные версии в зависимости от обнаруженных дефектов и рыночного спроса.
Один из наиболее ярких примеров такой сегментации — CMP 170HX, предназначенная для майнинга Ethereum. Номинально приложениям доступно 8 или 10 ГБ видеопамяти, хотя фактически на плате установлено соответственно около 80 или 40 ГБ HBM. Эта работа посвящена прежде всего полной разблокировке и использованию установленной памяти. Предыдущие исследования существенно продвинулись в программной разблокировке GA100, а глитч напряжения позволяет преодолеть последний барьер.
|
SKU |
Параметр |
Из коробки |
Программно (cmpunlocker) |
GA100VFI |
|---|---|---|---|---|
|
CMP 170HX 8GB |
Видеопамять |
8 ГБ |
64 ГБ |
64–80 ГБ¹ |
|
CMP 170HX 10GB |
Видеопамять |
10 ГБ |
40 ГБ² |
40–48 ГБ |
|
Обе CMP |
SM |
70 |
70 |
120–128 |
|
Обе CMP |
Поколение PCIe |
1 |
2 |
4 |
|
Обе CMP |
NVLink |
Нет |
Нет |
Да³ |
|
Обе CMP |
ECC |
Нет |
Нет |
Да⁴ |
|
Обе CMP |
Multi-Instance GPU |
Нет |
Нет |
Да⁴ |
|
Обе CMP |
NVDEC |
0 |
0 |
5⁴ |
Аппаратные ограничения
Как NVIDIA создаёт на основе одного кристалла и A100 для дата-центров, и майнинговую CMP? Чтобы ответить на этот вопрос, рассмотрим устройство контроллера фьюзов GA100.
Контроллер содержит 16 384 eFuse, организованных в 512 строк по 32 фьюза, а также логику управления этим массивом. Он считывает и программирует фьюзы, обеспечивает их защиту и передаёт остальной части кристалла «слова опций» (option words). Именно эти слова определяют режим работы кристалла и набор доступных функций.
Каждый eFuse может находиться в одном из двух состояний: прожжённом (1) или целостном (0). Все 512 строк разделены на четыре области:
-
Обычные фьюзы (строки 0–221). Их устройство достаточно простое: отдельному слову опции часто соответствует один фьюз или пара. Например,
OPT_ENABLE_FUSE_PROGRAMопределяет, разрешено ли дальнейшее программирование фьюзов. Для обычных фьюзов предусмотрено резервирование: тот жеOPT_ENABLE_FUSE_PROGRAMсостоит из основного (PRI) и резервного (RED) фьюзов. В данном случае основной — фьюз 0 строки 0, а резервный — фьюз 0 строки 1. Некоторые слова опций имеют скалярное значение, например девятибитноеOPT_X_COORDINATE, которое, по всей видимости, хранит координату X кристалла на пластине. Важно, что надёжно «восстановить» прожжённый обычный фьюз практически невозможно, если не считать RIR, о котором речь пойдёт ниже. -
Бесфьюзовые фьюзы (fuseless fuses, FF; строки 222–487). Это довольно необычный механизм. Похоже, NVIDIA столкнулась со случайным прожигом обычных фьюзов и порчей инженерных образцов и создала систему, которая кодирует итоговые слова опций в формате, напоминающем JTAG-цепочку (см. патент). По сути, FF — это скрипт, задающий значения отдельных слов опций. FF-фьюзы (прошу простить тавтологию) отвечают за большую часть функций, разблокируемых с помощью глитча. Дело в том, что слова опций FF легко сбросить, записав новые FF-строки. Подробнее об этом ниже. Пока достаточно знать, что NVIDIA тоже осознаёт эту особенность: в обычных условиях прожиг FF-фьюзов строго запрещён.
-
IFF-фьюзы (строки 487–512). Они содержат инструкции в формате, отличном от FF. Их рассмотрение выходит за рамки статьи; в основном они служат для перепрограммирования слов опций контроллера на лету. На серийных картах эта область обычно недоступна.
-
RIR-фьюзы (8 строк по 32 фьюза, формально не входят в 512 строк). Этот штатный механизм «ремонта фьюзов» предоставляется разработчиком массива фьюзов; даташит TSMC доступен здесь. В области RIR на GA100 предусмотрено место для 16 инструкций ремонта, каждая из которых переопределяет значение одного указанного фьюза в основных 512 строках. К сожалению, именно в SKU 170HX 8GB 15 из 16 слов RIR состоят из единиц, а последнее кодирует бесполезную инструкцию, которую лишь изредка удаётся применить для чего-то интересного. У версии с 10 ГБ ситуация иная, но об этом в другой раз…
Для разблокировки с помощью глитча представляют интерес две группы фьюзов:
-
«Управляющие фьюзы» (control fuses). Этот термин взят из заголовочных файлов NVIDIA для Tegra и обозначает строки 0 и 1, в которых задаются критичные для безопасности слова опций.
-
Бесфьюзовые фьюзы, в которых закодированы интересующие нас слова опций. От них зависит, станет ли GA100 ограниченной майнинговой картой или рабочей лошадкой ИИ-дата-центра.
Прежде чем перечислять слова опций FF, подробнее рассмотрим формат FF-записей и блоки кристалла, отвечающие за нужные нам функции.
Бесфьюзовые фьюзы
Каждая FF-строка представляет собой 32-битную запись. Биты 0–4 выбирают цепочку, бит 5 отличает FF от IFF (для FF он равен 0), биты 6–15 выбирают 16-битный блок, а биты 16–31 задают его новое значение. Схему JTAG-цепочки из патента следует понимать буквально: контроллер формирует данные опций, последовательно применяя записи к цепочкам. Фиксированные позиции в каждой цепочке соответствуют отдельным словам опций.
Если две записи адресуют одну цепочку и один блок, приоритет получает более поздняя. Например, 0x0fe805c1 обозначает цепочку 1, блок 23 и данные 0x0fe8. Добавив такую запись, можно сбросить бит, установленный более ранней FF-записью. При этом физические фьюзы не восстанавливаются: новая строка просто заменяет прежний 16-битный блок. Этот механизм работает для FF-опций, но не для обычных управляющих фьюзов в строках 0 и 1.
Теперь, когда формат FF-слов понятен, можно перечислить интересующие нас слова и их расположение. Их определил отзывчивый исследователь, который сравнивал значения FF и итоговые слова опций у разных SKU GA100. Таким дифференциальным методом он восстановил соответствие цепочек и блоков FF словам опций; официальная таблица соответствия неизвестна.
|
Опция |
Предполагаемое расположение в FF |
Назначение |
|---|---|---|
|
|
Цепочка 1, биты 83–106; блоки 5–6 |
Отключение ввода-вывода памяти |
|
|
Цепочка 1, биты 107–130; блоки 6–8 |
Отключение подразделов памяти |
|
|
Цепочка 1, биты 131–138; блок 8 |
Отключение GPC |
|
|
Цепочка 1, биты с 187+8i по 194+8i для GPC i; блоки 11–15 |
Восемь масок TPC |
|
|
Цепочка 1, биты 251–274; блоки 15–17 |
Отключение PES |
|
|
Цепочка 1, биты 307–318; блок 19 |
Отключение разделов видеопамяти |
|
|
Цепочка 1, биты 319–342; блоки 19–21 |
Отключение ROP/L2 |
|
|
Цепочка 1, биты 368–370; блок 23 |
Маска отключения NVLink |
|
|
Цепочка 2, блок 39; неизвестно, бит 1 или 9 |
Ограничение скорости PCIe Gen3 |
|
|
Цепочка 2, блок 47, бит 3 |
Флаг запрета скорости Gen4 |
|
|
Цепочка 2, блок 49, бит 6 |
Политика загрузки PCIe |
|
|
Цепочка 2, блок 49, бит 7 |
Политика загрузки PCIe |
|
|
Цепочка 2, биты 593–608; блоки 37–38 |
Идентификатор устройства |
|
|
Цепочка 2, биты 609–624; блоки 38–39 |
Идентификатор устройства |
|
|
Цепочка 1, биты 372–379; блок 23 |
Включённые конвейеры Multi-Instance GPU |
Аббревиатуры FBIO/FBPA/FBP/TPC/GPC/PES/ROP обозначают элементы микроархитектуры. Их взаимосвязь удобнее всего рассмотреть на схеме из технического описания GA100:
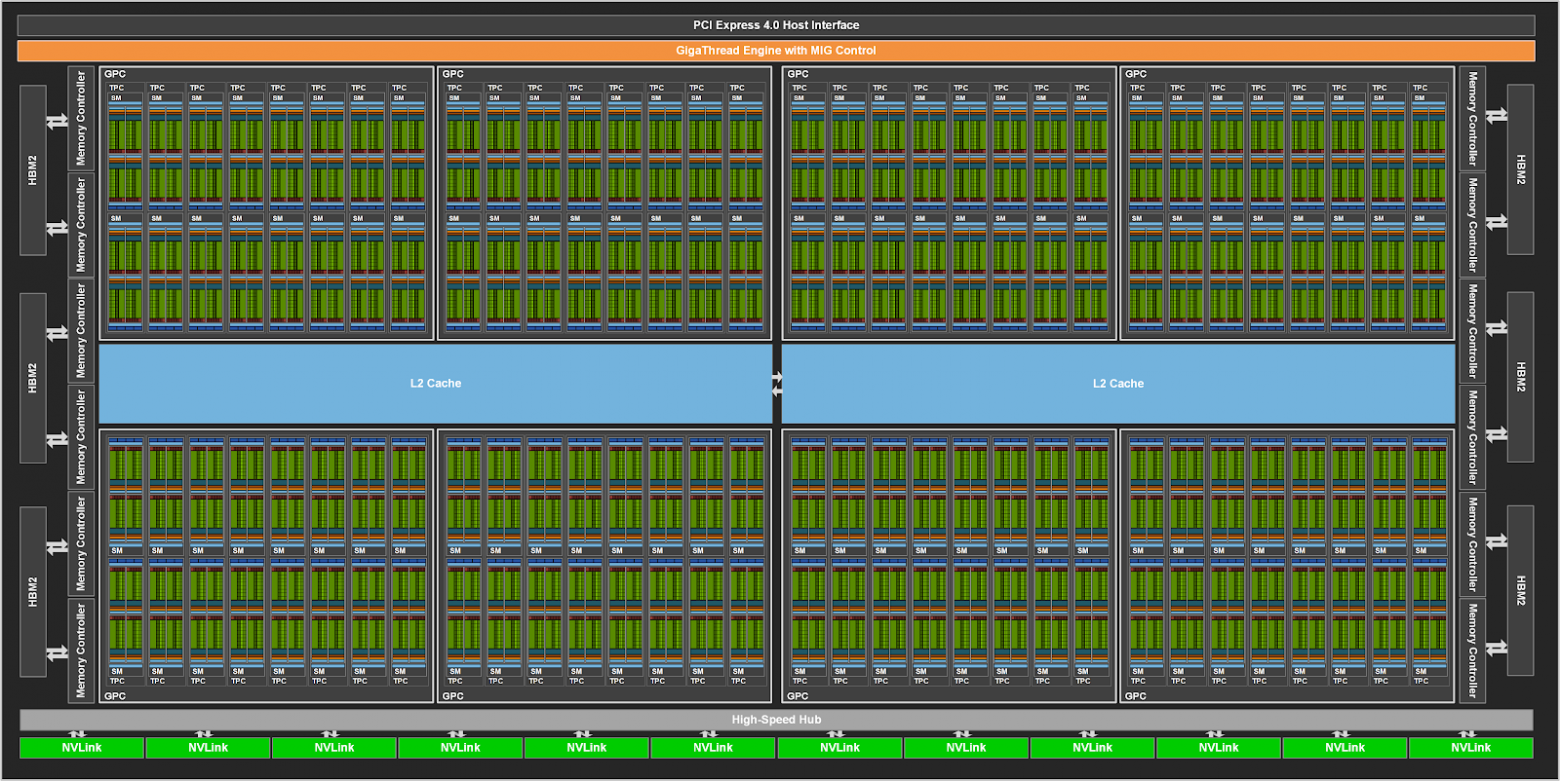
FBP — внутреннее обозначение NVIDIA для раздела видеопамяти (framebuffer partition); на каждый стек HBM приходится два FBP. FBPA — подразделы памяти, по два на каждый FBP. PES и ROP — блоки, предположительно связанные с графикой, без которых SM работать не может.
Теперь возникает вопрос: что произойдёт, если записать новые FF-строки, которые обнулят слова _DISABLE или хотя бы ослабят ограничения настолько, насколько позволяют дефекты кристалла? Анализ использования _DISABLE вместе с другими элементами быстро показывает, что именно эти слова позволяют не допустить отключения (floorsweep) частей кристалла. Сначала я расскажу, что это даёт, а затем — как применяется глитч и какие механизмы защиты контроллера фьюзов он обходит.
Отключение блоков (floorsweeping)
С помощью этих опций NVIDIA формирует сигналы floorsweep, делающие соответствующие элементы кристалла недоступными и, вероятно, обесточенными. По результатам экспериментов я предполагаю, что линии floorsweep заданы непосредственно в RTL: они проходят от контроллера фьюзов к отдельным функциональным блокам и управляют главным переключателем питания или тактирования внутри каждого блока. По моим наблюдениям, состояние блока меняется почти сразу вслед за итоговым словом его статуса в контроллере фьюзов.
Рассмотрим отключение FBP. На одной из моих карт с 8 ГБ значение OPT_FBP_DISABLE составляло 0x852: были замаскированы FBP 1, 4, 6 и 11. Отдельная маска OPT_FBP_DEFECTIVE равнялась 0x840 и указывала на блоки 6 и 11. Когда я с помощью заменяющей FF-строки уменьшаю маску отключения до 0x840, ограничения для блоков 1 и 4 исчезают, а дефектные 6 и 11 остаются отключёнными. В результате доступными становятся 10 из 12 FBP кристалла. Блоки FBP 1 и 4, которые при OPT_FBP_DISABLE = 0x852 не позволяли читать и записывать регистры, после изменения фьюзов начинают отвечать.
Однако одного возвращения функциональных блоков через FF-записи недостаточно для конечного приложения. Например, стандартная конфигурация видеопамяти использует лишь часть каждого доступного стека HBM.
Обойти это можно с помощью небольшой модификации метода cmpunlocker. Обычный патч драйвера для разблокировки с 8 до 64 ГБ изменяет определённый набор слов конфигурации функций (FBPA_CFG, SM_SPEED_SELECT и другие). Значения по умолчанию рассчитаны на самый распространённый вариант 170HX, где FF-слова _DISABLE блокируют часть функциональных модулей: любая попытка обращения к ним возвращает ошибку floorswept. После прожига разблокирующих FF-записей в регистры конфигурации можно записать менее ограничивающие значения. В результате получается устройство, функционально сопоставимое с A100-80G.
Как прожечь FF
Из сказанного следует, что возможность прожигать произвольные FF-фьюзы позволяет раскрыть потенциал любого GA100 настолько, насколько это допускают исправность кристалла и установленные стеки памяти. Но как именно прожечь FF-фьюзы? Для начала рассмотрим работу контроллера.
Чтобы запросить прожиг, необходимо записать значения в регистры контроллера FUSEADDR, FUSEWDATA и FUSECTRL. Формально хост и непривилегированные агенты доступа к ним не имеют, однако ROP-цепочка из работы «Canary in the Crypto Mine» позволяет без труда открыть соответствующие маски уровней привилегий. Поэтому многие исследователи пытались заставить контроллер прожечь фьюзы в области FF. Совместными усилиями удалось выяснить следующее:
-
У контроллера фьюзов есть внутренний конечный автомат, текущее состояние которого отображается битами
FUSECTRL_STATE. -
Для каждого установленного бита в запрошенном значении
FUSEWDATAконтроллер переходит в состояниеWRITE_PROGRAM. Это соответствует ожидаемому поведению при программировании фьюзов. -
Однако до сброса одного конкретного слова опции записи по адресам за пределами FPF (строки 96–221) фактически не выполняются. Фьюзы в диапазоне FPF прожигаются; предположительно это программируемые в эксплуатации фьюзы (field programmable), хранящие сведения о запускавшихся версиях микрокода и другую эксплуатационную информацию. При этом конечный автомат контроллера ведёт себя одинаково как внутри FPF, так и за его пределами.
Речь идёт о слове опции OPT_SECURED_BURN_FEATURE_ENABLE (SBFE), равном 1 на всех серийных картах. Если оно сброшено, фьюзы можно программировать по любому адресу; если установлено — только в области FPF. Пока никому не удалось прожечь FF-фьюзы при SBFE = 1, даже управляя контроллером из HS-контекстов. Не вполне ясно, что именно означает «secured burn». Я подозреваю, что существует чисто программный способ прожига фьюзов вне FPF при SBFE = 1, но мы пока не понимаем, какой смысл здесь вложен в слово «secured».
Примечание. PLM, HS, ucode и другие термины — по мере углубления в тему специфической терминологии NVIDIA становится всё больше. За подробными объяснениями рекомендую обратиться к другим источникам, например Je Ne Sais Quoi — Falcons over the Horizon.
Важно то, что эксперименты на менее защищённых картах подтвердили: при SBFE = 0 прожиг FF возможен. Как оказалось, достижение этого состояния и открывает путь к разблокировке GA100. После множества попыток мне удалось вызвать его с помощью глитча напряжения. Рассмотрим этот метод подробнее.
Глитч напряжения
О VFI написано немало, поэтому за подробными объяснениями лучше обратиться к другим источникам. Вкратце: кратковременные провалы напряжения питания нередко вызывают неожиданное поведение интегральных схем. По моей просьбе модель GPT-6 Astra спроектировала плату на STM32G4, которая подключается к сигналу PWMVID на плате CMP. PWMVID — стандарт NVIDIA для регуляторов напряжения. Мой глитчер перехватывает ШИМ-сигнал кристалла GA100 и подменяет его собственным, направляемым на контроллер VRM MP2888B. Таким образом, нужные по времени глитчи создаёт штатный VRM самой карты. Это проще схем на MOSFET и быстрее прямого управления через PMBus.
Глитчеру необходимы два подключения к плате; удобнее всего выполнить их тонким эмалированным проводом. Один провод подключается к NVVDD для измерения напряжения, второй — к PWMVID. Кроме того, нужно выпаять один нулевой резистор 0402, соединяющий ШИМ-выход GA100 с микросхемой VRM. Точки подключения легко найти по выводам MP2888B — PWMVID и VOSEN. Корпус и разводка MP2888B совпадают с публично документированным MP2888A. Тестовые точки рядом с MP2888B позволяют относительно просто подпаять отвод PWMVID.
После подключения одна попытка глитча проходит следующим образом:
-
Отключить питание карты.
-
Снова подать питание.
-
Запустить таймер глитча, когда NVVDD пересечёт заданный порог.
-
Подать через PWMVID необходимую форму напряжения с привязкой к таймеру.
-
Проверить поведение карты и при необходимости повторить процедуру с первого шага.
Первые два шага я выполняю простым переходом ACPI S0 → S3 → S0; на современной настольной платформе это занимает несколько секунд. Более серьёзные модификации или дорогостоящий стенд, вероятно, позволили бы проводить больше попыток за то же время. Тем не менее, по моему опыту, описанной установки достаточно для разблокировки карты за время от 1 до 48 часов глитчинга.
Прошивка, написанная Astra, использует компаратор STM32 для отслеживания порога NVVDD: он фиксирует пересечение отметки 225 мВ, после чего плотный цикл с DMA выдаёт нужный коэффициент заполнения на вывод PWMVID. Вернувшись в S0, хост проверяет состояние карты и определяет дальнейшие действия. Если требуется ещё одна попытка, плата глитчера получает по USB команду с шаблоном глитча. Затем хост переходит в S3 и устанавливает будильник RTC примерно на 3 секунды — этот интервал подобран экспериментально для стабильной работы.
Иногда хост не возвращается в S0. Для решения этой проблемы учёт и подготовка серий глитчей перенесены на одноплатный компьютер Radxa Cubie A5E. При зависании целевой системы он может через GPIO нажать кнопки питания и сброса на материнской плате.
Подробности доступны в репозитории GA100VFI. Теперь рассмотрим интересные состояния, которые можно вызвать глитчем, и выясним, какое из них необходимо для прожига FF-строк. Чтобы нагляднее показать различия, я составил эмпирическую модель запуска контроллера фьюзов при подаче питания. Без доступа к RTL контроллера это лишь предположения. Возможная последовательность загрузки такова:
-
Считывание RIR в соответствии с требованиями массива фьюзов.
-
Считывание управляющих строк из массива фьюзов в регистр чтения.
-
Защёлкивание управляющих строк в производные от них слова опций.
-
Считывание остальных строк.
-
Защёлкивание значений обычных фьюзов в соответствующие слова опций.
-
Разбор FF-цепочки.
-
Защёлкивание значений FF-цепочки в соответствующие слова опций.
Эти предполагаемые этапы основаны на данных, которые действительно удаётся считать с кристалла: состояниях контроллера, сырых строках при работающей команде CMD_READ, публикуемых словах опций и доступности остальных частей GPU через кольцо PRI. Несколько ключевых значений позволяют различать результаты глитча. Важно помнить, что формы глитчей и реакция на них сильно зависят от конкретного кристалла, поэтому приведённые ниже сигналы и результаты — лишь примеры. Рассмотрим три интересных состояния.
1. Все фьюзы считаны как нулевые
Команда PWMVID: коэффициент заполнения 59,58% / 0,8333%, один импульс с 210-й по 1010-ю мс после срабатывания триггера NVVDD ≥ 225 мВ, продолжительность — 800 мс. На графике в оригинале приведено смоделированное напряжение NVVDD: в том же прогоне его не измеряли. В этой попытке нулевыми считались 668 из 672 опций; приведённый ниже результат 669/672 получен в другом захвате.
Некоторые глитчи приводят к тому, что почти все публикуемые слова опций считываются как нули. В одном из зафиксированных состояний нулевые значения вернули 669 из 672 именованных опций, а остальные три завершились ошибкой. Статус CRC контроллера составил 0x00 — разбор ещё не выполнен. PCIe ID считывался как 2080, базовый идентификатор GA100, не соответствующий ни одному реальному серийному продукту. Кольцо PRI в GPU при этом оставалось в состоянии сброса.
Это состояние напоминает катастрофический сбой контроллера фьюзов. Карта запускается практически неработоспособной, поскольку нулевые значения нарушают почти все функции загрузки. Любопытно, однако, что при этом она самостоятельно выходит на PCIe Gen4. В несколько иных вариантах этого состояния часть фьюзов может успешно защёлкнуться или содержать произвольные данные вместо нулей. Ни одно из этих состояний мне не удалось использовать для прожига FF: почти всегда контроллер фьюзов недоступен или неработоспособен.
2. Нарушено считывание RIR
Команда PWMVID: коэффициент заполнения 59,58% / 0,8333%, один импульс с 980-й по 1005-ю мс после триггера, продолжительность — 25 мс. Результат считывания, при котором изменилась только строка 18, повторился при второй загрузке; участие RIR остаётся гипотезой.
Данные RIR на CMP 170HX 8GB показывают назначение этой области: она содержит 15 пустых инструкций ремонта и одну запись, меняющую значение фьюза в строке 18. Соответствующее слово опции можно отслеживать. Поскольку считанные данные RIR использует сам массив фьюзов в обход контроллера, нарушение их защёлкивания заметно при чтении сырой строки: обнаруженный переворот бита одинаково отражается и в слове опции, и в исходной строке фьюзов. Это даёт полезную временную отметку для изучения загрузки кристалла: RIR должен считываться раньше остальных фьюзов. Однако сам по себе такой глитч практической пользы не приносит.
3. Глитч «в самый раз»
Команда PWMVID: коэффициент заполнения 59,58% / 0,8333%, три импульса продолжительностью 2 мс после триггера: 979,94–981,94 мс, 983,94–985,94 мс и 987,94–989,94 мс.
На моей первой карте удачная последовательность из трёх импульсов, по всей видимости, нарушала только слова опций из строк 0 и 1, не затрагивая остальные фьюзы и слова. В этом состоянии все слова опций, производные от строк 0/1, равны нулю. Начальные значения были следующими:
|
Сигнал |
Начальное значение |
|---|---|
|
PCI ID и доступ |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Маски привилегий FUSECTRL/FUSEOPT |
|
|
Сырые строки 0 и 1 |
Обе по-прежнему |
На этом этапе запись FF ещё невозможна, поскольку ENABLE_FUSE_PROGRAM = 0. Честно говоря, я не понимаю, зачем значение ENABLE_FUSE_PROGRAM вообще может быть нулевым, если на серийных платах оно равно 1. Это очень похоже на «канарейку» для обнаружения глитча — по крайней мере, такой способ её реализации был бы изящным.
Фьюзы считываются построчно: все 32 фьюза строки получают питание для чтения по одной линии. Поэтому атакующему значительно сложнее добиться того, чтобы отдельный фьюз выглядел сброшенным или прожжённым. В такой схеме логично использовать фьюз-«канарейку», который при сбросе отключает критичные для безопасности функции, например прожиг фьюзов: обычно атакующий может повлиять на чтение в лучшем случае с точностью до строки. Поэтому, когда все слова опций строк 0/1 оказываются сброшены, ENABLE_FUSE_PROGRAM = 0 не позволяет прожечь ни один фьюз.
Однако в этом состоянии есть и другое важное значение: DISABLE_SW_OVERRIDE = 0. Обычно оно равно 1 и не позволяет установить регистр EN_SW_OVERRIDE в 1. Этот регистр управляет «затенением» (shadow) большинства слов опций, выдаваемых контроллером. Для этого записывается регистр CTRL_OPT_*, соответствующий слову опции OPT_*; он задаёт итоговое значение STATUS_OPT_*. Таким способом SBFE можно затенить нулём. Но даже при DSOV = 0 ENABLE_FUSE_PROGRAM остаётся одним из слов опций, которые затенению не поддаются. Кажется, тупик.
По крайней мере, так я думал и довольно долго безуспешно пытался найти выход. Затем моё внимание привлекла ещё не опробованная команда контроллера фьюзов SENSE_CTRL. Запускать её не хотелось: на первый взгляд она должна была вернуть всем словам опций из строк 0/1, то есть управляющих фьюзов, значения, заданные прожигом. В таком случае SBFE снова установилось бы, программное затенение отключилось и прожиг стал бы невозможен. К моему удивлению, команда действительно восстановила прожжённые значения всех управляющих опций, кроме DISABLE_SW_OVERRIDE, которое осталось равным 0.
При DSOV = 0 значение SBFE легко установить в 0, а ENABLE_FUSE_PROGRAM равно 1, поскольку совпадает с прожжённым значением. Теперь можно приступать. Остаётся одна сложность: у FUSEWDATA может быть закрытая PLM. Но при DSOV = 0 достаточно записать 0 в OPT_SECURE_FUSE_WDATA_WR_SECURE, чтобы PLM заполнилась единицами и хост получил доступ к прожигу.
Далее нужно вычислить слова _DISABLE, совпадающие со значениями _DEFECTIVE для нужных функций, и прожечь FF-записи. Следует учитывать, что занятая область FF и дефектные биты различаются от кристалла к кристаллу, поэтому каждый прожиг необходимо рассчитывать индивидуально.
Результаты
Разблокировка видеопамяти
На картах с номинальными 8 ГБ, у которых исправны все 80 ГБ памяти, разблокировка делает доступным полный объём. Судя по моей небольшой выборке, таких карт около 90%. Несколько синтетических тестов — запись псевдослучайных слов по всему объёму памяти и последующее чтение после инвалидации L2 — а также реальные нагрузки, включая vLLM и SGLang, работают корректно.
Как уже отмечалось, на одной из моих карт исправны только 64 ГБ. В её случае аппаратная разблокировка не увеличивает доступный объём памяти.
Разблокировка вычислительных блоков
В исходном состоянии 170HX ограничена 70 SM из 128. На практике в кристалле почти всегда исправны более 120 SM, а разблокировка позволяет задействовать их все. Прирост весьма заметен: примерно в 1,7 раза по сравнению с 170HX, разблокированной только программно, и около 1,2 раза относительно серийной A100.
|
Карта (ProjectPhysX OpenCL-Benchmark, FP16 half2 FMA) |
TFLOP/s |
По сравнению с серийной A100 |
|---|---|---|
|
CMP 170HX с программной разблокировкой |
50,129 |
0,69× |
|
Серийная A100 |
72,488 |
1,00× |
|
CMP 170HX с аппаратной разблокировкой |
85,861 |
1,18× |
Поколение PCIe
Единственное препятствие, мешающее cmpunlocker выйти за пределы PCIe Gen2, — слова опций FF. После сброса нужных битов Gen3 и Gen4 запускаются и, как подтверждают проверки, полноценно работают. Если дополнительно доработать развязывающие конденсаторы PCIe, можно получить PCIe Gen4 x16, как у серийной A100 в исполнении PCIe.
NVLink
Обнуление OPT_NVLINK_DISABLE — лишь одна из доработок, необходимых для работы NVLink. На плате CMP 170HX отсутствует микросхема U11, которая подключает питание 3,3 В от PCIe к выводу мостика NVLink. Поэтому на штатной плате генератор опорной частоты подключённых мостиков не запускается. Достаточно замкнуть два вывода на посадочном месте U11, но при этом теряются регулировка или защита, обеспечиваемые этой микросхемой. Соблюдайте осторожность при соединении мостиком GPU, питающихся от разных блоков: шины +3,3 В окажутся соединены, если не оставить U11 нераспаянной на части карт. Для нормальной работы мостика достаточно доработать U11 только на одной из двух плат.
Со стороны прошивки необходимо обойти проверку включения NVLink в ROM с помощью дополнительных команд с хоста. Ваша нейросеть наверняка поможет разобраться 😉
Изучая NVLink, я обнаружил ещё несколько интересных особенностей его реализации в GA100. Им будет посвящён отдельный материал — следите за обновлениями!
Дальнейшие планы
Произвольный прожиг фьюзов позволяет главным образом разблокировать функции. Некоторые важные для безопасности опции поставляются непрожжёнными, и их прожиг может открыть интересные возможности. Но меня больше привлекают глубокие состояния глитча, в которых многие прожжённые по умолчанию защитные фьюзы считываются как непрожжённые. Это открывает пути, например, к отладочному выполнению в HS-режиме, который предоставляет беспрецедентный доступ к внутреннему устройству кристалла.
Ссылки
-
Jon Pry, A Canary in the Crypto Mine: Defeating Stack Protection in a GPU Secure Coprocessor (2026).
-
Amogh Munikote, cmpunlocker (2026).
-
Otto Bittner et al., The Forgotten Threat of Voltage Glitching: A Case Study on Nvidia Tegra X2 SoCs (2021).
-
NVIDIA, US9230678B2: Integrated circuit having an enhanced fuseless fuse structure (2016).
-
TSMC, TEF07F32X32HD18_PHRM_C180518 electrical fuse datasheet, rev. 120A (2018).
-
hexkyz и SciresM, Je Ne Sais Quoi — Falcons over the Horizon (2021).
-
TechPowerUp, NVIDIA GA100 GPU specifications.
Примечания
-
По моим наблюдениям, из десяти прошедших через мои руки CMP 170HX 8GB лишь одна имела 64 ГБ исправной памяти; на остальных работали все 80 ГБ.
-
Хотя в статье «Canary in the Crypto Mine» упоминаются стабильные 80 ГБ на версии с 10 ГБ, добиться такого результата на реально встречающихся картах удалось очень немногим, если вообще удалось, и надёжных подтверждений немного. Не исключено, что некоторые 10-гигабайтные карты действительно оснащены 80 ГБ памяти, но, по данным сообщества, их доля, вероятно, крайне мала. Большинство случаев «нестабильной» разблокировки до 80 ГБ объясняется сочетанием кеширования в L2 и алиасинга памяти поверх фактически имеющихся 40 ГБ.
-
Для работы NVLink требуется небольшая аппаратная доработка из-за отсутствующего компонента на плате 170HX. Она описана выше в разделе о NVLink.
-
Не проверялось.
Похожие статьи
 Радиотелескоп LOFAR с рекордной детализацией запечатлел почти 63 000 источников радиосигнала во Вселенной
 Опрос Honor: опытным мастерам доверяют больше, чем талантливым новичкам
 Квантовая защита финансовых каналов вышла из лабораторий: в России её испытали на расстоянии 1200 км
 Китай вывел на орбиту спутник Pathfinder для изучения истоков Вселенной с помощью ракеты Long March 2D
 У Intel пока нет такого CPU: на фото показали будущий 256-ядерный процессор с кэшем 1,28 ГБ и разъёмом LGA 9324, который выпустят по техпроцессу 18A-P
 В поставку Astra Linux Server добавили службу каталога, СУБД и контейнеризацию
 Минцифры может установить минимальный взнос для операторов связи в 500 тысяч рублей — небольшие интернет-провайдеры рискуют не справиться с новым требованием
 TCL представила стиральные машины S3, сушилку с тепловым насосом и два многодверных холодильника