Как я создал личного помощника на домашнем сервере
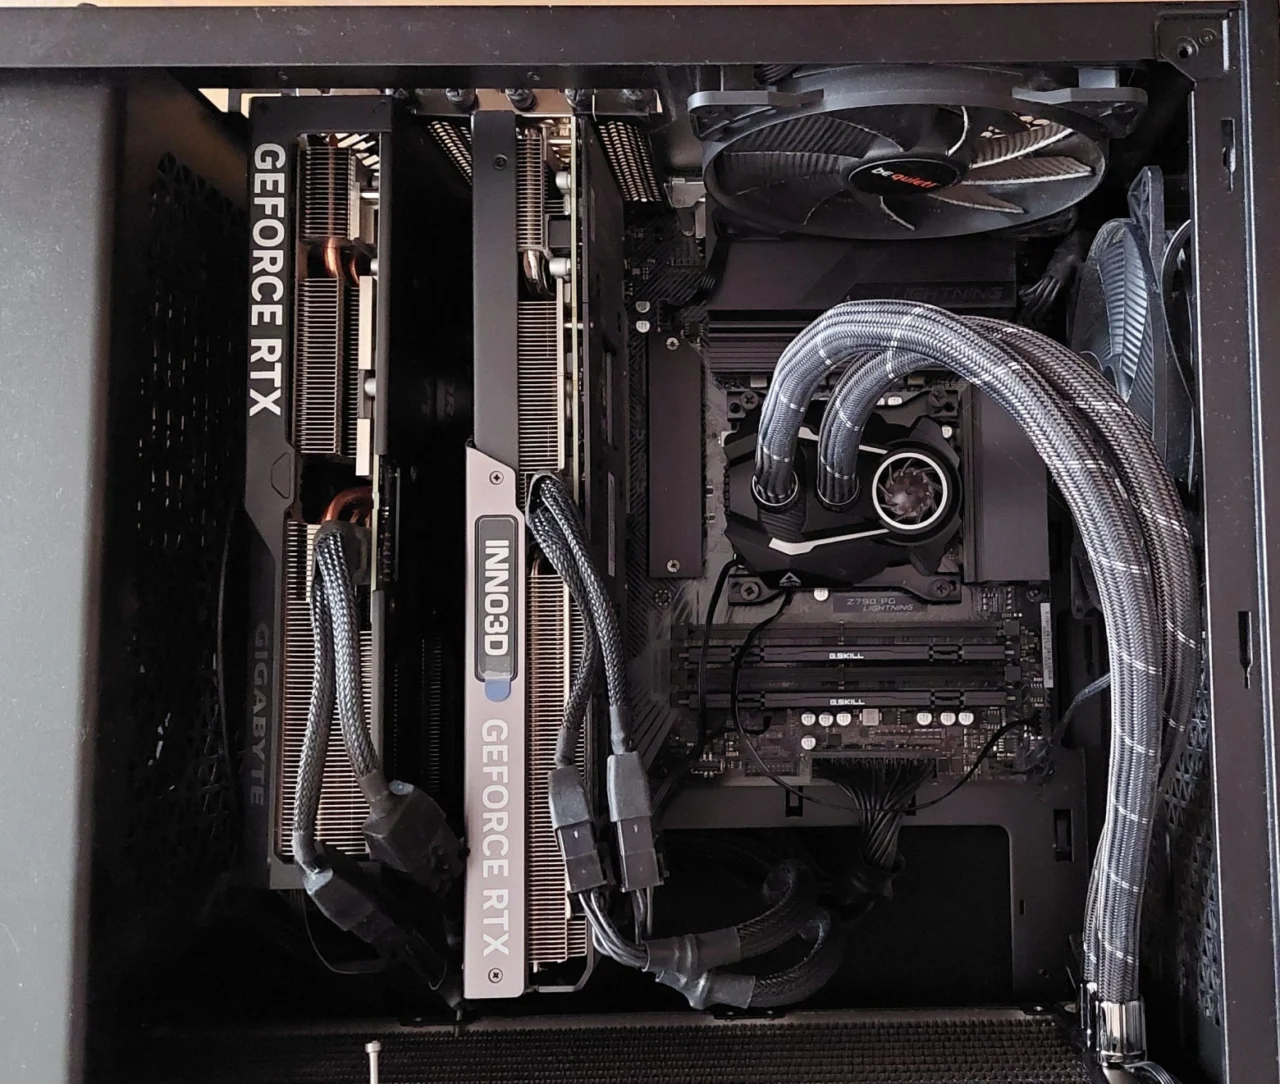
Две RTX 4070 Super и Ti в горизонтальном корпусе.
Резюме: Мне удалось развернуть автономного AI-ассистента на базе двух графических ускорителей с 12 ГБ видеопамяти на каждом. Архитектура объединяет языковую модель, RAG-поиск, графовую базу памяти, MCP-инструменты, средства распознавания и синтеза речи, а также глубокую интеграцию с локальной экосистемой. Система эффективно управляет документацией, почтовыми клиентами, календарями, мессенджерами, умным домом и рутинными бизнес-процессами. Ключевой вывод: для задач подобного уровня возможностей моделей класса 9B–27B параметров уже вполне достаточно. Локальный интеллект обретает истинную ценность не тогда, когда он соревнуется с облачными гигантами в «абстрактном мышлении», а когда получает в своё распоряжение долговременную память, набор специализированных утилит и способность напрямую влиять на физическое или цифровое окружение пользователя.
В период затишья возник замысел спроектировать персонального AI-агентство, адаптированное под мои персональные задачи и коммуникативные привычки. Базовое условие — полная локализация всех процессов: конфиденциальная информация, от корпоративных отчетов до личной переписки, не должна покидать пределы домашней сети. Второй немаловажный аспект — финансовая независимость от дорогостоящих и порой капризных облачных подписок. Обе эти проблемы близки и понятны огромной аудитории пользователей.
Список базовых компетенций персонального агента:
-
глубокая работа с разноформатными документами, междисциплинарный анализ смыслов, выявление скрытых взаимосвязей и их визуализация;
-
интеграция с внешними сервисами — экосистема Google (Calendar, Gmail, Drive), мессенджер Telegram (функции бота и отправка сообщений от моего имени), сторонние реляционные и нереляционные базы данных;
-
способность к самообучению и наращиванию экспертизы — по мере взаимодействия агент всё тоньше улавливает контекст и подстраивается под пользователя;
-
изначальная заточенность под голосовое управление, владение родным языком, качественная транскрипция речи с последующей LLM-обработкой и переводом;
-
круглосуточная автономность и проактивность в рамках ежедневного workflow — мониторинг датчиков умного дома, системных метрик и принятие решений без дополнительных запросов.
Как следует из перечня задач, фокус смещен на агентские навыки управления встроенным инструментами. Локальный помощник — это принципиально иной инструмент, нежели стандартный облачный чат-бот. Соответственно, отпадает необходимость в громоздких моделях свыше 35B параметров. Более того, большую часть времени система находится в режиме простоя, что снижает требования к аппаратному обеспечению и энергопотреблению. Именно так родилась концепция задействования имеющегося «домашнего» железа.
Аппаратная база
Глав водораздела между потребительскими десктопными комплектующими и серверными рабочими станциями — пропускная способность и количество линий PCI-Express (24–28 против 64–128). Разница в стоимости между этими классами оборудования достигает 3–5 раз. Из-за этого мы ограничены связью из одной или двух видеокарт. При выборе двухчиповой конфигурации неизбежно теряется половина пропускной способности шины PCIe (режим x8/x8, снижающий скорость с 63 ГБ/с до 31.5 ГБ/с для PCIe 5.0), а также падает скорость из-за накладных расходов на параллелизм вычислений (Pipeline Parallelism, когда модель дефрагментируется пополам, последовательно обсчитываясь сначала на одном GPU, а затем передаваясь через шину на второй).
С учетом ценовой политики на видеокарты уровня RTX 5090, где переплата вчетверо превосходит прирост производительности и объема VRAM менее чем в два раза, разумнее остановиться на сбалансированной сборке с двумя GPU среднего уровня. Особый интерес представляют версии Ti и Super линеек 5060, 5070 и 5080 с расширенным объемом видеопамяти до 48 ГБ. Поскольку ОС Windows задействует единый драйвер для пары графических адаптеров, во избежание конфликтов рекомендуется использовать однотипные карты одного поколения.
Отдельного внимания заслуживают вопросы тепловыделения и энергоэффективности. Для связки из двух RTX 5080 Ti в пике стоит рассчитывать примерно на 1 кВт, для 2x 5070 Ti — около 800 Вт (для сравнения, пара флагманских 5090 потребует полтора киловатта и жидкостное контуре). В режиме бездействия вся система потребляет скромные 50–70 Вт. Ниже мы оценим реальные показатели энергопотребления нашего 2x GPU ассистента.
Развертывание и настройка
Для экспериментов использовалась промежуточная конфигурация: пара ПК на базе Core i7 с 64 и 32 ГБ RAM соответственно, объединенных в парный кластер. В наличии имелись две видеокарты RTX 4070 (Super и Ti) с суммарным объемом VRAM 24 ГБ, а также RTX 3080 на 10 ГБ. Проверялись два сценария: 1) обе карты 4070 установлены в одном системном блоке, а 3080 — во втором; 2) карты 4070 распределены по разным компьютерам, а 3080 исключена из тестов. Интерфейс PCIe 4.0 в режиме x8 выдает порядка 15.75 ГБ/с, что медленнее решений пятого поколения — этот фактор также закладывался в расчеты. Нагрузочное тестирование показало энергопотребление каждой карты на уровне 110–120 Вт, при этом температура чипов не превышала 50–60 °C. Тем не менее, при вертикальной ориентации корпуса тепловой поток от нижнего ускорителя подогревает верхний, поэтому критически важен интенсивный продув корпуса или его горизонтальное размещение. Блока питания мощностью 850 Вт оказалось вполне достаточно.
В качестве программной платформы я протестировал anythingLLM, CrewAI и openClaw — три концептуально разных подхода к построению агентских систем. Увлекшись поначалу openClaw, я пришел к выводу, что оптимальнее использовать единого универсального агента, способного менять роли в три-четыре итерации. В результате я вернулся к anythingLLM, во многом благодаря уже готовой и отлаженной инфраструктуре для работы с документами и RAG.
Архитектура памяти агента: векторное хранилище на базе LanceDB в сочетании с графовыми структурами. Для этого был внедрен официальный сервер MCP Memory вместе с процедурой одновременной записи данных в векторный и графовый индексы. Языковая модель самостоятельно выделяет ключевые сущности, события и взаимосвязи между ними. Настоящим испытанием стала настройка интеграции google-workspace-mcp через протокол OAuth 2.0 и локальных TTS-моделей — без помощи облачных ассистентов (Gemini, ChatGPT, Claude) обойтись бы не удалось. По сути, один облачный интеллект помогал программировать локального бота.
Парк задействованных моделей охватывает весь спектр: микрогорбуны на 0.4B–2B (например, FunctionGemma), младшие агенты (8B–9B), средние (12B–14B) и старшие (26B–32B). Проводилось тестирование семейств Qwen, Gemma, Ministral и других. Сравнительные метрики для двухпроцессорной конфигурации приведены в таблице ниже. При длине контекста 30k–40k для работы с массивными текстами скорость генерации у моделей масштаба 27B оставалась вполне комфортной (>27 токенов в секунду), заметно различаясь при работе через Ollama (OL) и LM Studio (LM).
Сравнительный анализ производительности двухчиповой сборки (2x RTX 4070 Ti/Super)
|
Модель / Квантование |
VRAM (ГБ) |
Распределение (CPU/GPU) |
Контекст |
Скорость (токен/с) |
Нагрузка GPU1/GPU2 |
|
DeepSeek‑R1-Distill‑Qwen-32B‑Q4_K_S |
18.8 |
100% GPU |
4k |
23.4 (LM) |
50/50 |
|
Qwen3.8–27B |
17 ГБ |
100% GPU |
32k, 50k |
27.3 (OL), 58.4 (LM) |
50/50 |
|
Qwen3.8–27B |
|
100% GPU |
32k |
54.3 (LM) |
50/50 |
|
Qwen3.8–27B |
22 ГБ |
7% CPU / 93% GPU |
32k |
17.3 (OL) |
40/40 |
|
Gemma-4-26B‑Q4_K_M |
18 ГБ |
100% GPU |
8k |
93.26 (OL) |
50/50 |
|
Qwen3-14B Q4_K_M |
15 ГБ |
100% GPU |
32k |
48.8 (OL) |
50/50 |
|
Qwen3.5–9B_Q5_K_M |
8.2 ГБ |
100% GPU |
32k |
64.52 (OL) |
50/50 |
Порог выгрузки в оперативную память наступает при заполнении 19–20 ГБ, хотя утилита nvidia-smi фиксирует 22 ГБ свободной VRAM. Практические тесты с Ollama (версии 0.34.0) и LM Studio (версии 0.4.24) подтвердили, что из номинальных 22 ГБ под саму модель и контекст реально выделить около 19.5 ГБ.
Для обработки речи задействована модель whisper-large-v3 через бэкенд Lemonade — качество распознавания безупречное, транскрипция происходит практически мгновенно, без заметных задержек. Синтез речи (TTS) реализован через Speaches в связке с движком Piper (в Docker-контейнере), обеспечивающим естественное звучание приятного женского голоса со всеми необходимыми интонациями. Генерация графики возложена на модель SD-Turbo-GGUF (опять же через Lemonade). Штатный генератор диаграмм в anythingLLM был заменен на более гибкий Mermaid MCP. Дополнительно развернута Stability Matrix со Stable Diffusion Forge и сопутствующими весами, поскольку качественная визуализация данных имеет для меня принципиальное значение. Для удобного голосового ввода в сторонние программы настроена утилита typeWhisper, использующая инфраструктуру Lemonade. Мониторинг параметров окружающей среды и телеметрии умного дома автоматизирован с помощью компактного Python-сервера MCP. Весь программный стек запускается единым скриптом в фоновом режиме, абсолютно не отвлекая от повседневной работы за ПК.
Практическое применение
Одной из первых реализованных функций стал голосовой интерфейс для управления инфраструктурой Google: планирование встреч в календаре, составление расписания на неделю, подборка справочных материалов и прочее. Синергия Google Workspace и голосового управления колоссально экономит время — любые задачи решаются парой фраз, а в ответ система выдает наглядный графический отчет. Ассистент каждое утро формирует емкий дайджест по входящим письмам, сообщениям и новостной повестке, экономя по 10–15 минут на каждой рутинной процедуре.
Связка Transcriber + LLM стала настоящим прорывом: я использую её повсеместно для наброска писем, небольших заметок и формулирования идей, ускорив набор текста примерно в десять раз. На рынке множество транскрипторов, но главное преимущество моего решения — возможность RAG-индексации поверх локальной базы, полная конфиденциальность и дообучение на моих текстах. Речь не идет о генерации контента искусственным интеллектом: модель берет мои надиктованные мысли, облагораживает их лексику, устраняет стилистические ошибки и при необходимости безупречно переводит.
Интеграция с Telegram открыла возможности для удаленного контроля локального оборудования. Бот присылает уведомления исключительно в нештатных ситуациях, требующих вмешательства. Если же требуются подробности, достаточно запросить у агента развернутую сводку. Логичным продолжением этой идеи стало создание менеджера умных устройств. Традиционные агенты отправляют API-запросы в облачные шлюзы, как это реализовано, например, в нашей экспериментальной теплице (см. https://arxiv.org/pdf/2608.09949), что приводит к колоссальному расходу токенов. Локальная LLM со специализированной фито-моделью pllama-13b выступает бесплатной и полностью автономной альтернативой облачным аналогам, демонстрируя отличную стабильность даже при обрыве связи с внешним миром.
Фундаментальная задача ассистента — глубокая аналитика документов, на которую уходит львиная доля процессорного времени GPU. Система обобщает массивы текстов, выявляет неочевидные закономерности, логические противоречия и визуализирует связи. Помощник стал полноценным партнером по брейнштормингу: в режиме диалога мы генерируем концепции, опираясь на RAG, графовую память и Mermaid-схемы. Это незаменимый инструмент для интеллектуального труда, кардинально отличающийся от облачных ботов с их амнезией — локальный ассистент хранит контекст ровно столько, сколько это необходимо.
Логичным продолжением стала автоматизация документооборота и предварительного учета. Опыт пока накапливается, но даже с текущими объемами документов отдача ощутима. Система формирует цифровой слепок движения товаров и финансовой отчетности, самостоятельно сводит цифры, строит таблицы и подготавливает выводы в удобочитаемом виде. По предварительным оценкам, это закрывает до половины штатной единицы рядового сотрудника.
«Жизненный планировщик» помогает расставить приоритеты и отсечь информационный шум, представляя планы в наглядном графическом виде. Это важный элемент персонального тайм-менеджмента. Более того, инструмент постепенно эволюционирует в полноценную систему управления проектами (Project Management) с декомпозицией задач, контрольными точками и фиксацией результатов.
Младшие модели вроде Qwen3.5–9B меня приятно удивили: их ресурсов хватает для уверенного управления инструментами и перевода. Они реагируют мгновенно, прекрасно удерживают логическую цепочку действий и комфортно чувствуют себя в рамках одной видеокарты 4070. Старшие конфигурации на двух GPU выдают более глубокий аналитический срез — к примеру, при построении дорожной карты из текстового документа 9B-модель предложила линейную структуру, тогда как 27B-версия выстроила разветвленное древо с критическими точками, глубокими деталями и аргументированными замечаниями.
Зоны роста и текущие шероховатости
Периодически возникают курьезные ситуации, когда ассистент рапортует об успешном выполнении задания, хотя даже не обращался к соответствующим инструментам. Поскольку перечень задействованных утилит отображается в системном чате, этот процесс легко контролировать. По всей видимости, оптимальным решением будет делегировать запуск инструментов специализированному дообученному микрогорбуну, возложив на младшего агента исключительно надзорные функции.
Всем агентам остро необходима процедурная память для запоминания успешных паттернов поведения. Регламентация сценариев через готовые воркфлоу и навыки (skills) выручает, а каждый агент ведет подробный бортовой журнал в формате .md, однако индустрии требуется более формализованный и компактный инструмент.
Существует проблема перегрузки контекстного окна избыточным количеством подключенных инструментов, что дестабилизирует работу. Встроенные селекторы часто отключают нужную функцию в самый неподходящий момент, поэтому от них пришлось отказаться. На текущем этапе проблема решается оптимизацией: в распоряжении агента находятся только уникальные утилиты, сгруппированные по ключевым навыкам.
В целях безопасности агенту закрыт прямой доступ в открытый интернет — все запросы фильтруются через прослойку MCP-сервера. Угроза промпт-инъекций стоит крайне остро и со временем будет только нарастать. Любые обновления инструментов жестко контролируются и исключают несанкционированные апдейты.
Итоги и выводы
Первоначальная настройка и сборка заняли около недели. Финансовые затраты на железо составили ноль рублей, поскольку были задействованы имеющиеся комплектующие. В сухом остатке мы получили модульный конструктор, позволяющий оперативно внедрять новые компоненты, сохраняя абсолютную конфиденциальность данных. Стоимость аналогичных облачных сервисов составляет порядка $20–$40 ежемесячно.
Можно долго спорить о том, какой масштаб моделей необходим для повседневных задач. Тесты показали схожее качество логических цепочек у моделей от 9B до 27B, однако 27-миллиардные версии выдают более развернутые и глубокие ответы. Скорость генерации варьируется в зависимости от программной оболочки (сказывается влияние механизмов speculative и MTP decoding), но в целом она комфортна для живого диалога. За всё время повседневного использования не возникло ни единой ситуации, с которой ассистент не смог бы справиться. По сути, мы получили мощнейший ИИ-инструмент путем грамотной реорганизации домашней инфраструктуры.
Важно подчеркнуть: этот ассистент не заменяет специализированных кодеров или банальные чат-боты, хотя и обладает ценнейшим свойством абсолютной памяти. Это доверенный помощник, адаптирующийся под ваши привычки и берущий на себя 25–30% рутинной нагрузки. Интегрированный с локальным «железом» — системой умного дома, датчиками, 3D-фермой или теплицей — он становится надежным интеллектуальным менеджером, функционирующим даже при полном падении внешних облачных API.
Если в системе используется лишь одна видеокарта, вторая будет простаивать. Эту проблему можно смягчить, используя карты вроде 5060 Ti, но это станет узким горлышком при масштабировании на более крупные модели. Дополнительного энергопотребления по сравнению с обычным игровым режимом ПК замечено не было.
Итоговый вердикт: для создания комфортного ассистента под модели размером до 27B достаточно одной видеокарты с 24 ГБ VRAM либо связки из двух GPU по 16 ГБ. При текущей ценовой политике конфигурация из двух шестнадцатигигабайтных карт обойдется примерно вдвое дешевле топового одиночного флагмена, а падение скорости до 25–30 токенов в секунду абсолютно приемлемо.
Система с расчетом на будущее — это пара карт 5070–5080 Ti/Super с суммарными 48 ГБ памяти для запуска 70B-моделей, способных по ряду параметров конкурировать с ранними итерациями GPT-4. Дальше начинается кратный ценовой скачок. Предложенный подход идеален для небольших офисов и команд. Если перед вами стоит задача дообучения моделей или локального анализа массивов данных — это крайне доступный и эффективный путь.
В заключение отмечу: облачные чат-боты радикально снижают порог входа в технологии, с которыми в одиночку никто бы не рискнул связываться. В отличие от простых генераторов кода, продвинутый бот способен самостоятельно диагностировать сбои в локальной системе, выявлять корневые причины неполадок, тестировать гипотезы и находить рабочие решения. На моих глазах ассистент в итеративном режиме написал и отладил MCP-сервер, переконфигурировал окружение Windows и установил необходимые пакеты всего за полчаса. Полагаю, именно в этом синергетическом эффекте и кроется та самая технологическая революция, свидетелями которой мы сегодня являемся.
Похожие статьи
 Бюджетная зарядка Ugreen на 67 Вт для путешествий по всему миру поступила в продажу за $25
 Умный завод будущего от Xiaomi: скорость выросла в десять раз, а сбои устраняются за минуты
 Neuralink продемонстрировала, как парализованный пациент силой мысли передал слова «Я люблю тебя»
 Взлом цифровой «мыльницы» на x86 и ROM-DOS
 Представлен пассивный NAS Minisforum S5 на новейшем пятиядерном процессоре Intel с поддержкой 40 ТБ памяти
 SanDisk представила защищенный SSD E31: объем до 2 ТБ, USB-C и скорость 1000 МБ/с
 Очереди у Apple Store: новые iPhone 18 Pro раскупают с молниеносной скоростью
 Xiaomi выпустила посудомойку на 20 комплектов посуды с паровой сушкой при 115 °C