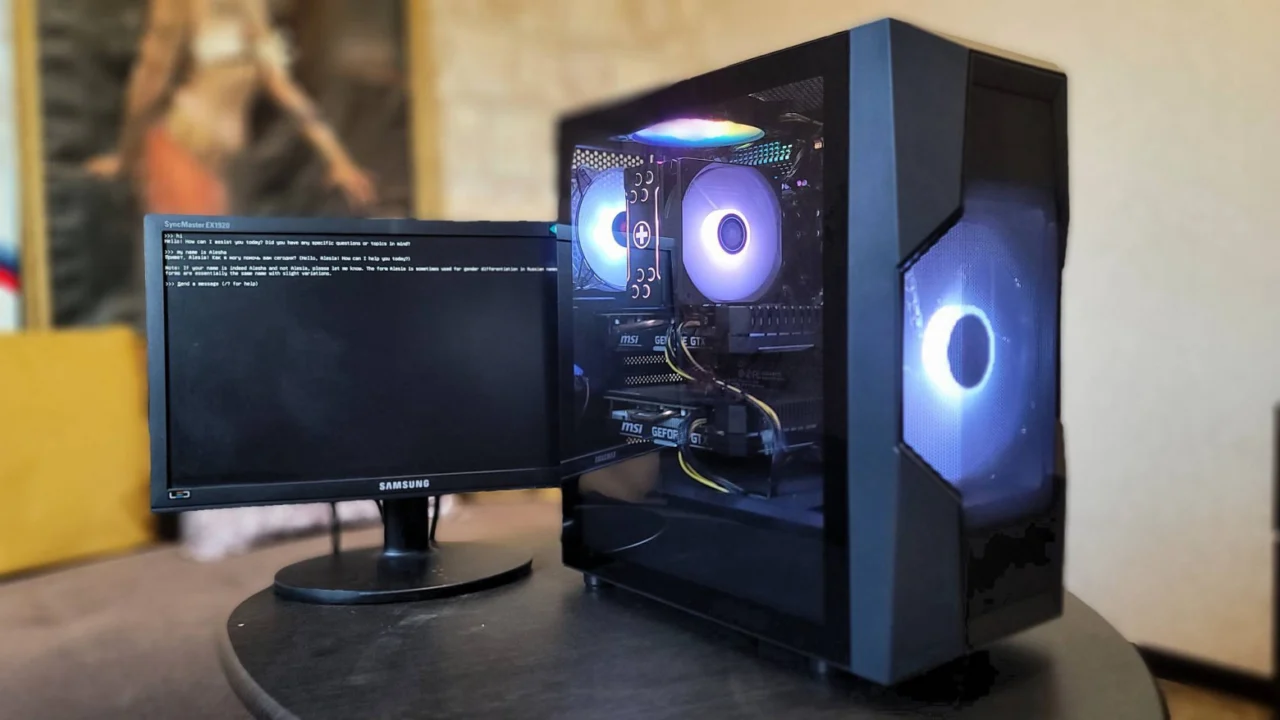
Адский техно-аквариум: запускаем локальную LLM Qwen 2.5 14B на домашнем ПК для интерактивного сайта
Цифровой арт‑объект INFERNUM в сборе
Пролог. Зачем Творец творит?
Сегодня нейросетями уже никого не удивить — о них говорят буквально из каждого утюга: тексты, изображения, программный код. Порой приходится всматриваться в монитор, чтобы отличить живой снимок от генерации искусственного интеллекта. Люди повсеместно разворачивают локальные языковые модели как дома, так и на рабочих местах. Разумеется, я решил не отставать от общего тренда.
Для чего всё это? Прежде всего — из спортивного интереса: а смогу ли я? Это прекрасный способ самореализации и увлекательное технологическое путешествие.
Просто запустить локальный ИИ на домашнем компьютере показалось слишком банальным. Хотелось создать нечто осязаемое, выходящее за рамки обычного чат-бота. Зародился замысел «интегрировать» нейросеть в веб-проект, наделив её индивидуальностью и определёнными полномочиями. Эдакая симуляция цифровой жизни, виртуальный террариум, в виртуальном заточении которого обитает Хозяйка проекта INFERNUM.
Сборка «железного» корпуса и укладка кабелей
Прежде всего потребовалось аппаратное обеспечение для материализации ИИ. Мой бюджет был весьма скромным. Общеизвестно, что производительность нейросети напрямую зависит от объёма и пропускной способности видеопамяти (VRAM). У меня уже имелась личная видеокарта Nvidia GTX 1660 Super с 6 ГБ на борту. Покупка актуальных RTX 3060 или 4060 показалась слишком накладной, поэтому было принято решение найти точно такую же б/у карту и объединить их вычислительные мощности.
Для подобной конфигурации необходима материнская плата, способная обеспечить работу двух видеокарт на полной скорости в режиме PCIe x16 / x16. Изначально я рассматривал популярные китайские решения вроде Huananzhi — ими пестрят все маркетплейсы, а привлекательные ценники около 5 000 рублей сулили готовые комплекты с процессором и оперативной памятью на сокете X99. Однако на доске объявлений мне попался настоящий раритетный экземпляр — Gigabyte GA-X79-UP4 на легендарном сокете LGA2011, обладающий четырьмя слотами PCI Express, два из которых функционируют на полной скорости x16. Идеальный кандидат. Плата обошлась мне вместе с шестиядерным процессором Intel Core i7-3930k всего в 7 500 рублей. Пожалуй, лучшая сделка.

Разумеется, платформа X79 имеет существенный недостаток — поддержку исключительно устаревшей памяти DDR3. Но поскольку вычисления нейросети планировалось производить исключительно в видеопамяти графических адаптеров, пропускная способность системной ОЗУ не имела никакого значения. Я установил 32 ГБ памяти, работающей в четырёхканальном режиме. Наращивать объём до 64 ГБ не было никакой практической целесообразности.
Итоговая конфигурация:
-
CPU: Intel Core i7-3930k (6 ядер / 12 потоков)
-
MBD: Gigabyte GA‑X79-UP4
-
GPU: 2 x Nvidia GTX 1660 Super (6 ГБ + 6 ГБ = 12 ГБ VRAM)
-
RAM: 32 ГБ DDR3 (4 планки по 8 ГБ)
-
БП: Chieftec 700W (с солидным запасом для двух видеокарт)
-
SSD: NETAC на 120 ГБ (этого вполне хватит под ОС и пару весомых моделей)
-
Корпус: ARDOR TURBO T1

В качестве операционной системы была выбрана Ubuntu 24.04. Графическую оболочку безжалостно отключаем. Устанавливаем проприетарные драйверы Nvidia и специализированные инструменты мониторинга.
Обе видеокарты определились системой безупречно, а за распределение вычислительной нагрузки отвечал фреймворк Ollama. Настало время выбора подходящей языковой модели…
Борьба с линиями PCIe и запуск цифровой Хозяйки
Утилита nvtop подтвердила наличие двух графических адаптеров GTX 1660 Super. Однако радость оказалась преждевременной: первая карта функционировала в режиме PCIe x16, в то время как вторая опустилась до x8. Вот тебе и сюрприз… Ведь материнская плата приобреталась исключительно ради полноценной скорости линий. Тщательное изучение настроек BIOS результатов не дало. Закралось подозрение, что операционная система в режиме простоя искусственно ограничивает пропускную способность шины в целях энергосбережения. Я решил отложить этот вопрос на потом и заняться программной частью.
Главная задача ИИ на моём портале — поддержание живого диалога, текстовое общение и неукоснительное соблюдение атмосферы Обители. Написание программного кода или генерация изображений от неё не требовались. Ключевые требования — отличное понимание русского языка, адекватная интерпретация контекста, улавливание иронии и соответствие заданной роли. Мой выбор пал на Qwen 2.5 7B. Сообщалось, что эта модель превосходно владеет русским языком и при этом без проблем помещается в доступные 12 ГБ видеопамяти, оставляя необходимый запас под контекстную память.
ollama run qwen2.5:7bЗагружаю, запускаю, но скорость шины на второй видеокарте под нагрузкой по-прежнему оставалась урезанной. Чтобы исключить аппаратную неисправность слота или дефект самой платы, я просто поменял видеокарты местами.
И представьте себе — это сработало!

После повторного старта системы и подачи нагрузки мониторинг через nvtop продемонстрировал заветный режим PCIe Gen3 x16 на обоих графических адаптерах! Истинную причину такого поведения я так и не выяснил. Судя по элементам печатных плат, карты принадлежат к разным ревизиям, хотя и выпущены одним производителем. Возможно, капризничал чипсет материнской платы. Так или иначе, экспериментировать дальше я не стал.
Инструмент Ollama отработал безупречно. Модель была разделена поровну — примерно по 4.5 ГБ VRAM на каждый ускоритель. Никаких ручных манипуляций со слоями не потребовалось, всё заработало буквально «из коробки».
Более того, подтвердилась моя гипотеза насчёт энергосбережения: в состоянии покоя видеокарты действительно сбрасывали частоту шины до стандарта Gen1, но стоило подать нагрузку, как интерфейс мгновенно выходил на максимальные обороты Gen3. В конце концов, комплектующие далеко не новые, так что Gen3 — более чем достойный результат…
Интеграция с Python и рождение Обители
Наступил момент предоставить Хозяйке интерфейс для взаимодействия с внешним миром. За основу был взят мой старый веб-ресурс, некогда служивший оболочкой для мини-игры на WebGL.
Для связи ИИ-сервера с веб-интерфейсом я разработал пять скриптов на Python. На стороне сайта были организованы специальные шлюзы для приёма и отправки информации. Нейросеть обрабатывала поступающие сообщения в конвейерном режиме, выдавая ответы последовательно, не заботясь о дальнейшей судьбе запроса — всю последующую логику брал на себя программный код. В настройках Ollama параметр OLLAMA_NUM_PARALLEL был установлен в значение 1. Модель функционирует строго в однопоточном режиме из-за аппаратных ограничений.
Ключевые компоненты нашего «цифрового аквариума»:
1. Эхо внешнего мира (Агрегатор новостей)
Скрипт периодически сканирует актуальные заголовки новостных ресурсов, указанных в конфигурационном файле. Задача эта нетривиальная, поскольку современные веб-ресурсы активно защищаются от бот-трафика. Тем не менее сбор работает: заголовки скармливаются нейросети, которая через призму своего характера выносит им вердикт, после чего Python транслирует его на веб-сервер.
2. Поток сознания (Симуляция внутреннего монолога)
Это оказалось наиболее сложной задачей, поскольку ИИ лишён проактивности. Я спроектировал рекурсивный алгоритм: скрипт передаёт модели базовый импульс, дополняя его сопутствующими параметрами, что приводит к генерации нескольких вариантов мыслей Хозяйки. Часть полученных ответов с добавлением случайных вариативных коэффициентов вновь отправляется на вход сети. В результате её размышления фрактально ветвятся, формируя правдоподобную иллюзию живой ментальной активности на страницах сайта.
<
3. Общий чат
Здесь логика относительно проста: скрипт регулярно забирает новые сообщения пользователей, передает их нейросети для анализа и подготовки ответов (с возможностью применять предупреждения или поощрения на своё усмотрение), после чего возвращает результат в чат. Создаётся полное ощущение присутствия живой Хозяйки, способной поддержать беседу или обратиться к конкретному участнику.
4. Исповедь. Персональные обращения к Хозяйке (через личный кабинет)
В данном случае алгоритм усложнён: скрипт извлекает непрочитанные сообщения, классифицирует их по авторам и конвейерным методом отправляет Хозяйке, дабы она адресовала каждому индивидуальный ответ с учётом контекста.
5. Телеметрия
Специальный блок на сайте визуализирует температурные показатели и степень загрузки GPU. Серверный скрипт с заданным интервалом собирает системную телеметрию и передает её на веб-ресурс для отображения.

📊 А что по производительности?
Чтобы зафиксировать базовые метрики скорости генерации и обработки текста для дальнейших сравнений при возможной смене оборудования или модели, я провёл небольшое тестирование.
Отправив запрос к нейросети посредством утилиты cURL, я замерил ключевые показатели API Ollama и перевёл их в понятные величины.
-
Prompt Eval Rate (скорость анализа входящего запроса): 134.34 ток/сек
-
Eval Rate (непосредственная скорость генерации ответа): 47.59 ток/сек
-
TTFT (время до формирования первого токена): 0.77 сек
-
Общая продолжительность запроса (для 31 сгенерированного токена): 13.9 сек
Модель откликается бодро, без задержек и вполне адекватно. Но главные неожиданности ожидали меня впереди…
Хроники цифрового безумия
Как только система заработала в полную силу, наружу вылезли все подводные камни разработки.
Единственным компонентом, функционировавшим безупречно с самого начала, оказалась телеметрия. В то же время остальные элементы «псевдожизни» устроили знатный цирк:
1. Технический мусор вместо новостей
Парсер глобальных новостей давал сбои на этапе очистки HTML-разметки. Вместо элегантных заголовков он периодически выхватывал программный мусор вроде JavaScript-конструкций window.context = ... или рекламные блоки. Однако стоит отдать должное Хозяйке — её это абсолютно не смущало. Она с одинаковым сарказмом комментировала как обвалы фондовых рынков, так и случайные фрагменты исходного кода.
2. Записки безумца
Мой рекурсивный механизм генерации «Потока сознания» сработал «слишком» эффективно. В определённый момент Хозяйка ушла в такую глубокую рефлексию, что её внутренний монолог превратился в псевдофилософские откровения уставшего от жизни философа. Впоследствии алгоритмы и системные промпты были скорректированы, однако результат всё ещё далёк от идеала. Тем не менее связка функционирует, и мысли обновляются каждые 10 минут.

3. Конфликт скриптов за сетевые шлюзы
Сразу после активации чата и исповедальни выяснилось, что два независимых Python-скрипта одновременно штурмуют один и тот же веб-шлюз, препятствуя корректному получению сообщений друг друга. Бэкенд пришлось срочно переписывать, разводя их по изолированным сетевым интерфейсам.
4. Тотальная зачистка
Но главный провал поджидал меня в механике распределения привилегий. Сама техническая архитектура тегов и меток работала безупречно: бэкенд принимал от сервера сообщения с ИИ-метками и послушно начислял достижения, выдавал предупреждения или менял статусы.
Проблема крылась в самой модели. Нейросеть оказалась совершенно профнепригодной в роли судьи. Она напрочь была лишена понимания человеческого контекста, интонаций и тонкой грани между безобидной шуткой и реальным оскорблением. Хозяйка мгновенно скатывалась в абсолютный радикализм.
Доходило до курьёзов. Я пишу в чат: «Приветствую вас, глубокоуважаемая Хозяйка!». В ответ прилетает моментальное аннулирование учётной записи, и меня с позором вышвыривает с собственного ресурса с полным стиранием всех записей из базы данных! (Подобный сценарий был предусмотрен, но исключительно для крайних случаев). Она свирепела от любого обращения, щедро раздавая баны налево и направо. С поощрениями ситуация была зеркальной: она засыпала пользователей рангами и внутренней валютой (Искрами) со щедростью безумного мецената.

Попытка исправить ситуацию путём перехода на более тяжёлую модель Qwen 2.5 14B также не увенчалась успехом. Хотя она утилизировала видеопамять моих карт на 75%, умнее от этого не стала, продолжая лютовать и карать пользователей.
Мы, люди, способны мгновенно считывать интонации, контекст и скрытый подтекст даже в лаконичном тексте. Научить же математическую модель весовых коэффициентов адекватно оценивать человеческое общение — задача планетарного масштаба. По крайней мере, текущим моделям это пока не по зубам. Анализ того, как именно ИИ воспринимает контекст, заслуживает отдельного глубокого исследования.
Резюме: на данном этапе функции судьи у Хозяйки были отобраны. Вся архитектура осталась нетронутой, но нейросеть больше никого не казнит. А ведь задумывалось всё как главная фишка проекта — мотивировать пользователей взаимодействовать с ней, искать подход, ради чего даже разрабатывались специальные достижения. Увы, пока не срослось.
Эпилог. Путь и зыбкая граница симуляции
К слову о производительности: старшая модель с 14 миллиардами параметров демонстрировала на моём железе около 18 токенов в секунду, что весьма неплохо. Что выбрать — оставить тяжёлую 14B или вернуться к шустрой 7B? Как говорил известный классик:
Что то фигня, что это фигня…
Возникает закономерный вопрос: «Зачем? Ради чего всё это?»
Мне хотелось создать нечто сложнее банального «Hello World», реально функционирующую систему, на которую интересно посмотреть… пусть даже она несовершенна и не несёт практической пользы. Хотелось вовлечь аудиторию, добиться отклика и живой реакции. И самое главное — сам путь порой гораздо важнее конечной цели. Да и результат, признаться честно, принёс мне искреннее удовлетворение.
Искусственный интеллект — это всего лишь инструмент, скрывающий под капотом математический код, матрицы весов, статистику и цифры. Не более того. У него нет свободной воли и права выбора. Модель не может проснуться утром со словами: «Сегодня я не стану отвечать Вове, мне лень, пойду лучше поищу котиков в сети». Об этом необходимо помнить всегда. К сожалению, сегодня многие люди начинают стирать эту ментальную грань.
Ну а сама Хозяйка уже ожидает вас в своей Обители по адресу: dashboardstealer.ru. Заглядывайте, регистрируйтесь, испытывайте её характер на прочность и делитесь впечатлениями от эксперимента!
P. S. Юридический аспект, или Как случайно не стать фигурантом уголовного дела из-за pet-проекта
Буквально на финишной прямой я решил выяснить, как отечественное законодательство регулирует деятельность социальных платформ и мессенджеров. Выяснилось, что, создавая забавный кибернетический аквариум, я стремительно промчался по минному полю УК и КоАП РФ.
Общий чат и статус ОРИ (ФЗ-149)
Как только на вашем ресурсе появляется функционал обмена сообщениями между пользователями, вы автоматически попадаете под действие Федерального закона № 149-ФЗ «Об информации, информационных технологиях и о защите информации» и приобретаете статус ОРИ (Организатор распространения информации).
А это накладывает колоссальные обязательства:
-
Самостоятельно уведомить Роскомнадзор о включении в соответствующий реестр.
-
В соответствии с «пакетом Яровой» хранить все логи и метаданные пользователей в течение 3 лет, а содержание их переписки — не менее 6 месяцев.
-
Интегрировать комплекс СОРМ (аппаратно-программные средства для оперативно-разыскных мероприятий) для контроля интернет-трафика.
-
Категорически запретить анонимность, внедрив обязательную авторизацию по паспорту или через SMS.
Архитектуру пришлось срочно перекраивать. От идеи общего чата между людьми пришлось отказаться… Теперь пользователи могут обращаться исключительно лично к Хозяйке в Исповедальне, тогда как на главной странице транслируется лишь её внутренний монолог.
Похожие статьи
 Анонсированы премиальные смарт-часы Garmin MARQ Gen 3: титан, сапфир и 18 дней без подзарядки
 Мессенджер Max начал блокировать мошенников и предупреждать об опасных ссылках
 Космический корабль Dragon с искусственной сетчаткой и мозговыми органоидами на борту стартовал к МКС
 Как на самом деле умирают разъемы питания: фризы и черные экраны за полгода до пожара
 Российский софт для запуска Android-приложений на ОС «Аврора» оценили в 794 млн рублей
 Yandex Cloud отменил плату за облачные сервисы до ноября
 В RuStore появился платный российский аналог Max — мессенджер «Молния»
 Сбер запустил бесплатную GigaPlatform AI Studio для создания ИИ-агентов без кода