Как вовремя отказаться от NAS: домашнее ZFS-хранилище из старого железа с самопроверяемыми бэкапами
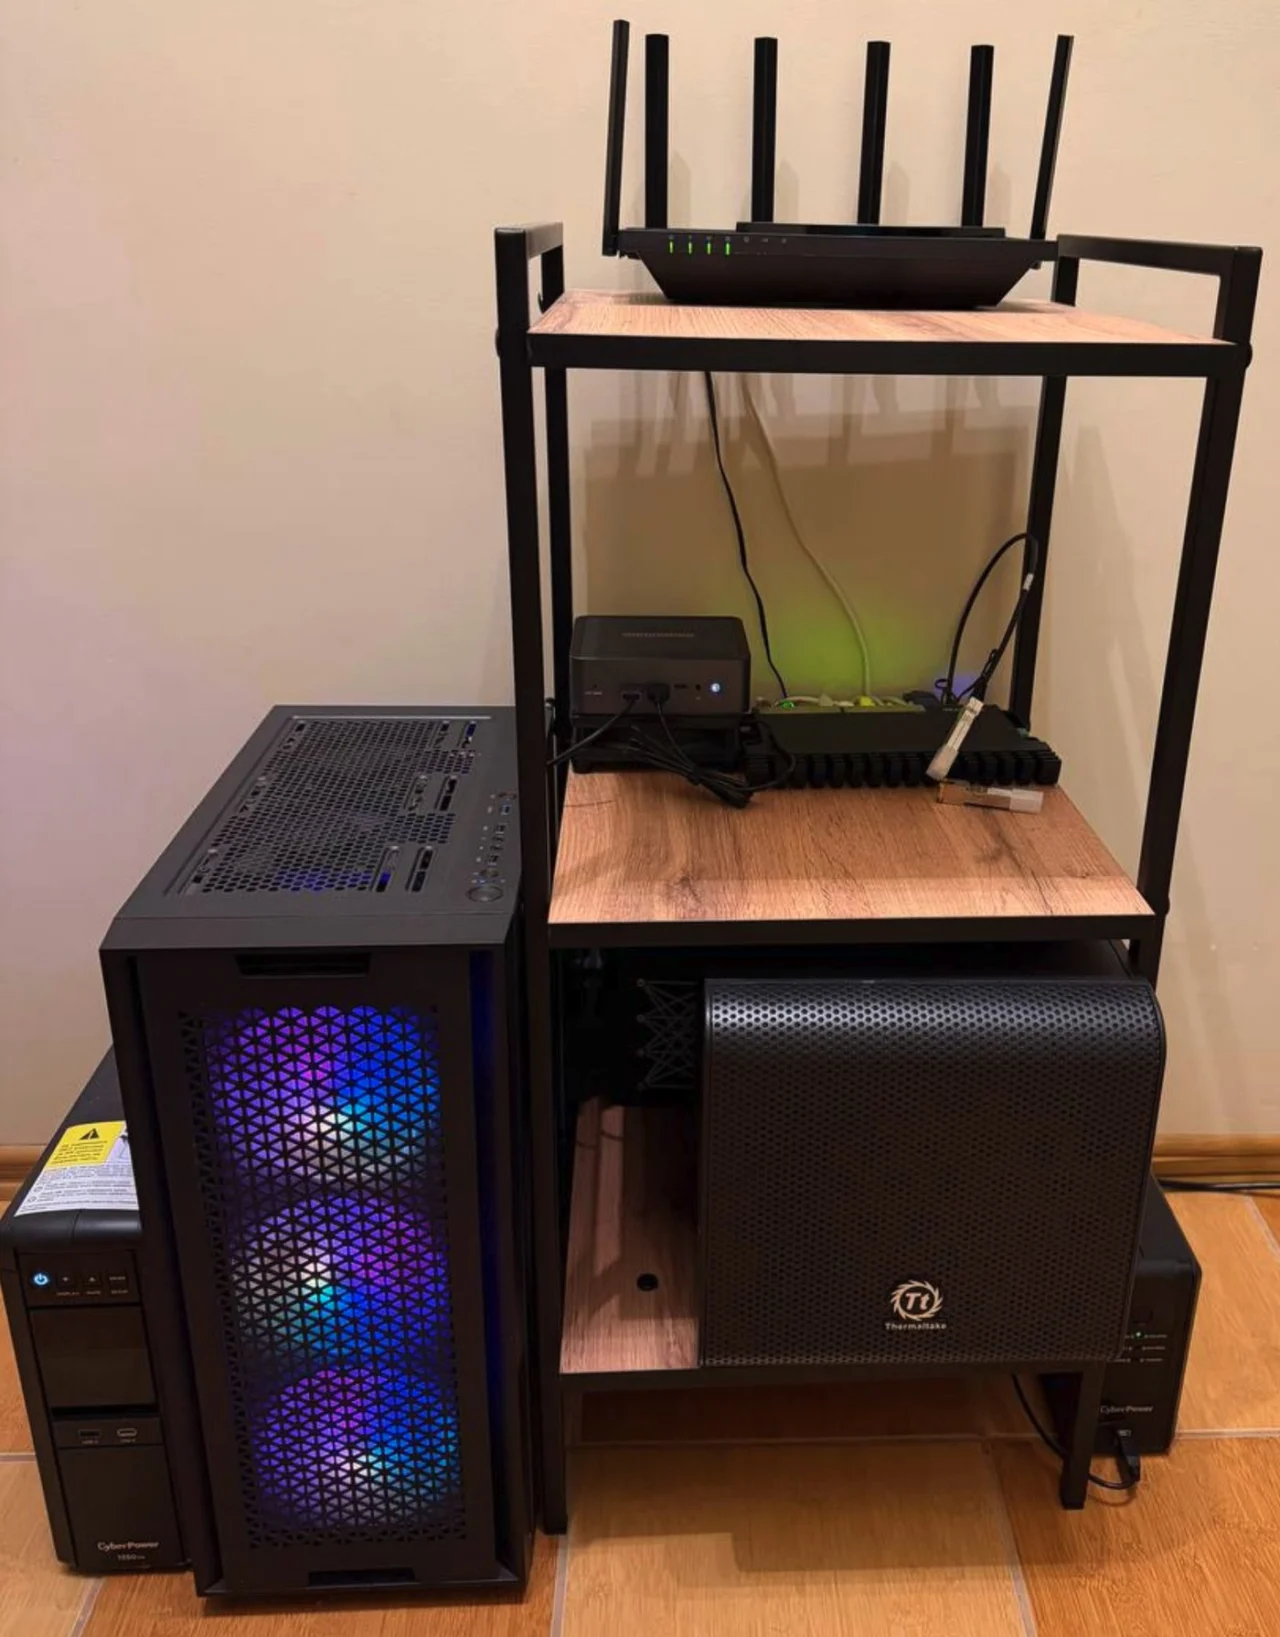
Та же стойка-обувница: наверху роутер, на средней полке мини-ПК с платформой и MikroTik, внизу новый NAS. Слева GPU-нода, по краям два ИБП.
Привет, SE7EN. Примерно месяц назад я рассказывал о том, как самостоятельно развернул инфраструктуру для AI прямо под рабочим столом. Та публикация задержалась ровно на сутки, поскольку в день релиза мне пришлось экстренно реанимировать NFS. Спустя три недели мой ветеран QNAP TS-220 окончательно вышел из строя, а аккурат под вечер того же дня знакомый прислал перечень б/у комплектующих с вопросом: «Не хочешь забрать под NAS?».
В этом материале речь пойдет о логичном продолжении этой истории: создании домашнего хранилища на ZFS из вторичного железа, трехуровневой системе резервного копирования и, что критически важно, автоматизированных тестах восстановления. В обсуждениях к прошлой статье читатели справедливо отмечали, что владение собственным «железом» требует немало времени на обслуживание. Мой свежий опыт — как раз о том, куда исчезают эти часы. Грабель на пути оказалось с избытком, и почти все они ударили по бэкапам.
Как умирал QNAP
На плечах старенького QNAP лежало две задачи: хранение ночных снапшотов платформы и синхронизация данных Gitea по протоколу NFS. Использование NFS для репозиториев было сомнительным решением, хотя на первых порах казалось удобным.
За последние тридцать дней произошло три тревожных инцидента:
-
29 августа. Внезапно перестал отрабатывать
git push. Сетевые порты открыты, контейнер Gitea рапортует статус Up, веб-интерфейс отдает код 200, однако в логах SSH красуется ошибкаstale file handle. Демон NFS на QNAP завис после 280 дней беспрерывной работы — помог лишь жесткий рестарт самого устройства. -
22 сентября, вечер. Повторение августовского сценария (внеплановая перезагрузка основного сервера из-за kernel oops). Монтирование NFS не успело завершиться за выделенные 90 секунд, вследствие чего Gitea поднялась на пустой локальной директории и радостно предложила провести «первичную инсталляцию». Пока я пытался разобраться в ситуации, повторная команда
mvповерх зависшего маунта стерла актуальные файлы — 1,1 ГБ и шесть репозиториев улетели в/var/tmp. К счастью, данные удалось вернуть без потерь, но осадок остался. -
Полтора часа спустя. QNAP окончательно завис намертво: веб-интерфейс и SSH перестали отзываться. Пришлось обесточивать принудительно.
Выводы были сделаны незамедлительно: рабочие файлы Gitea переехали на локальный NVMe-накопитель сервера, а NAS отныне используется исключительно как целевой адрес для ночных бэкапов. С тех пор действует незыблемый принцип: продакшн-данные не должны храниться на сетевых хранилищах — NAS предназначен исключительно для их копий.
И тут как раз подоспело то самое предложение по железу.
Аппаратная часть
Приобретенный у знакомого комплект включал:
-
материнскую плату ASRock H570M-ITX/ac в паре с процессором Intel Core i3-10100;
-
корпус Thermaltake Core V1 и блок питания на 400 Вт;
-
пару серверных SSD Intel DC S3610 емкостью по 480 ГБ с защитой от сбоев питания (PLP);
-
накопители Samsung 870 EVO (1 ТБ), Toshiba DT01ACA200 (2 ТБ) и WD Black (2 ТБ);
-
переходник M.2 на 6 SATA на контроллере ASM1166, коммутационные кабели и салазки;
-
жесткий диск Toshiba X300 на 10 ТБ.
Первоначальные затраты составили 50 тысяч рублей плюс покупка десятитерабайтного винчестера. Спустя неделю в проект было инвестировано еще 26 тысяч: старый i3 уступил место б/у процессору i7-11700, объем ОЗУ вырос до 64 ГБ (комплект 2×32 ГБ, частично полученный обменом на прежние Ryzen 5 5600X и оперативку Fury Beast RGB, оставшиеся от GPU-ноды). Также добавились низкопрофильный кулер, фронтальный вентилятор диаметром 200 мм и внешняя дисковая корзина, поскольку вовнутрь компактного корпуса все компоненты физически не поместились (была попытка использовать напечатанную на 3D-принтере конструкцию, но не срослось).
Замена процессора диктовалась архитектурными ограничениями чипсета для 10-го поколения. Полноценная поддержка частоты памяти DDR4-3200 и верхнего слота M.2, работающего напрямую от линий процессора, раскрывается только на 11-м поколении (i3-10100 официально ограничен планкой в 2666 МГц). После апгрейда прогон Memtest86+ прошел абсолютно безупречно. Низкопрофильный кулер выбран не от хорошей жизни — корпус Core V1 не приемлет башни выше 140 мм, поэтому теплопакет процессора вдолгую был ограничен 65 Вт. Заводской кратковременный лимит мощности (PL2), как выяснилось при детальной ревизии перед написанием статьи, составлял аж 224 Вт вместо положенных 95 Вт. Перед публикацией я выставил лимит в 95 Вт и проверил под нагрузкой: все 16 потоков молотили 75 секунд. Первые двадцать секунд чип честно брал 95 Вт, удерживая частоту 3,6–4,4 ГГц при нагреве до 59 °C, после чего плавно переходил на штатные 65 Вт (2,8–2,9 ГГц) с температурами около 50 °C. Скромный кулер справляется с колоссальным запасом — заводские 224 ватта процессору были совершенно ни к чему.
Вдобавок ко всему, пара трехтерабайтных дисков перекочевала из старого QNAP. Перед вводом в эксплуатацию вся восьмерка накопителей прошла глубокое тестирование SMART. Самый пожилой из них — накопитель Seagate с наработкой в 58 тысяч часов — был отправлен в зеркальный массив под особый контроль.
Готовый NAS занял свое законное место в той же обувной стойке рядом с остальным «зоопарком» оборудования, сохранив общую преемственность.


Структура пулов: зеркала, SLOG и бескомпромиссные одиночки
|
Пул |
Диски |
Что живёт |
|---|---|---|
|
|
два зеркала: 2+2 ТБ и 3+3 ТБ, zstd, ≈ 4,5 ТБ |
бэкапы, фото семьи, история мониторинга, общие файлы |
|
|
зеркало из двух S3610 |
базы и конфиги контейнеров |
|
|
Toshiba X300 10 ТБ, одиночный |
фильмы и музыка |
|
|
NVMe 480 ГБ, одиночный |
недокачанные торренты, транскодинг, CI |
|
система |
Samsung 870 EVO, ext4 |
ОС и docker |
NAME      SIZE  ALLOC   FREE    CAP    HEALTH
fast      428G  1.72G   426G     0%    ONLINE
media    9.09T  1.11T  7.98T    12%    ONLINE
scratch   444G  1.32G   443G     0%    ONLINE
tank     4.53T   260G  4.28T     5%    ONLINE
Выбор в пользу зеркал, а не RAIDZ. Использование накопителей разной емкости делало RAIDZ неэффективным: конфигурация из дисков 2+2+3+3 свела бы общий объем к минимальному значению в 2 ТБ. Зеркала масштабируются парами, ресильвинг происходит стремительно, а вторая пара дисков была успешно интегрирована в систему сразу после освобождения накопителей из QNAP.
Использование SLOG. На базе тех же S3610 организован зеркальный SLOG объемом 16 ГБ. Сразу оговорюсь во избежание споров: SLOG ускоряет исключительно операции синхронной записи. В моем сценарии именно так и происходит — бэкапы поступают с основного сервера по протоколу NFS, который по умолчанию задействует синхронную запись. Именно поэтому требования к SSD здесь бескомпромиссные (наличие PLP): обычный потребительский накопитель может отрапортовать об успешной записи в кэш, хотя физически данные еще не сохранились.
Одиночный диск без отказоустойчивости. Пул media функционирует на одиночном винчестере осознанно. Фильмы всегда можно скачать повторно, в отличие от семейного архива фотографий. По этой причине снимки хранятся на зеркальном пуле tank, а не на емком, но уязвимом диске.
Изолированный «мусорный» пул. Все динамически изменяемые и некритичные данные отправляются на scratch без использования снапшотов. В противном случае автоматические снимки основного пула мгновенно раздувались бы от каждого промежуточного торрент-файла.
Поверх настроены ARC емкостью 24 ГиБ, автоматические снапшоты и регулярный scrub во второе воскресенье каждого месяца. Доступ извне полностью перекрыт: задействована исключительно локальная сеть и строгие правила ufw с политикой запрета по умолчанию. Этот урок усвоен после сентябрьского инцидента, когда из-за бреши в публично доступной веб-аналитике в контейнер на основном сервере проник майнер. Оставлять сервис «смотрящим» в интернет было моим решением — и моей ошибкой.
Этапы миграции с защитой от сбоев
Развертывание основных сервисов заняло три дня (25–27 сентября) и выполнялось по четким скриптам. Каждый этап завершался обязательной проверкой: успешность монтирования, сверка контрольных сумм и дампов, прохождение restic check. Старый QNAP оставался в строю в качестве страховочного узла до утренней валидации ночных бэкапов на новом месте, после чего его диски были интегрированы в пул tank в качестве второго зеркала.
Процесс шел в кооперации с ИИ-агентами, которые писали скрипты, в то время как на мне оставалась аппаратная часть и ручное выполнение команд с привилегиями sudo. О специфике такого симбиоза я расскажу в отдельной статье, а сейчас важно отметить другое: даже при строгой дисциплине не удалось избежать ошибок. Обе оплошности коснулись бэкапов, но прежде стоит описать общую схему их организации.
Архитектура резервного копирования
Каждую ночь происходят следующие процессы:
|
Время |
Что |
Куда |
|---|---|---|
|
03:30 |
зеркало данных Gitea |
NAS, отдельный датасет |
|
04:00 |
дампы основной базы и базы хелпдеска, архив всех docker-томов |
NAS, хранение 30 дней |
|
04:30 |
restic: полный дамп PostgreSQL, файлы пользователей из MinIO, данные, секреты и релизы платформы |
зашифрованный репозиторий на GPU-ноде по SFTP |
|
следом |
|
третий репозиторий на NAS |
Дополнительно ведутся снапшоты ZFS, а в 09:00 специальный сторожевой скрипт проверяет актуальность и объем каждого слоя бэкапа, отправляя отчет в Telegram.
Контроль размера архивов был внедрен после неприятного инцидента минувшим летом. В один прекрасный день ночной дамп главной базы весил ровно 20 байт: утилита pg_dump аварийно завершилась, утилита gzip в конце конвейера честно вернула нулевой статус, а сам скрипт отрапортовал об успехе. С тех пор во всех сценариях используется set -o pipefail, проводится валидация размеров и функционирует независимый сторож, который не полагается на отчеты скриптов на слово.
Грабли №1: ротация, уничтожившая репозиторий
В процессе переезда третий репозиторий restic был размещен внутри директории /tank/backups. Именно в этой папке ночной скрипт очистки по расписанию удаляет все файлы старше 30 дней с помощью конструкции find -mtime +30 -delete. Синхронизированная копия при этом сохранила оригинальные таймстампы файлов.
В 04:09 первой же ночи утилита очистки стерла из репозитория файл config, ключи и 111 пакетных файлов. К 04:30 команда restic copy выдала фатальную ошибку об отсутствии репозитория. Утренний сторож зафиксировал отставание слоя, и к полудню архив был успешно восстановлен с еще функционировавшего QNAP — уже в выделенный датасет со своими правилами экспорта.
Выводы очевидны:
-
Для каждого потребителя хранилища выделяется отдельный датасет. Ротация по возрасту и дедуплицированные репозитории не должны пересекаться: для restic старый пакетный файл — это ценные данные, а не мусор.
-
Не спешите выключать старое хранилище, пока новое не отработает в штатном режиме хотя бы сутки. Наличие живого QNAP превратило потенциальную катастрофу в заурядный курьез.
Грабли №2: бэкап, который молча самоустранился
Второй сбой носил тихий характер, оттого и был опаснее. В systemd-юните задачи бэкапа Gitea осталась устаревшая директива
RequiresMustsFor, указывавшая на демонтированный путь старого QNAP, хотя сам скрипт уже давно перенаправлял потоки на новый NAS. Пока старый путь оставался доступным в системе, всё работало гладко. В начале октября задание начало стабильно завершаться с ошибкой «NAS не смонтирован».Четыре ночи подряд система молчала без единого алерта. Сторожевой скрипт контролировал основные уровни бэкапов, но за свежестью маркера успешного завершения Gitea никто не следил. Пропажу обнаружили случайно: ИИ-агент проверял накопитель по стороннему вопросу и обратил внимание, что метка последнего успешного сохранения датирована 90 часами назад.
Исправление заняло одну строчку в конфигурационном файле юнита, но главный вывод звучит так: контролировать нужно возраст последней успешной операции, а не сам факт отсутствия ошибки в текущем запуске. Задача, которая не стартовала вовсе, не генерирует ошибку — она просто не выполняется. Теперь для каждого слоя действует жесткое правило: «последний успех не должен быть старше 26 часов».
Резервная копия без проверки восстановления — лишь иллюзия надежности
month: 2026-10    status: PASS    phase: COMPLETE
databases_connected: 12    user_tables_and_partitions: 268
extensions: 13    invalid_indexes: 0    repositories: 6
container_cleanup_verified: true    work_cleaned: true
Это ключевой аспект всей архитектуры. Наличие трех копий — великолепно, но они не имеют никакой ценности до тех пор, пока из них хотя бы раз не были успешно извлечены данные. Именно поэтому процедура восстановления переведена на регулярное расписание.
Еженедельно запускается
restic check --read-data— полная верификация считывания каждого байта во всем репозитории, а не выборочная проверка. При текущих объемах процесс занимает около минуты.Первого числа каждого месяца запускается автоматизированная учебная тревога:
-
Из актуального restic-снапшота (возрастом до 36 часов) извлекается свежий дамп
pg_dumpall, после чего выполняетсяrestore --verifyс проверкой целостности gzip-архива. -
Полученный дамп разворачивается в изолированном временном экземпляре PostgreSQL 17.10. Контейнер полностью отрезаний от сети, не публикует порты и не имеет доступа к хостовой файловой системе; рабочие данные размещаются в tmpfs с жестким лимитом памяти.
Скрипт проверяет метрики: количество баз, схем, таблиц, расширений и отсутствие поврежденных индексов. Первый реальный прогон зафиксировал: 12 баз, 268 таблиц и секций, 13 расширений, 0 битых индексов.
Статусы фиксируются в двух независимых переменных: последняя попытка и последний успех. Неудачный тест не затирает предыдущий успешный результат и не пытается запуститься заново — разбором проблемы занимается администратор.
За процессом следят три триггера: сбой попытки или неопределенный статус, затягивание проверки дольше 90 минут, отсутствие успешного прогона на протяжении более чем 35 дней.
Gitea проверяется автономно. Официальный Docker-образ с жесткой фиксацией по digest, база данных из restic и репозитории из зеркала на NAS развертываются в изолированном контуре без сетевого доступа и с файловой системой в режиме read-only. Критерий успеха: веб-интерфейс отдает код 200, все шесть репозиториев доступны вместе с ветками и историей коммитов. После исправления юнита такая проверка отработала ровно за 80 секунд на следующее утро после бэкапа.
Честно о зонах риска. Эти тесты не гарантируют:
-
целостность LFS-объектов и SSH-ключей хоста Gitea — они сознательно исключены из автоматических проверок;
-
абсолютную консистентность: база данных и зеркала репозиториев фиксируются с временным разрывом в один час;
-
исправность архива docker-томов: его валидация ограничивается проверкой размера силами сторожа, реальное восстановление из него пока не репетировалось.
Грабли №3: о чем я вспомнил во время написания этой статьи
Формируя данный текст, я задал себе логичный вопрос: базы проверены, Gitea верифицирована, а где находятся пользовательские файлы? Медиафайлы, вложения из чатов, сгенерированные документы хранятся в объектном хранилище MinIO.
Ответ оказался неутешительным. MinIO попадал исключительно в ночной архив docker-томов — простую потоковую копию живого тома (один слой из трех с глубиной хранения 30 дней). В репозиториях restic этих данных не было, а процедура восстановления из архива томов никогда не отрабатывалась на практике. Выходило парадоксальное положение: лучше всего были защищены компоненты, которые легко воссоздать с нуля, а критичные пользовательские данные висели на волоске.
Ситуацию исправили в тот же день:
-
Каждую ночь перед запуском restic том MinIO копируется во вспомогательную рабочую директорию силами отдельного контейнера (в режиме read-only, без сети). Параллельно генерируется манифест со списком контрольных сумм sha256 каждого файла. Эта копия отправляется в restic и автоматически дублируется по всем трем направлениям.
-
Ежемесячно запускается профильная учебная тревога: извлечение из restic с флагом
--verify, побайтовая сверка с манифестом, развертывание изолированного временного MinIO в том же продакшн-подобном окружении (без сети, под непривилегированным пользователем со случайными учетными данными). Боевые секреты для этого не требуются. Затем скрипт вычитывает каждый объект бакета и сверяет общее количество. -
Сторож теперь генерирует тревогу, если ночная копия старее 26 часов или месячный тест не проводился более 35 дней.
Первичный тестовый прогон: 265 объектов из 265, объем около 300 МБ, время выполнения — 8 секунд. Дополнительно проверил негативный сценарий: намеренное повреждение одного байта в извлеченном файле привело к немедленному падею проверки, как и задумывалось. Тест, который никогда не завершался ошибкой, не доверяет ровным счетом ничему.
Раз уж я добрался до архива томов, стоило изучить его содержимое. Из 73 существующих томов 53 оказались сиротами — анонимными директориями без единого привязанного контейнера, оставшимися от августовских экспериментов с миграциями баз данных. Судя по всему, они содержали копии продакшн-баз и исправно архивировались каждую ночь. По соседству пылились
node_modulesот локальных проектов, кэши CI-раннеров и исторические метрики Prometheus, которые при аварийном восстановлении работающей системы вообще не нужны. Анонимные тома были полностью удалены, а лишние папки исключены из бэкапов. Список сохраняемых томов теперь формируется по принципу черного списка, гарантируя, что новые осмысленные сущности попадут в архив автоматически. Общий объем архива уменьшился с 12,4 до 3,2 ГБ, причем внутри больше нет дубликатов мусорных данных.Больше, чем NAS: третья нода кластера
Еще на этапе приобретения оборудования я решил воспринимать эту машину не просто как хранилище с дисками, а как полноценную третью ноду платформы с выделенной ролью. Для этого узла установлены три жестких правила: полное отсутствие доступа наружу; строгие лимиты потребления памяти для каждого сервиса; на ноде не запускается ничего критичного для работы продакшна. Выход хранилища из строя не уронит платформу — просто в течение одной ночи не появятся свежие копии, о чем незамедлительно сообщит мониторинг.
Что функционирует на узле помимо дисковых массивов:
-
Полигон для восстановления. Упомянутые учебные сценарии с базами данных и Gitea разворачиваются именно здесь, внутри изолированных контейнеров. Проверять целостность бэкапов на том же хосте, который подвергается резервному копированию — порочная практика: в момент аварии рабочий сервер может быть полностью недоступен.
-
Система CI. Раннер Gitea Actions: все сборки и тесты выполняются в изолированных контейнерных окружениях с лимитом в 8 ГБ ОЗУ и 6 ядер, а временный кэш пишется на быстрый пул
scratch. Запуск задач «на хосте» категорически запрещен, поскольку рядом находятся архивы с бэкапами. Ранее сборочные задачи делили ресурсы с основным сервером и GPU-нодой, причем раннер на продакшне еще и подключался к его внутренней сети. Теперь эта нагрузка полностью перенесена. -
Автономный мониторинг, не зависящий от состояния основного сервера (подробнее ниже).
Именно под эти задачи потребовался процессор i7: 16 вычислительных потоков отлично справляются со сборочными задачами и процедурами восстановления, а встроенная графика 11-го поколения аппаратно декодирует видеопотоки AV1.
В ближайших планах — перенести сюда централизованный мониторинг платформы и агрегацию логов со всех нод. Логика прежняя: сервисы оповещения о падении основного сервера не должны размещаться на самом падающем сервере.
Мониторинг, переживущий падение продакшна
У NAS развернут собственный экземпляр Prometheus: годовая глубина метрик хранится на
tank, настроено 27 правил алертинга (здоровье пулов, заполнение дисков свыше 85%, статусы SMART, проверка scrub, актуальность каждого слоя бэкапов, результаты учебных восстановлений, а также обороты вентиляторов и температурные показатели процессора и дисков). Уведомления уходят в Telegram через выделенного бота, не завязанного на продакшн. Журналы самого NAS аккумулирует локальный Loki; интеграция логов с остальных нод находится в очереди.Энергоснабжение: NAS вместе с GPU-нодой подключен ко второму источнику бесперебойного питания (ИБП). Устройство связано по USB с GPU-нодой, которая транслирует статус батареи по протоколу NUT, обеспечивая штатное выключение хранилища при критическом разряде аккумулятора. О том, почему ИБП подключен именно так, подробно рассказано в граблях №6. Следующий шаг — перенос основного контура мониторинга на NAS, чтобы система оповещений оставалась работоспособной при полном отключении ключевых серверов платформы.
Бонус: мультимедиа и семейный архив
Наличие 10 ТБ дискового пространства и процессора с поддержкой Quick Sync позволило развернуть на NAS медиасервер Jellyfin с аппаратным транскодированием. Тесты показали отличные результаты: 4K HDR10 в HEVC конвертируется на лету в 1440p с аппаратным tone-mapping, обеспечивая плавное воспроизведение в Safari на Mac при битрейте 8 Мбит/с с корректной цветопередачей.
Кроме того, на зеркальном пуле
tankпоселился Immich для организации семейного фотоальбома. Система функционирует исключительно в локальной сети, задействуя процессор для распознавания лиц. Это действительно самые ценные данные в доме, поэтому они защищены зеркалированием, а не отправлены на емкий одиночный диск.Грабли №4: инициатива браузера
В процессе подготовки этой статьи внезапно перестали открываться Jellyfin, торрент-клиент и фотогалерея. При этом сам NAS функционировал безупречно: контейнеры работали, а с соседнего сервера страницы отдавались без проблем. Разгадка крылась в логах файрвола — за три часа было зафиксировано 120 отклоненных попыток обращения к порту 443 с моего компьютера. Современные браузеры все настойчивее принудительно переводят запросы на HTTPS, а NAS по протоколу HTTPS изначально не отвечал: обратный прокси-сервер принимал трафик только на 80-м порту, тогда как файрвол молча отбрасывал всё остальное. Браузер упорно ждал ответа по защищенному протоколу и обрывал соединение, вместо того чтобы откатиться на обычный HTTP.
Обычные утилиты вроде Certbot для имен вида
jellyfin.c.lanне подходят, поскольку Let’s Encrypt генерирует сертификаты исключительно для валидных доменных имен. Проблема решилась переносом домашних сервисов на поддомены моего внешнего домена с выпуском wildcard-сертификата посредством валидации через DNS. Наружу при этом по-прежнему ничего не открывается: Let’s Encrypt проверяет TXT-записи на стороне регистратора домена, не обращаясь к самому NAS. Локальные имена резолвятся исключительно домашним роутером и не видны из интернета. Сертификат выпускается на основном сервере, где уже был настроен Certbot, после чего автоматически доставляется на NAS при каждом плановом обновлении. Теперь в адресной строке красуется заветный замочек, и ни на одно клиентское устройство не потребовалось устанавливать корневые сертификаты.Без казусов не обошлось и здесь. Первая попытка выдачи сертификата завершилась неудачей: Let’s Encrypt не обнаружил TXT-запись, хотя в панели регистратора она уже отображалась. DNS-серверы регистратора обновляют информацию медленнее, чем за пару минут ожидания, а кэш резолверов может хранить старые ответы до трех часов. Увеличение интервала ожидания до 15 минут решило проблему. Заодно выяснилось, что для другого wildcard-сертификата (используемого на тестовом стенде) в настройках был прописан интервал всего в одну минуту. Работало ли это стабильно раньше или просто везло — выяснять не стал, но рисковать в декабре не хотелось, поэтому тайм-аут заблаговременно подняли до 15 минут.
Грабли №5: сторож, который хранил молчание
Шум от NAS заставил заняться оптимизацией кривых вращения вентиляторов. Пара тыловых вертушек без поддержки PWM и вентилятор дисковой корзины висят на едином разъеме через разветвитель, а обороты регулируются материнской платой на основе температуры процессора. Возникает нюанс: ночью запускаются тяжелые бэкапы, нагружая диски, но сам процессор остается холодным — в результате вентиляторы корзины вращаются на минимальных оборотах. Во избежание перегрева я добавил раннее оповещение: срабатывание триггера, если температура любого жесткого диска превышает 45 °C дольше получаса. В обычном простое накопители удерживают 24–36 °C, а пиковое значение за неделю составило 40 °C.

Внешняя корзина с дисками. Её вентилятор висит на одном разъёме с задними и крутится по температуре процессора, а не дисков. Решив проверить доставку алертов, я с удивлением обнаружил, что уведомления не поступают вообще. Более двух суток в Telegram не прилетало ни единого сообщения. Механизм пересылки оповещений из Prometheus устроен строго: бот сверяет имена правил по жесткому списку и при появлении незнакомого идентификатора блокирует рассылку целиком, чтобы не пропустить лишний мусор. За пару дней до этого три новых правила, касающихся вентиляторов и температуры CPU, были добавлены ИИ-агентом по моей устной задаче, однако конфигурация пересыльщика обновлена не была. Ни агент, ни я не провели тестовую отправку сообщений после правок. С того момента любой опрос завершался сбоем. Docker исправно подсвечивал статус контейнера как
unhealthy, но туда никто не заглядывал.В тот же вечер обнаружился второй молчун: после плавной перезагрузки с изменением параметров в BIOS на NAS не запустился сервис Prometheus. Политика рестарта была зафиксирована как «если не остановлен вручную», но Docker его так и не поднял. Причины до конца оставаться в тумане не должны — я изменил политику на «всегда» и теперь принудительно проверяю состояние мониторинга после каждого ребута.
Вывод: наличие записи в конфигурации не гарантирует доставку уведомлений. Алерт, который не доходит до адресата, хуже его полного отсутствия, поскольку создает иллюзию безопасности и контроля. Теперь после любых изменений в правилах скрипт-пересыльщик проходит принудительный холостой прогон.
Грабли №6: дешевый USB-контроллер, уронивший сеть
Раз уж ревизия сторожевых механизмов была в разгаре, я заглянул в настройки NUT. Оба источника бесперебойного питания — питающий основной сервер и обслуживающий NAS с GPU-нодой — были подключены по USB к основному мини-ПК на китайской платформе. И оба уже целую неделю выдавали статус
Data stale(данные устарели). В случае отключения электроэнергии ни одна нода не завершила бы работу штатно. Разумеется, алерта на потерю связи с ИБП настроено не было, поэтому проблема оставалась незамеченной.Системный журнал ядра подсказал, что USB-подсистема мини-ПК сбоила давно. Начиная с конца сентября один из портов ежедневно генерировал сотни ошибок, циклически отключая и подключая периферию. Вечером 4 октября ядро заблокировало соседний порт с формулировкой «возможна электромагнитная помеха», после чего USB-контроллер полностью перестал реагировать на устройства. При этом физические кабели сидели в разъемах плотно. Когда я переподключил их в попытке устранить возможный плотный контакт, контроллер окончательно «умер», прихватив с собой соседнее устройство — USB-адаптер 2.5G, через который GPU-нода обращалась к основному хранилищу. В результате GPU-нода зависла на операциях с NFS.
Перезагружать продакшн-сервер не потребовалось: контроллер удалось оживить программно путем отвязки от драйвера и повторной инициализации через sysfs (хватило пары команд). Оба ИБП и сетевой адаптер вернулись в систему. Однако на том же порту ситуация моментально повторилась — 57 переподключений за одну минуту. Злосчастный ИБП я перенес на GPU-ноду, которую он и так питает (и где он физически находился с первой минуты сборки). Судя по всему, дело было не в самом ИБП, а в аппаратных проблемах мини-ПК — дефектном порту или просадках питания на материнской плате.
Урок: на бюджетном железе категорически не рекомендуется вешать на один USB-контроллер и источники питания, и сетевые адаптеры. А надпись «NUT настроен» вовсе не означает, что NUT функционирует.
Чего эта конфигурация ВСЕ ЕЩЕ НЕ решает
-
Все три копии хранятся в пределах одной квартиры. Пожар, кража или масштабный потоп уничтожат всё одновременно. Организация облачного удаленного сайта (offsite) — осознанно отложенная задача, остающаяся главным долгом всей архитектуры.
-
mediaбез резервирования. Осознанный риск: в случае выхода из строя диска X300 медиатеку придется собирать заново. -
Сетевая инфраструктура. Новый коммутатор прибыл за день до релиза статьи: сеть хранения на 2.5 Гбит с 10-гигабитным аплинком уже развернута, бэкапы побежали втрое быстрее. Без шероховатостей не обошлось и здесь (NFS ссылался на новый IP, но продолжал гнать трафик по старому адресу), но это тема для отдельного рассказа.
-
Отсутствие контроля над самими сторожами. Если «замолчит» пересыльщик алертов, сам Prometheus или демон NUT, я узнаю об этом случайно — ровно так же, как в случаях с граблями №5 и №6. Внешняя проверка доступности «я жив» и триггеры на пропажу ИБП стоят в очереди задач.
-
Семейный бюджет. Мое хобби находится под пристальным надзором второй половины, которая с интересом наблюдает за утечкой средств из кошелька. Эту «утечку» видно без всякого мониторинга, и от нее не спасают ни ZFS-зеркала, ни многоуровневые снапшоты.
Вместо вывода
Месяц назад я опоздал с публикацией на сутки из-за падения NFS. За истекший месяц QNAP окончательно ушел на покой, а я на собственном опыте прочувствовал разницу между концепцией «у меня есть три копии» и «у меня проверено восстановление». Команда
restic checkлишь констатирует целостность архива. Исключительно успешное восстановление доказывает, что в архиве лежит именно то, что нужно.Три вопроса к читателям в комментариях:
-
Внешний бэкап. Какое ПО и алгоритмы шифрования вы используете для отправки копий на удаленные площадки, если находитесь в РФ и не хотите зависеть от единого облачного провайдера?
-
Зеркала против RAIDZ. При использовании разнокалиберного парка дисков поступили бы иначе?
-
Учебные тревоги. Как часто вы проводите тестовые восстановления из резервных копий в реальных условиях и что именно проверяете в процессе?
Проект по-прежнему называется VoiceMind, ссылки на ресурсы доступны в профиле.
-
Похожие статьи
 Подорожание смартфонов заставит 70% покупателей отказаться от планов на покупку
 Крупнейший в мире наземный пункт пропуска перешел на китайские процессоры Hygon
 Домашний сервер на ноутбуке с диском на 10 ТБ: личное облако, сайты и сисопки вместо арендованных сервисов
 Starlink опередил европейских конкурентов по скорости и качеству интернета среди наземных операторов
 Скоро состоится релиз Redmi K100 с поддержкой 100-ваттной зарядки
 Какую MoE-модель выбрать для локального кодинга на GTX 1080 Ti: перплексия или скорость
 FAA обязало Boeing срочно заменить детали на 174 лайнерах 787 из-за угрозы потери высоты
 Тест DPReview: ручная выдержка заметно ухудшает ночные снимки на iPhone 18 Pro