Как кремний взломал кремний: история создания первого в мире подтвержденного PCIe Gen2 x16 для CMP90HX
Кандуционер
Перед вами третья масштабная глава издевательств над видеокартами NVIDIA CMP 90HX.
В стартовом материале я собрал домашний кластер на базе пары процессоров Xeon и россыпи бэушных шахтерских ускорителей. Изначальная задумка казалась прагматичной: получить внушительный массив видеопамяти и приличную сырую производительность по скромной цене, чтобы крутить крупные локальные языковые модели прямо дома — избегая аренды облачных GPU, поминутной оплаты токенов и привязки к проприетарным сервисам.
Вскоре выяснилось, что маркетологи NVIDIA вкладывают в понятие «карта для майнинга» вполне конкретный смысл:
«Вот тебе почти полноценный GA102. Только задействовать его целиком мы тебе категорически запрещаем».
Во второй части я углублялся в дебри драйверов, препарировал механизм V67 и через служебные интерфейсы добрался до залоченных вычислительных блоков CMP 90HX.
Инъекция V67 позволила активировать полноценные матричные селекторы и вернуть адаптерам львиную долю производительности, изначально заложенную инженерами в кремний.
На этом этапе любой здравомыслящий системный администратор выразил бы железкам благодарность и просто начал ими пользоваться.
Но вовремя останавливаться — это явно не про наш характер, верно? 🙂
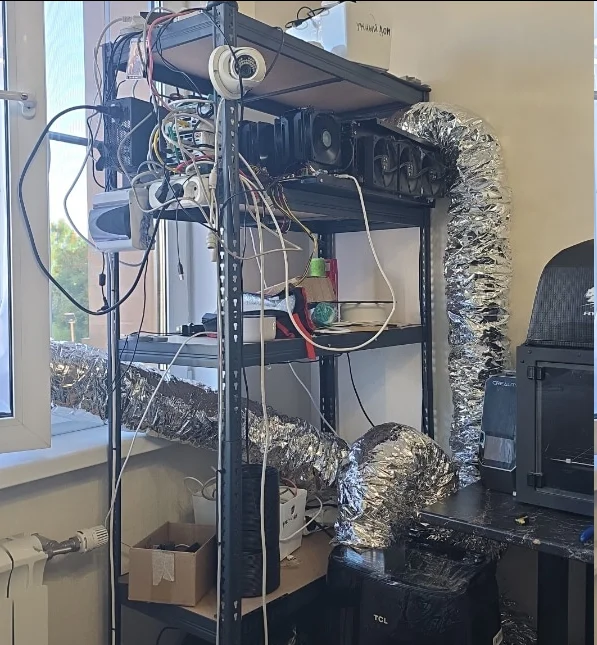
Новым резидентом сервера стал кондиционер
После программного снятия оков ускорители принялись за дело с куда большим энтузиазмом.
У любой полезной вычислительной нагрузки есть неизбежный побочный эффект — колоссальное тепловыделение.
До модернизации системы охлаждения показатели выглядели следующим образом:
Простой: около 60 °C
Нагрузка: вплоть до 90 °C
Для графического чипа это еще в пределах нормы. Однако для длительных стресс-тестов, многочасовых инференсов и потенциального разгона мне требовался совершенно иной запас прочности.
Решением стало подключение к стойке мобильного кондиционера. Отныне сервер затягивал исключительно охлажденные воздушные массы, а отработанное горячее уходило прямо в форточку.
Новые метрики:
Простой: около 9 °C
Полная нагрузка: около 60 °C
Девять градусов на графическом чипе в режиме бездействия!!!
В какой-то момент видеокарта оказалась холоднее продуктов в моем холодильнике, так что вопрос температурного режима можно было считать закрытым.
Этот термический задел еще сослужит добрую службу, ведь после устранения искусственных лимитов логичным шагом становится полноценный разгон.
Но предварительно стоило оценить, насколько эффективно задействован наш парк из нескольких GPU.
Как модель распределяется по массиву карт?
Следующей вехой после интеграции V67 стал тюнинг стратегии разделения весов модели между графическими ускорителями.
Чтобы в дальнейшем было понятна критическая важность интерфейса PCIe, вкратце напомню про два фундаментальных этапа инференса LLM.
При отправке запроса модель должна сначала проанализировать весь поданный контекст — это фаза Prefill (предзагрузка).
Автономный ИИ-агент способен единовременно заглотить системный промпт, исходный код драйверов, дампы ядра, итоги прошлых итераций, справочную документацию, историю опытов и свежий вопрос. Всё это массивом прокачивается через сеть. Для короткой беседы этот этап незаметен. Но когда агент непрерывно перемалывает гигантские логи и исходники, prefill съедает львиную долю времени.
Разница между условными 250 токенами в секунду и 2000 токенов/с ощущается буквально в каждом запросе.
Следом за обработкой входа стартует синтез ответа — фаза Decode (генерация).
Когда заявляют, что нейросеть выдает 30 или 70 токенов за секунду, обычно имеют в виду именно этот показатель.
Моему серверу критически важны оба параметра. Требуется мгновенная генерация и столь же реактивный прием входящих данных, поскольку локальные ассистенты постоянно изучают массивы технической документации.
Бэкенд llama.cpp позволяет раскидывать веса моделей по картам разными методами.
Самый интуитивный — layer split (послойное разделение).
Здесь слои модели последовательно распределены по разным GPU. Первый чип считает свою секцию и пересылает промежуточный тензор соседу.
Альтернативный сценарий — tensor split (тензорное распараллеливание).
В этом случае каждая крупная математическая операция дробится и выполняется всеми GPU параллельно. Вычислительные ядра утилизируются эффективнее, но интенсивность межчипового обмена данными взрывообразно возрастает.
НО! У CMP 90HX физически отсутствует шина NVLink. Весь этот трафик идет через PCIe. И именно здесь старые майнинговые корни дали о себе знать…
Важное примечание касательно бенчмарков
Описанные эксперименты растянулись во времени, а программный стек по ходу дела эволюционировал.
В отдельных бенчмарках применялись схожие, но всё же разнящиеся версии моделей.
По габаритам, структуре и специфике нагрузки они идентичны, так что общая динамика прослеживается отчетливо, особенно при изменениях на десятки процентов.
Тем не менее воспринимать все публикуемые цифры как стерильные лабораторные тесты с единственной изменяющейся переменной было бы опрометчиво.
Идеального совпадения токен-в-токен ждать не стоит — для меня важнее масштаб зафиксированного эффекта.
Первое серьезное испытание tensor split
На тот момент конфигурация выглядела следующим образом:
5 устройств CMP 90HX по 10 ГБ
4 карты функционировали в режиме PCIe x8
1 карта — в режиме PCIe x4
Суммарно llama.cpp распознавал 49 383 МиБ видеопамяти.
Вычислительный анлок через V67 уже был активирован.
Для базового прогона задействовалась модель Qwen3.8–27B–Heretic, все слои полностью уместились в VRAM.
Исходные цифры:
Layer split
Prefill: 1992.67 tok/s
Decode: 23.76 tok/s
Tensor split
Prefill: 268.46 tok/s
Decode: 31.93 tok/s
В генерации (decode) режим tensor split продемонстрировал себя блестяще.
23.76 -> 31.93 tok/s
Чистый прирост составил 8.17 токенов в секунду, или примерно 34.4%.
В фазе предзагрузки (prefill) картина оказалась диаметрально противоположной.
1992.67 -> 268.46 tok/s
Просадка производительности составила около 86.5%.
Tensor split обеспечивал отличную скорость генерации, но пропускная способность PCIe чудовищно тормозила обработку входного контекста.
Именно по завершении этого теста я в очередной расчехлил паяльник.
Видеокартам забыли положить нормальный PCIe
Аппаратно CMP 90HX спроектирована на базе чипа GA102. Текстолит разведен под полноценный интерфейс PCIe x16. Разъем на плате поддерживает x16.
Вот только несколько десятков мелких пассивных элементов на плате решили проигнорировать этот факт…
На линиях передачи данных банально отсутствовали разделительные конденсаторы. В первой статье я уже распаивал емкости по 220 нФ, подняв часть карт до режима x8. Опыт с tensor split показал, что полумероприятия пора заканчивать.
Я допаял недостающие компоненты на оставшихся линиях.

Теперь каждый ускоритель обзавелся честными линиями PCIe x16.
С точки зрения полезной пропускной способности для PCIe Gen1 мы получаем следующие значения:
Gen1 x4 - 1 GB/s
Gen1 x8 - 2 GB/s
Gen1 x16 - 4 GB/s
Одиночная линия PCIe Gen1 работает на скорости 2.5 GT/s. С учетом издержек кодирования 8b/10b чистая пропускная способность составляет порядка 250 МБ/с на линию в каждом направлении.
На этом физические доработки железа были закончены.
Что дало модели полноценное соединение x16?
По завершении аппаратных модификаций я повторил контрольные замеры.
В сценарии layer split показатели практически не сдвинулись с места.
Было:
Prefill: 1992.67 tok/s
Decode: 23.76 tok/s
Стало:
Prefill: 2098.89 tok/s
Decode: 23.95 tok/s
Динамика:
Prefill: примерно +5.3%
Decode: примерно +0.8%
Вполне закономерный итог — послойное разделение минимально нагружает шину межчиповым обменом. А вот режим tensor split отреагировал совершенно иначе.
Было:
Prefill: 268.46 tok/s
Decode: 31.93 tok/s
После расширения шины:
Prefill: 489.16 tok/s
Decode: 37.34 tok/s
Динамика:
Prefill: +220.70 tok/s, примерно +82.2%
Decode: +5.41 tok/s, примерно +16.9%
Здесь вновь стоит сделать скидку на небольшие вариации в версиях моделей. Тем не менее масштаб ускорения говорит сам за себя — общая картина очевидна.
Шина PCIe выступала главным бутылочным горлышком для tensor split. Стоило расширить пропускную способность, как ресурсоемкий режим продемонстрировал впечатляющий прирост.
Логичным шагом после этого стал вопрос перехода на протокол Gen2 — все 16 линий к тому моменту уже были физически распаяны.
Хотелось заставить их функционировать быстрее…
2.5 GT/s на архитектуре GA102
После всех манипуляций с паяльником диагностика неизменно рапортовала:
LnkSta:
Speed 2.5GT/s
Width x16
PCIe Gen1.
В пересчете на полезный трафик это дает:
Gen1 x16 - 4 GB/s
Gen2 x16 - 8 GB/s
Ширина канала максимальна. Переход на Gen2 сулит двукратное увеличение пропускной способности. Опираясь на результаты тестов tensor split, эта затея имела сугубо практический смысл.
Стадии безуспешных попыток:
Я перепробовал готовые скрипты.
Препарировал утилиту rejoin15.
Затем переключился на rejoin16.
Манипулировал регистрами PCIe/XVE.
Запускал принудительный ретрейн линии.
В некоторых отчетах параметры менялись.
Но линк упорно оставался на отметке 2.5 GT/s.
Пробую снова.
2.5 GT/s.
Спустя еще несколько бессонных часов.
2.5 GT/s.
Видеокарта питала непреодолимую страсть к стандарту PCIe Gen1 из далекого 2010 года…
Попытки разблокировки Gen2 до меня
Справедливости ради стоит отдать должное трудам предшественников.
Я далеко не пионер в поисках скрытого режима Gen2 на картах CMP 90HX.
В частности, энтузиаст jdowning100 в своем проекте cmpunlocker выкладывал скрипт rejoin16 и заявлял об успешной активации PCIe Gen2 x4 на аналогичных ускорителях.
В открытых источниках упоминались заветные 5 GT/s и около 1.7 ГБ/с реального терафлокса пропускной способности в каждую сторону на четырех линиях.
Сама концепция разгона шины и часть необходимых процедур уже существовали в сообществе. Именно на эти изыскания я и опирался.
Тем не менее подтверждений работы полноценного режима Gen2 x16 на CMP 90HX мне обнаружить не удалось.
Следовательно, на момент выхода этой статьи полученный результат можно считать первым в мире публично задокументированным случаем работы PCIe Gen2 x16 на этих видеокартах.
Почему нельзя просто прописать заветный флаг?
Контроллер PCIe внутри графического чипа многоуровневый.
То, что видит центральный процессор — лишь внешняя надстройка. Внутри кремния скрыты собственные регистры XVE, маски привилегий, служебные микроконтроллеры и закрытые зоны безопасности. И здесь неоценимо пригодился опыт, полученный во время написания второй статьи, где V67 выступал ключом к привилегированному контексту GPU.
Тогда через него активировался флаг FEAT_OVR_PLM для обхода вычислительных ограничений. Логика работы с V67 была уже знакома, оставалось отыскать нужную дверь.
Небольшая ремарка: почему я вообще полез писать свое решение, а не воспользовался чужим? Да потому что чужие наработки просто не функционировали. Серьезно, я честно потратил двое суток на попытки победить ошибки компиляции, сбои записи регистров и тонну сопутствующих багов… Ничего из найденного на просторах интернета не сработало. Без вариантов.
И тогда сервер обрел собственного исследователя
На основной рабочей станции в тот момент трудились четыре карты CMP 90HX, обслуживая локальную языковую модель.
Для экспериментов я собрал отдельный стенд, установив туда пятую видеокарту. ИИ-агент на главном сервере получил SSH-доступ к тестовой машине.
С точки зрения маркетологов NVIDIA сложилась комичная коллизия: четыре чипа NVIDIA запускали искусственный интеллект, который пыталсязломать ограничения NVIDIA на пятом чипе NVIDIA. Поставив задачу, я решил не мешать системе.
Я закладывался на несколько дней кропотливой работы (именно поэтому предпочел локальное «железо» облачным моделям — иначе бы разорился на покупке токенов). И самое забавное здесь — мои прогнозы.
Проблема выглядела зубастой: массивный драйвер NVIDIA, закрытые внутренние регистры, ворох старых патчей, бесконечная пересборка модулей ядра, перезагрузки стенда и мониторинг физического состояния шины. Я морально готовился к марафону на пару суток. Агент отыскал рабочий алгоритм примерно за час. Всего один час от постановки задачи до честных 5.0 GT/s.
В этот момент концепция домашнего LLM-сервера оправдала себя на все сто процентов. Я изначально затевал сборку ради локального запуска мощных моделей. В итоге этот самый локальный ИИ превратился в полноценный инженерный инструмент, спроектировавший апгрейд для собственного носителя.
Подобная автономная инфраструктура невероятно удобна: никаких подписок на сторонние облака, никаких счетчиков токенов и внезапных сообщений в разгар эксперимента: «Лимит исчерпан, повторите попытку через несколько часов».
Агент может полчаса изучать исходные коды, затем час компилировать драйверы и ребутать тестовый стенд, сохраняя весь накопленный контекст. Если эксперименты затягиваются на всю ночь, лимитируют меня исключительно производительность железа и розетка.
Для автономных инженерных изысканий это роскошные условия.
Кремний начал препарировать собственный драйвер
Фундаментом послужил официальный NVIDIA Open Kernel Module версии 610.43.03.
В процессе задействовались наработки по открытию вычислений и скрипты rejoin16, после чего агент приступил к тонкой настройке последовательности инициализации, внутренних PCIe-регистров и ретрейна шины.
Выяснилась критически важная деталь: простой записи значения в регистр PCIe недостаточно. Первостепенное значение имеют текущее состояние графического процессора и строгий порядок выполнения операций.
Рабочая цепочка в итоге сформировалась следующим образом: штатный драйвер NVIDIA 610.43.03 штатно инициализирует чип. Затем управление перехватывается модифицированным модулем, через механизмы V67/fwsec открываются необходимые маски привилегий (privilege masks), выполняется аппаратный сброс уровня функции (FLR) вкупе с реинициализацией, после чего запускается повторное обучение линии PCIe.
Никакой волшебной кнопки вроде `ENABLE_GEN2 = 1` инженеры NVIDIA, увы, не оставили. Последовательность пришлось собирать буквально по крупицам.
Еще один любопытный нюанс всплыл на этапе старта системы.
Прямая загрузка модифицированного модуля сразу после «холодного» включения способна уронить драйвер на этапе `RmInitAdapter`.
Поэтому сначала видеокарта проходит стандартную процедуру инициализации синтаксисом NVIDIA. И лишь после этого полностью рабочее устройство передается пропатченному модулю. Фактически это бесшовная передача уже поднятого GPU модифицированному софту.
Из гигантского массива внутренних регистров ключевыми оказались две области.
Первая:
0×823800
Это подсистема FEAT/PLM, с которой я уже имел дело при снятии вычислительных ограничений.
Посредством V67/fwsec маска расширяется до значения:
0xffffffff
Вторая:
0×088fe8
Она относится к блоку XVE и защитным механизмам шины PCIe внутри ускорителя.
Этот регион также принудительно переводится в состояние:
0xffffffff
Дополнительно задействуются селекторы максимальной скорости:
ss0 = 0×88888888
ss1 = 0×00000008
Затем инициируется процедура Function Level Reset (FLR), которую можно охарактеризовать как локальный аппаратный сброс PCIe-контроллера.
Ускоритель сбрасывается, заново проходит инициализационную процедуру, после чего шина осуществляет повторный трекинг соединения.
И в этот момент интерфейс переключился на Gen2
Сразу после снятия защитных масок и ретрейна ОС выдала следующую картину:

Физическая линия успешно перешла на стандарт Gen2.
Практическая проверка пропускной способности
Показания регистров — это прекрасно.
Но мне требовалось эмпирически подтвердить реальный перегон данных.
Был запущен стресс-тест CUDA DMA bandwidth с залоченной областью системной оперативной памяти.
Итоги замера:
RAM -> GPU: 6.33 GB/s
GPU -> RAM: 6.40 GB/s
А теперь кульминация.
Интерфейс PCIe Gen1 x16 физически способен обеспечить примерно 4 ГБ/с полезного трафика. Протолкнуть через него 6.4 ГБ/с технически невозможно. В то время как PCIe Gen2 x16 обеспечивает около 8 ГБ/с полосы пропускания.
Полученные 6.3–6.4 ГБ/с идеально вписываются в теоретические рамки с учетом накладных расходов протокола и особенностей реализации DMA-трансфера.
Промежуточные итоги издевательств и вектор на будущее
Постепенно, шаг за шагом, я устраняю все искусственные преграды.
На текущий момент у нас разблокированы вычисления, распаян полноценный PCIe x16, активирован Gen2 вкупе с избыточным охлаждением.
Чипы памяти GDDR6X стабильно функционируют на частоте около 9500 МГц. Выжимать из них последние соки ценой стабильности пока не тянет — они и без посторонней помощи мастерски конвертируют электроэнергию в тепло.
Куда больший интерес представляют сами вычислительные блоки.
Под затяжной нагрузкой от LLM энергопотребление одной карты держится в районе 200 Вт при лимите в 250 Вт. То есть в потолок power limit мы даже не упираемся. Термический запас после внедрения кондиционера гигантский. Сложилась редкая для бывшего майнинг-железа ситуация: температуры не душат, лимит мощности не жмет, а шина PCIe постепенно перестает быть узким местом. Можно в комфортных условиях исследовать масштабирование производительности от тактовой частоты GPU.
В фазе prefill модель плотно загружает вычислительные модули крупными матричными операциями, поэтому наращивание частоты ядра потенциально способно дать ощутимый прирост.
Генерация (decode) массивных плотных моделей сильнее упирается в пропускную способность видеопамяти, поэтому там эффект может оказаться скромнее.
И это тоже станет ценным практическим результатом.
Я страдал, чтобы вам не пришлось
Добыть рабочую последовательность на изолированном тестовом стенде — достижение приятное.
Но заставлять каждого следующего владельца CMP 90HX проходить этот Голгофин путь — форменное вредительство.
Синтезировав наработки агента, собственный опыт и код из нескольких открытых репозиториев, которые помогли распутать отдельные узлы системы, я написал комплексную утилиту.

В идеальном сценарии конечный пользователь просто скачивает проект, запускает скрипт и получает автоматизированный сетап, включающий compute unlock, активацию Gen2 и верификацию результатов.
Разумеется, под капотом по-прежнему скрывается цирк с пропатченным драйвером, ключом V67, реинициализацией и ретрейном. Просто наблюдать за этим балаганом теперь предстоит преимущественно мне.
Именно в этом кроется истинная сила технического комьюнити: один человек тратит вечер, неделю или даже месяцы… после чего остальные избавлени от необходимости повторять этот тернистый путь с нуля. Им достаются готовый софт, документация и возможность двигаться дальше. На этот раз роль первопроходца-мученика досталась мне.
Так что девиз третьей части и моего нового проекта CMP90HX PWNER звучит предельно лаконично:
«Я страдал, чтобы вам не пришлось».
Исходный код, сама утилита, инструкции по деплою и библиография проектов, легших в основу исследования, доступны здесь:
В README я отдельно задокументировал ссылки на авторов, чьи наработки были задействованы.
Подобные изыскания редко рождаются на пустом месте. Один энтузиаст находит дверь. Второй вытачивает к ней ключ. Третий выясняет точный момент времени для поворота. А четвертый в завершении мастерит удобную кнопку. На сей раз кнопку собрал я.
P. S.
Точные метрики прироста, локализация максимальных ускорений и пределы текущей эффективности режима tensor split станут темами для финальных тестов и отдельного приложения к материалу.
Ну а следом, судя по всему, неизбежно начнется разгон графических чипов.
Потому что навык вовремя останавливаться я, судя по всему, так и не освоил…
Похожие статьи
 За полгода SpaceX совершила более 200 тысяч маневров уклонения для спутников Starlink
 Sonnet выпустила док-станцию Breakaway Box 850 T5 для видеокарт с Thunderbolt 5 и блок питания на 850 Вт
 Ученые призвали искать следы инопланетных технологий на Луне
 Раскрыты детали Realme 16 Pro Harry Potter Edition: в комплекте будет письмо из Хогвартс и билет на поезд
 Память DDR5 показала рекордный рост цен с начала года
 Исторический запуск Starship: 22 сентября корабль впервые выйдет на орбиту и совершит шесть витков вокруг Земли
 Авторы 007 First Light назвали системные требования для трассировки пути: RTX 5080 ради 1440p
 Цены на GeForce RTX 5090 в США взлетели до $7000–9000 в новой реальности