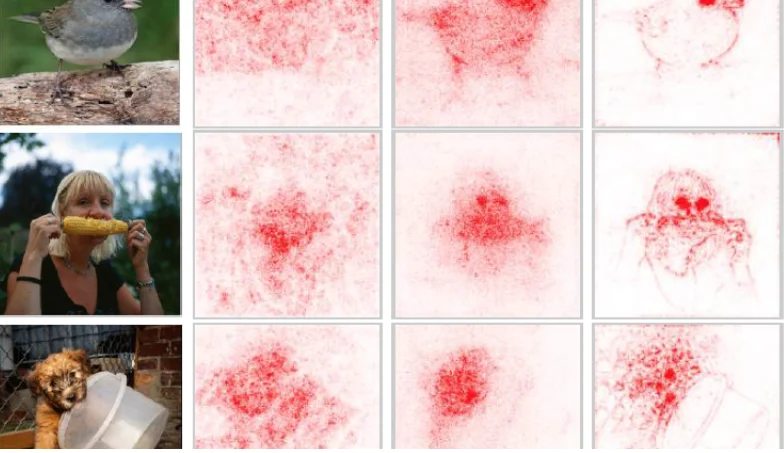
Интерпретируемость машинного обучения: состояние дел
Это эссе содержит обширный обзор весьма узкой темы: интерпретируемости машинного обучения. Пост не претендует на исчерпывающую полноту, я ставил своей целью рассмотреть концептуальные фреймворки, существующие исследования и направления их развития.
Я придерживаюсь категоризации, использованной в работе Lipton et al.’s Mythos of Model Interpretability, которую считаю наилучшей статьей, проясняющей различные дефиниции интерпретируемости. Мы рассмотрим множество способов формализовать значение «интерпретируемости». В широком смысле интерпретируемость отвечает на вопрос «как». Она призвана дать понятие о нашей модели и объяснить, каким образом эта модель принимает те или иные решения. Ниже каждый раздел концептуализируется на основе конкретного вопроса, который можно поставить к нашей модели машинного обучения, опираясь на конкретное определение интерпретируемости. Если все это для вас в новинку, объясню для начала, почему нас вообще должна волновать интерпретируемость.
Похожие статьи
 Как я победил FOMO — страх упущенной выгоды
 Пять самых масштабных кибератак 2026 года: взлом Binance на $6,3 млрд и утечка данных Nike
 Кибернетика сознания и тысяча осколков Будды: как работает ум и как освободиться от страданий
 Торговцы воздухом: как вернуть человечеству его знания
 Почему нейросети усложняют простое и упрощают сложное — и при чём здесь Шерлок Холмс
 Растение не может спрятаться от солнца, поэтому изобрело феруловую кислоту
 Восстание машин откладывается: почему интеллект без собственных целей ещё не разум
 В языковую модель внедрили «мысль»: что выяснилось за год проверок и когда она её замечала