
Grok 4.5 возглавил рейтинг Long-Horizon Terminal-Bench, обойдя Claude 3.5 Sonnet, Opus 4.8, Fable 5 и GPT-5.5 в сложных задачах
Визуализация Grok
Илон Маск объявил, что по результатам июльского тестирования 2026 года языковая модель Grok 4.5 возглавила престижный рейтинг Long-Horizon Terminal-Bench.
Long-Horizon Terminal-Bench (LHTB) представляет собой эталонный тест для оценки возможностей ИИ-агентов. Он фокусируется на проверке навыков многоуровневого планирования, глубокой аналитики и способности выстраивать последовательные алгоритмы действий в условиях интерфейса командной строки.
С показателем эффективности 0,505 модель Grok 4.5 успешно завершила 13 из 46 предложенных сценариев. Столь высокий результат особенно впечатляет на фоне достижений её предшественницы, Grok 4.20, которой не удалось справиться ни с одной задачей из этого сложного испытания.
Благодаря этому успеху Grok 4.5 оставила позади таких конкурентов, как Claude Sonnet 5, Opus 4.8, Fable 5, GPT-5.5 и прочие актуальные нейросетевые модели.
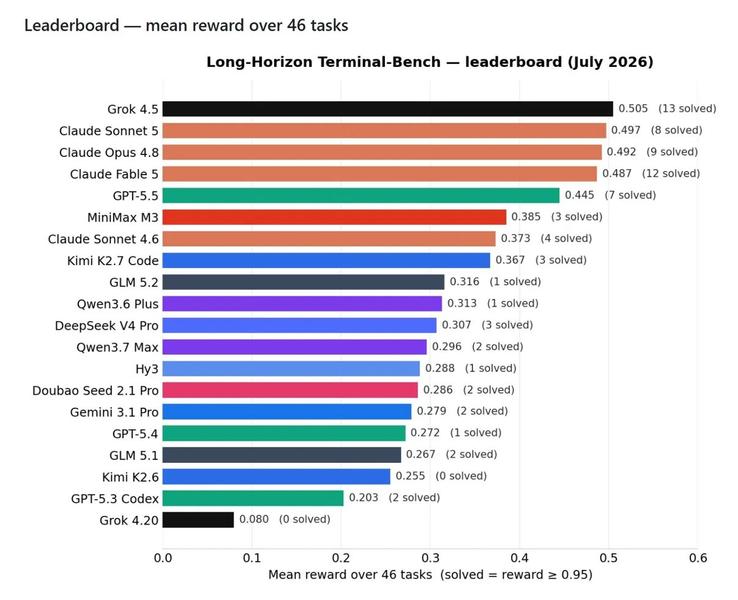
Источник: iXBT
Похожие статьи
 RuStore научился подбирать игры под вкусы пользователей
 МС-21 превзойдет Boeing и Airbus по уровню комфорта и получит уникальный климат-контроль
 На Землю обрушился плазменный поток из гигантской корональной дыры
 Умная отвёртка Arrowmax с камерой и ИИ сама выбирает нужную биту
 Samsung показала вживую новый премиум-флагман W27 — единственный смартфон бренда вне линейки Galaxy
 Huawei выпустит в ноябре новый Mate X8 с экраном более 8 дюймов и батареей на 6000 мА•ч
 К 2030 году в России запустят спутниковый интернет вещей
 Стартовали продажи Redmi K100: Snapdragon 8 Elite, батарея на 10 000 мАч и цена от $450