Долой NVIDIA! Я запустил Qwen на FPGA за 50 долларов и придумал для своего TPU имя «КЕДР». Часть 1
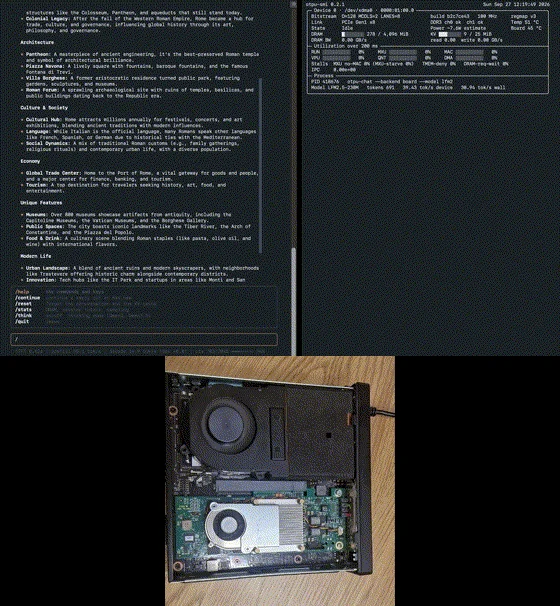
Давно вынашивал идею спроектировать собственный AI-ускоритель. Обнаружив openTPU, я приобрел недорогую FPGA-плату (~$50) с 4 ГБ RAM, сопряг её с обыкновенным мини-ПК и запустил языковую модель — результат превзошел все ожидания, подарив мощнейший прилив энтузиазма.
Никакой продукции NVIDIA. Никаких дискретных видеокарт. Исключительно открытая архитектура, созданная при непосредственном содействии ИИ-агентов.
openTPU — инновационный открытый ИИ-ускоритель за авторством Фелипе Сенса Бонетто (Felipe Sens Bonetto).
Мне до смерти захотелось проверить на практике: удастся ли взять репозиторий с GitHub, прошить им реальную FPGA-микросхему и запустить полноценный инференс LLM?
Согласно бенчмаркам создателя на аналогичном оборудовании:
→ Qwen3-0.6B — 31 токен/с
→ Qwen3.5-2B — 12 токенов/с
→ LFM2.5-230M — 86 токенов/с
→ Qwen3.5-35B — флагманская 35-миллиардная модель на плате с 4 ГБ памяти, выдающая 4 токена/с
И всё это функционирует на аппаратной платформе далеко не первой свежести.
🔧 Что было сделано:
→ Приобретена плата Xilinx Kintex-7 XC7K480T с 4 ГБ RAM через AliExpress (техническая документация: 1 и 2)
→ FPGA интегрирована в систему MINISFORUM посредством шины PCIe
→ Скомпилирован битовый поток (bitstream) в среде Vivado
→ Настроены профильные драйверы и механизм PCIe DMA
→ Развёрнуто необходимое программное окружение
→ Интегрированы веса актуальных нейросетей
→ Успешно осуществлен инференс, задействующий линейку Qwen
И система ожила!
✅ Устройство корректно распознается ОС
✅ PCIe DMA бесперебойно пересылает потоки данных
✅ Подсистема оперативной памяти функционирует безупречно
✅ Набор процессорных инструкций проходит валидацию
✅ Нейросеть выполняет инференс непосредственно на аппаратной базе FPGA
💡 В чем ценность подобных экспериментов по сравнению с банальным запуском софта?
Обычно мы воспринимаем графические чипы как данность: покупаем GPU, ставим CUDA-драйверы и разворачиваем модели.
Но что, если повернуть парадигму вспять?
Не подстраивать железо под нужды алгоритма, а конструировать специализированную аппаратную среду под конкретный паттерн вычислений нейросети.
Именно для этой цели создаются кастомные AI-ускорители, включая тензорные процессоры (TPU), заточенные под матричные операции машинного обучения.
Безусловно, данная плата пока не способна соперничать с NVIDIA H100, а рабочий прототип — это ещё не серийный чип (ASIC).
Тем не менее, теперь любой энтузиаст может не просто теоретизировать о кастомной архитектуре ИИ-железа, а тестировать собственные концепты на реальном кремнии.
🔬 Планы на ближайшее будущее:
→ Переход на более скоростную память и производительную FPGA-платформу
→ Детальная оценка архитектурных решений для собственного чипа инференса
Мы уже привыкли доверять искусственному интеллекту написание кода. Теперь же ИИ сам проектирует микропроцессоры, на которых в дальнейшем будет функционировать. Если раньше разработка собственных AI-ускорителей была прерогативой технологических гигантов вроде Google и NVIDIA, то сегодня работоспособный прототип под силу собрать одному инженеру.
В следующей публикации я детально поделюсь результатами замеров на своем тестовом стенде.
Выражаю искреннюю благодарность Фелипе Сенсу Бонетто за проект openTPU.
🔗 Ссылка на первоисточник: https://github.com/FeSens/openTPU
Похожие статьи
 Смартфоны Honor 700 с батареей на 9000 мАч и камерой 200 Мп доступны для предзаказа до официального анонса
 В «М.Видео» цены на SSD и жесткие диски выросли почти в два раза за две недели октября
 Застой длиною в 7 лет: Samsung Galaxy S27 не получит более мощную зарядку
 На Земле обнаружили марсианский метеорит возрастом свыше 4,1 млрд лет
 Начало магнитной бури ожидается в ночь на 31 октября
 Разработан имплант, распознающий работу мозга по нейронным связям
 Взлом крупнейшей криптобиржи: Binance приостановила вывод средств после потери $6,3 млрд и пообещала компенсировать ущерб
 Энцелад пригоден для жизни: метаногены выжили в симуляции подлёдного океана