Как я за полтора месяца разогнал MoE на GTX 1660 SUPER и обогнал штатный флаг llama.cpp
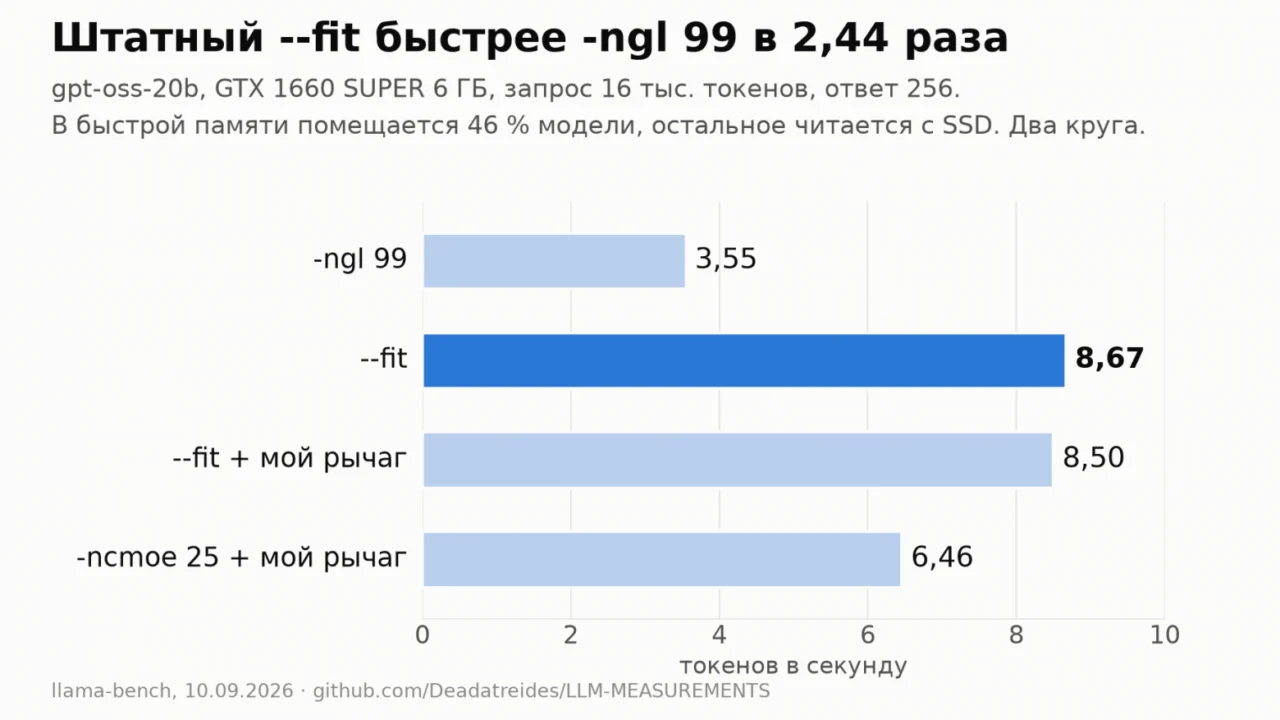
По профессии я тепломеханик и руковожу отделом в проектном бюро, а не пишу код. Начиная с августа, я занимаюсь кастомизацией форка llama.cpp. Моя цель — добиться стабильной и комфортной работы массивных MoE-архитектур на скромном домашнем ПК, укомплектованном видеокартой на 6 ГБ, 24 ГБ ОЗУ и классическим SATA-накопителем. В качестве тестового полигона выступала gpt-oss-20b. Результат пока вызывает легкое разочарование: стандартный параметр ‑fit превзошел все ожидания, обогнав привычный ‑ngl 99 на длинных промтах в 2,44 раза, в то время как мои собственные алгоритмы оптимизации не принесли прироста. Зато по ходу дела мне удалось собрать внушительную коллекцию нюансов, из-за которых бенчмарки выдают искаженную картину, а также подобрать пару полезных конфигураций для обладателей скромных графических адаптеров.
Мотивация
У моих экспериментов есть сверхзадача: сделать искусственный интеллект функциональным без покупки топовой видеокарты и оформления дорогих подписок. Эту идею я реализую через доработку llama.cpp, а параллельно тестирую ансамбли из миниатюрных моделей, но об этом в другой раз. Код генерируют ИИ-агенты, тогда как я формулирую ТЗ и анализирую цифры.
Суть подхода такова. В MoE-моделях при обработке каждого токена задействуется лишь небольшое подмножество экспертов. У модели gpt-oss-120b объем весов превышает 60 ГБ, тогда как объем быстрой памяти в моей системе ограничен примерно 30 ГБ (6 ГБ на GPU и 24 ГБ оперативки). Это значит, что львиная доля данных постоянно подгружается с накопителя. Ключевая техническая задача — минимизировать и синхронизировать эти обращения. Именно под эту логику я и проектировал форк: создавал кастомные схемы распределения, механизмы свопа и заставлял роутер предпочитать тех экспертов, которые уже находятся в оперативной памяти.
К тестированию 120-гигабайтной версии я еще не приступил. Все тесты проводились на младшей gpt-oss-20b, причем для имитации жестких условий часть ОЗУ принудительно блокировалась сторонним софтом. В результате в быстром доступе оставалось лишь 45–48% весов, а остальное вытягивалось с SSD.
Да, семейство gpt-oss сейчас не в тренде, ее даже метко окрестили «бесполезной клячей». Я выбрал ее в августе в качестве полигона, поскольку ее старшая модификация идеально подходит под мои требования. Базовая механика llama.cpp, о которой пойдет речь, от конкретной модели не зависит. От нее зависят лишь абсолютные показатели — на этом я и погорел, о чем расскажу на примере KV-кэша.
Аппаратная база
Конфигурация стенда: Ryzen 5 1600 (6 ядер архитектуры Zen 1), 24 ГБ DDR4, видеокарта GTX 1660 SUPER с 6 ГБ памяти, SATA SSD, операционная система Windows 10. Модель gpt-oss-20b использовалась в оригинальном формате MXFP4 с размером файла 11,3 ГиБ. Производительность замерялась с помощью стандартной утилиты llama-bench, однако чуть позже я объясню, почему относиться к ее результатам нужно с осторожностью. Базовый сценарий тестирования выглядел так: входящий запрос на 16 тысяч токенов и генерация ответа целиком на 256 токенов. Именно так выглядит типичный рабочий процесс при анализе объемных документов или исходного кода.
Главное правило: забудьте про ‑ngl 99
Многие гайды по настройке llama.cpp настоятельно рекомендуют выставлять параметр ‑ngl 99, перекладывая все слои на GPU. Если модель физически не помещается в видеопамять, в среде Windows это худшее из возможных решений:
|
Схема распределения |
т/с |
Отношение к ‑ngl 99 |
|---|---|---|
|
‑ngl 99 |
3,55 |
1,00 |
|
‑fit |
8,67 |
2,44 |
|
‑fit + мой алгоритм |
8,50 |
2,39 |
|
‑ncmoe 25 + мой алгоритм |
6,46 |
1,82 |
Параметры теста: промт на 16 тысяч токенов, генерация 256 токенов, в быстрой памяти находится 46% модели, выполнено два прогона вперемешку.
Причину столь удручающих результатов можно понять, взглянув на запросы к видеокарте, чей лимит составляет ровно 6143 МиБ:
              на карте
-ngl 99      10949 МиБ    перерасход памяти в 1,8 раза
-ncmoe 25     1242 МиБ    видеокарта простаивает на 80%
--fit         4747 МиБ    занято 77% емкости GPU
Флаг ‑ngl 99 требует от видеокарты почти вдвое больше ресурсов, чем у нее есть физически. В Linux-системах подобный запуск, судя по всему, просто завершится ошибкой (у меня нет Linux, поэтому проверить не могу). Драйвер под Windows в таких ситуациях молча выгружает излишки в системную оперативку, из-за чего данные начинают непрерывно циркулировать по шине PCI-E. Скорость при этом хаотично прыгает в диапазоне от 3,3 до 5,2 т/с, а объем дискового чтения за один проход достигает 25 ГиБ, что вдвое превышает показатели раскладки ‑fit.
Алгоритм ‑fit функционирует элегантно: он оставляет в видеопамяти механизм внимания (attention) и максимально возможное количество экспертов, а остальных переносит в RAM. Формально все слои числятся на GPU, но распределение тензоров оптимизировано. По мере заполнения контекста разрастается KV-кэш, и ‑fit динамически вытесняет экспертов в системную память. При пустом контексте в ОЗУ выгружаются эксперты из 16 слоев (из 24), при заполнении до 16 тысяч токенов — из 18 слоев, а при 65 тысячах — уже из 21.
Если модель целиком помещается в ОЗУ, тенденция сохраняется. Короткий тест с ‑ngl 99 показал 4,54 т/с, что сопоставимо с чистым CPU (4,67 т/с), тогда как частичная выгрузка экспертов 14 слоев в системную память обеспечила сразу 10,00 т/с.
Подводный камень заключается в том, что ‑fit активирован по умолчанию в llama-server и llama-cli, но работает лишь до тех пор, пока вы не вмешались вручную. Стоит прописать в аргументах ‑ngl, ‑ot или ‑ncmoe, как встроенный оптимизатор отключается, оставляя в логах лишь одну сухую строку. В исходном коде апстрима эта проверка выглядит так:
if (mparams->n_gpu_layers != default_mparams.n_gpu_layers) {
    throw common_params_fit_exception("n_gpu_layers already set by user to " + std::to_string(mparams->n_gpu_layers) + ", abort");
}
Иными словами, распространенный совет «всегда ставьте ‑ngl 99» для моделей, превышающих объем VRAM, фактически блокирует работу интеллектуального распределителя ресурсов.
Мой кастомный механизм приоритезации маршрутизации MoE давал прирост около 1% к перплексии на собственных текстах модели. В коротких тестах он ускорял работу до полутора раз, но на длинных промтах эффект нивелировался (0,98–1,02): чтение массивного входящего запроса само по себе успевает прогреть кэш практическими всеми нужными экспертами, так что дополнительно подталкивать роутер уже бессмысленно.
Влияние микробатчей на длинные контексты
Второй штатный параметр, реально влияющий на производительность — размер микробатча при чтении промта (‑ub). По умолчанию он равен 512. Замеры для запроса на 16 тысяч токенов при размещении 45% весов в быстрой памяти:
|
‑ub |
т/с |
|---|---|
|
256 |
72 |
|
512 |
98 |
|
1024 |
125–129 |
|
1536 |
143 |
|
2048 |
146 или 77 |
|
4096 |
68 |
Увеличение микробатча ускоряет процесс до определенного предела: значение 1024 обеспечивает прирост в 1,28 раза по сравнению с дефолтным. Резкое падение производительности дальше связано с нехваткой ресурсов: крупный микробатч вымывает страничный кэш, провоцируя лавинообразный трэashing. На значении 4096 дисковый трафик возрастает впятеро, а при 2048 система балансирует на грани фола, демонстрируя разброс от 146 до 77 токенов в секунду от запуска к запуску. При контексте в 65 тысяч токенов этот порог сдвигается еще сильнее: там конфигурация 1536 уже упирается в бутылочное горлышко, генерируя 229 ГиБ дискового чтения против 14 ГиБ у значения 1024.
В итоге для себя я зафиксировал ‑ub 1536 при длине контекста до 16 тысяч и 1024 для 65 тысяч токенов. На вашей конфигурации цифры будут отличаться, но сама кривая производительности нелинейна, поэтому оптимальное значение подбирается экспериментально под конкретные задачи.
Кэш KV: квантование q8_0 оправдано, q4_0 — нет
Здесь показатели напрямую зависят от архитектуры модели, на чем я поначалу и попался. Ошибочно полагая, что квантование KV-кэша в формат q4_0 ухудшает перплексию всего на 1,5% (я перенес это значение с модели OLMoE без адаптации), я применил его к gpt-oss. Реальные тесты на текстах самой gpt-oss дали следующие результаты:
|
Формат KV-кэша |
KL-дивергенция к оригиналу |
Совпадение топ-1 токена |
Перплексия |
|---|---|---|---|
|
q8_0 |
0,002 |
97,65% |
+0,05% |
|
q4_0 |
0,087 |
86,2% |
+10,7% |
С точки зрения качества q8_0 практически бесплатен. В то же время q4_0 увеличивает перплексию почти на 11%, приводя к тому, что каждый седьмой наиболее вероятный токен подменяется ошибочным. Насколько сильно q8_0 ускоряет обработку длинного контекста на 6-гигабайтной карте, я пока детально не замерял. При 65 тысячах токенов KV-кэш отъедает 1,5 ГиБ VRAM, вытесняя полезных экспертов, так что выигрыш должен быть, но это пока лишь гипотеза.
Тупиковые ветви экспериментов
Спекулятивная генерация. Поскольку у gpt-oss отсутствует собственная MTP-голова (Multi-Token Prediction), в качестве черновика использовались n-граммы самого контекста — отдельная вспомогательная модель неминуемо заняла бы дефицитную оперативной память. На искусственно созданном закольцованном промте черновик сработал 7 раз из 128 возможных, причем все 7 предсказаний подтвердились. Итоговый выигрыш составил скромные 5,5%, что находится в пределах погрешности измерений. На естественных текстах счетчик сработанных черновиков вообще показал ноль за 126 вызовов. Разовый всплеск до 1,35 раза при повторных тестах трансформировался в хаотичные значения (4,14 и 5,26 т/с), подтвердив чисто шумовую природу эффекта.
Идея о том, что «многотокенный проход обеспечит 1,76-кратное ускорение», также не подтвердилась. Анализ сетевого и дискового трафика показал истинную причину: один проход модели в условиях дефицита памяти по объему считываемых данных примерно равен разовой загрузке весов, независимо от числа обрабатываемых токенов. Когда размер прохода увеличился в 256 раз, дисковый трафик возрос всего с 6,5 до 11,1 ГиБ. Простое деление объема чтения на количество токенов и порождало иллюзию феноменальной эффективности.
Центральный процессор. Шесть ядер демонстрируют лишь 2,63-кратное ускорение относительно одного потока, при этом подсистема памяти загружена лишь на треть. Узким местом выступает сама реализация ядра MXFP4 на архитектуре Zen 1, где 256-битные AVX2-инструкции выполняются в два такта. Главный вывод для моего ПК: нехватка 55% памяти отнимает всего 4–11% скорости на 16-килобайтном контексте. Узкое место кроется в производительности CPU, а дисковая подсистема вторична, поэтому штатный механизм ‑fit отрабатывает практически на пределе возможных возможностей.
Мои персональные наработки. Ни одна из модификаций — будь то принудительное перенаправление маршрутизатора, кастомный своп или самодельные схемы распределения — не прибавила ни единого процента поверх стандартного флага ‑fit для 20-миллиардной модели.
Как бенчмарки вводили меня в заблуждение
У меня есть железобетонное правило: методология тестирования является частью самого теста. К середине сентября это правило подтверждалось девять раз — ровно столько раз предварительные выводы, сделанные в нерелевантных условиях, кардинально менялись при правильном подходе. Вот наиболее показательные примеры.
Короткие прогоны
Раньше я тестировал систему короткими генерациями по 32–48 токенов на пустом контексте, как практикуют многие исследователи. В условиях нехватки памяти такой подход измеряет исключительно состояние кэша. Генерация 32 токенов с холодного старта шла со скоростью 2,8 т/с из-за промахов по кэшу. Те же 32 токена после предварительного промта в 4 тысячи обрабатывались уже со скоростью 10,2 т/с, поскольку разбор запроса успевал задействовать большинство экспертов и прогреть кэш. Полноценная генерация 256 токенов демонстрировала 6,6 т/с в чистом виде и 8,6 т/с после длинного входящего запроса.

Исходя из коротких тестов, я был уверен, что мой алгоритм в связке с ‑fit дает полутора- или двукратный прирост над ‑ngl 99. Однако при тестировании полных ответов после массивных промтов этот же метод давал коэффициент 1,02.
Специфика генерации токенов в llama-bench
Эту особенность я обнаружил, изучив исходный код. Как для анализа промтов, так и для генерации ответов llama-bench использует псевдослучайную генерацию через std::rand() % n_vocab. В компиляторе MSVC под Windows константа RAND_MAX ограничена значением 32767, из-за чего для словаря gpt-oss размером в 201 088 токенов выборка фактически ограничена первыми 32 768 позициями. Модели скармливается бессвязная мешанина из обрывков токенов.
Для плотных трансформеров это не имеет критического значения, так как вычислительная нагрузка остается неизменной. Но в архитектуре MoE роутер выбирает экспертов на основе семантики текста, поэтому на случайном «шуме» распределение активности кардинально отличается от работы с осмысленным языком. На скорость вычислений это не влияет напрямую, но все метрики, завязанные на поведение экспертов, кэширование и подкачку, необходимо перепроверять на реальных текстах через llama-server. Я пока не успел это сделать до конца. Тем не менее, разница между ‑fit и ‑ngl 99 обусловлена фундаментальной логикой распределения памяти, так что здесь выводы останутся в силе. А вот все цифры касательно кэша и моих алгоритмов стоит воспринимать с учетом этой оговорки.
Вдобавок ко всему, утилита llama-bench по умолчанию стремится запихнуть на видеокарту все слои подряд и не активирует ‑fit — для этого предусмотрен отдельный флаг ‑fitt, который изначально выключен. Фактически «из коробки» бенчмарк замеряет ровно ту конфигурацию, которую сервер в реальной работе никогда бы не выбрал.
Порядок запусков
Был момент, когда я зафиксировал аномальный скачок производительности: без заблокированной памяти скорость составляла 2,24 т/с, а с принудительно зажатыми 6 ГБ ОЗУ подскочила до 7,65 т/с. Объем свободной памяти тут был совершенно ни при чем. Просто во время первого захода файл модели еще не успел закешироваться операционной системой и читался напрямую с SSD, а к моменту второго запуска полностью перешел в дисковый кэш ОС. Теперь я делаю обязательные дублирующие прогоны для каждой точки, отбрасывая первый результат и фиксируя данные по второму.
Интервальный дрейф производительности
Один и тот же неизмененный код на идентичной модели демонстрировал результаты вроде 99,65 ± 0,51 т/с, а спустя час — уже 94,0 ± 3,5 т/с. Шестипроцентный разброс при погрешности единичного замера менее процента объяснялся просто: между тестами выполнялись пересборки проекта, запись десятков гигабайт на диск, происходил банальный нагрев компонентов. Теперь я запускаю сравниваемые конфигурации циклично в рамках одного сеанса (A, B, A, B) и анализирую относительные соотношения. Разницу менее 10%, полученную разрозненными сериями, я больше в расчет не беру.
Оценка перплексии на чужеродных текстах
Был забавный эпизод, когда я публично заявил о баге в реализации gpt-oss внутри llama.cpp, поскольку перплексия на стандартных англоязычных датасетах линейно росла вместе с длиной контекста, достигая 134. Знающие люди подсказали, что gpt-oss изначально распространялась лишь в виде дообученных вариантов под специфический формат Harmony, а базовой версии у нее нет, поэтому произвольный текст для нее противоестественен. Я сгенерировал текст самой моделью в ее родном синтаксисе, и при длине контекста 1024 перплексия сразу упала до здоровых 2,07. Ошибочное утверждение пришлось отозвать. С тех пор качество оценивается исключительно на контенте, созданном самой испытуемой моделью.
Идеальный сетап для видеокарт с 6–8 ГБ VRAM
Полуторамесячный марафон тестов привел меня к простому выводу: главное — не пытаться перехитрить встроенный оптимизатор. С учетом того, что мое железо уникально, а ваша конфигурация может отличаться, рабочей базой я считаю такую команду:
llama-server -m gpt-oss-20b-mxfp4.gguf -c 16384 -ub 1536 -ctk q8_0 -ctv q8_0
Параметры ‑ngl, ‑ot и ‑ncmoe лучше не трогать без предварительных замеров: флаг ‑fit активирован по умолчанию, и на длинных промтах он уверенно обыгрывает любые ручные схемы распределения, что я тестировал. По умолчанию он оставляет в резерве видеокарты 1 ГиБ, но я проводил тесты с лимитом в 256 МиБ (--fit-target 256). Если графический интерфейс ОС почти не нагружает карту, этот запас можно уменьшить. Для контекста в 65 тысяч токенов используйте ‑c 65536 в паре с ‑ub 1024. Включать спекулятивное декодирование через n-граммы для gpt-oss я не вижу смысла.
Для замеров используйте llama-server на собственных текстах, измеряя генерацию ответа целиком при актуальной длине запроса, а тестируемые настройки прогоняйте циклично вперемешку.
Что осталось за кадром
Все тесты проводились на единственной машине под управлением Windows, дистрибутивов Linux у меня нет. Модель на 120b еще ждет своей очереди — ради нее и затевалась вся эта эпопея. Свежие MoE-архитектуры вроде Qwen3.6–35B-A3B я не гонял: хотя базовая механика llama.cpp останется прежней, абсолютные цифры будут другими. Ну и ключевое ограничение: базовые замеры скорости выполнялись через llama-bench на псевдослучайных токенах, так что верификация через llama-server на живых текстах все еще в планах.
Где посмотреть сырые данные
Журнал экспериментов опубликован на GitHub: https://github.com/Deadatreides/LLM‑MEASUREMENTS/tree/main/hardware. Детальные раскладки, подбор микробатчей и анализ коротких прогонов описаны в https://github.com/Deadatreides/LLM‑MEASUREMENTS/blob/main/hardware/REPORT‑BUILD‑AND‑FIRST‑RUN.md (разделы 4.106–4.128, лог объемный, ориентируйтесь по номерам). Проверка качества KV-кэша вынесена в https://github.com/Deadatreides/LLM‑MEASUREMENTS/blob/main/hardware/PHASE0-RESULTS.md.
Обращаюсь к владельцам графических ускорителей с 6–8 ГБ памяти: какие результаты вы получаете при сравнении ‑fit и ‑ngl 99 на современных MoE-моделях? Особенно любопытно услышать показатели пользователей Linux.
Похожие статьи
 Kioxia анонсировала твердотельный накопитель LD4 емкостью до 123 ТБ
 Для серии Galaxy S26 выпущено первое обновление прошивки после релиза One UI 9.0
 Демоверсию российской игры «Царевна» покажут на Comic Con Игромир
 Skyticket сообщил о взломе, затронувшем 14,64 млн записей с данными клиентов
 «Группа Астра» и «Мастер Лаб» договорились адаптировать MedWork к Astra Linux
 В Москве создали отечественный тонометр «Сателлит» с Bluetooth и памятью на 130 измерений
 POWERCOM выпустит ИБП FLY с восемью розетками в четвёртом квартале 2026 года
 Скорость отечественной базовой станции Yadro в сети LTE от «МегаФона» превысила 800 Мбит/с