Бюджетный домашний сервер для LLM: зачем покупать NVIDIA Tesla V100 SXM2 в 2026 году вместо RTX 3090
Еще совсем недавно графические ускорители NVIDIA Tesla V100 прочно ассоциировались исключительно с мощностями дата-центров и суперкомпьютеров. Сегодня же списанные экземпляры V100 SXM2 емкостью 16 ГБ лавинообразно заполняют вторичный рынок, привлекая к себе пристальное внимание энтузиастов локального искусственного интеллекта. Особый интерес при этом вызывают модификации V100 SXM2 на 32 ГБ.
Почему именно NVIDIA Tesla V100
У меня созрела закономерная мысль: вместо приобретения одной баснословно дорогой современной игровой видеокарты почему бы не спроектировать полноценный вычислительный узел на базе двух или четырех подержанных серверных ускорителей. Итогом становится внушительный объем видеопамяти от 64 до 128 ГБ, впечатляющая пропускная способность шины и задействование интерфейса NVLink (попарно). Примечательно, что ценники на сами чипы V100 сейчас несопоставимы со стоимостью актуальных флагманских GPU. К примеру, предложения по V100 SXM2 (16 ГБ) на торговых площадках стартуют примерно со 100–150 долларов за плату, хотя итоговая сумма напрямую зависит от технического состояния и года выпуска.

Сделаем важную ремарку: архитектура Volta дебютировала еще в 2017 году. Данный ускоритель заведомо уступает современным картам линейки RTX в ряде классических сценариев. По уровню игровой производительности он сопоставим скорее с Radeon 6800XT или RTX 4060 Ti, однако полностью лишен поддержки передовых технологий вроде аппаратной трассировки лучей и генерации кадров (DLSS 3/4).

В задачах же локального инференса языковых моделей картина кардинально меняется: здесь на первый план выходят емкость и пропускная способность памяти, а вовсе не свежесть поколения тензорных ядер. Именно поэтому домашняя рабочая станция на основе NVIDIA V100 SXM2 способна на равных конкурировать с в разы более дорогими потребительскими аналогами, оставаясь при этом крайне бюджетным решением. По ряду параметров этот ускоритель держится на планке RTX 3090 Ti. Разумеется, итоговый результат зависит от конкретного сетапа: например, модификации с 32 ГБ VRAM эффективнее справляются с относительно компактными моделями вроде Qwen3.8–27B, целиком помещающимися в видеопамять. А квартет таких V100 суммарно предоставляет 128 ГБ сверхбыстрой памяти HBM2, открывая доступ к запуску тяжелых весов, недоступных для одиночных потребительских карт, хотя общие затраты на подобную сборку уже заметно возрастают.

Что такое V100 SXM2
Модель NVIDIA Tesla V100 базируется на архитектуре Volta и располагает 5120 ядрами CUDA в сочетании с 640 тензорными ядрами. Исполнение SXM2 наделено 32 ГБ памяти HBM2, обеспечивающей пропускную способность на уровне 900 ГБ/с. Паспортная производительность в тензорных операциях достигает 125 TFLOPS при пикового энергопотреблении в 300 Вт. Для межмодульного взаимодействия применяется шина NVLink с пропускной способностью до 300 ГБ/с. Для наглядности: GeForce RTX 3090 предлагает 24 ГБ GDDR6X с пропускной способностью около 936 ГБ/с, в то время как свежая RTX 5070 комплектуется 12 ГБ памяти GDDR7 (672 ГБ/с), а RTX 4070 Ti — 12 ГБ GDDR6X. Получается, что архитектурно V100 выглядит ветераном рынка, но её 32 ГБ HBM2 по-прежнему представляют собой грозный инструмент для работы с локальными нейросетями.

Существовало две ключевые модификации V100: в виде карт расширения PCIe и в формате SXM2. Для домашней лаборатории логичнее рассматривать именно второй вариант. Однако процесс сборки и программной настройки потребует внимания к деталям. Так, в актуальных ветках PyTorch начиная с версии 2.11 стандартные бинарные сборки под CUDA 12.8/12.9 больше не содержат нативной поддержки архитектуры Volta; владельцам V100 рекомендуется откатываться на CUDA 12.6 либо компилировать фреймворк самостоятельно с флагом архитектуры sm_70. Это один из главных нюансов использования подержанного серверного железа: покупка обходится дешево, но софтверная совместимость подбрасывает сюрпризы. Что касается специфического мезонинного разъема SXM2, то у Tesla V100 их предусмотрено сразу два: один служит для интеграции в материнскую плату через переходник, а второй отвечает за связку с соседями по шине NVLink. При подборе адаптера обязательно проверяйте разводку второго разъема SXM2 — далеко не на всех платах-переходниках выведены линии для подключения моста NVLink Bridge. Этот критически важный момент следует учитывать на этапе проектирования будущей ИИ-станции.

Моя конфигурация ИИ-сервера
Модуль SXM2 физически несовместим со стандартными слотами PCIe, поэтому без промежуточной платы-адаптера обойтись не получится. Рынок предлагает множество подобных решений — от одиночных плат до платформ, способных принять на борту сразу четыре ускорителя Tesla V100. Как правило, в материнскую плату такие конструкции монтируются через райзеры и специализированные переходники. Стоит учитывать, что подобные адаптеры могут занижать пропускную способность шины — мне доводилось сталкиваться с вариантами, работающими в режиме не только PCIe x16, но и PCIe x8. Это накладывает определенные ограничения на выбор материнской платы, так что пренебрегать данным фактором нельзя.

Наиболее простым подходом видится применение готовых переходников с воздушной системой охлаждения для установки V100 SXM2 в классический слот PCIe. На иллюстрации как раз запечатлен такой пример, укомплектованный кожухом и вентиляторами от RTX 4090. Между прочим, здесь же виден установленный мост NVLink, объединяющий графические адаптеры в единый контур. Правда, стоимость самих конвертеров нынче способна неприятно удивить, порой приближаясь к цене самой видеокарты.

Охлаждение — главная проблема домашней V100
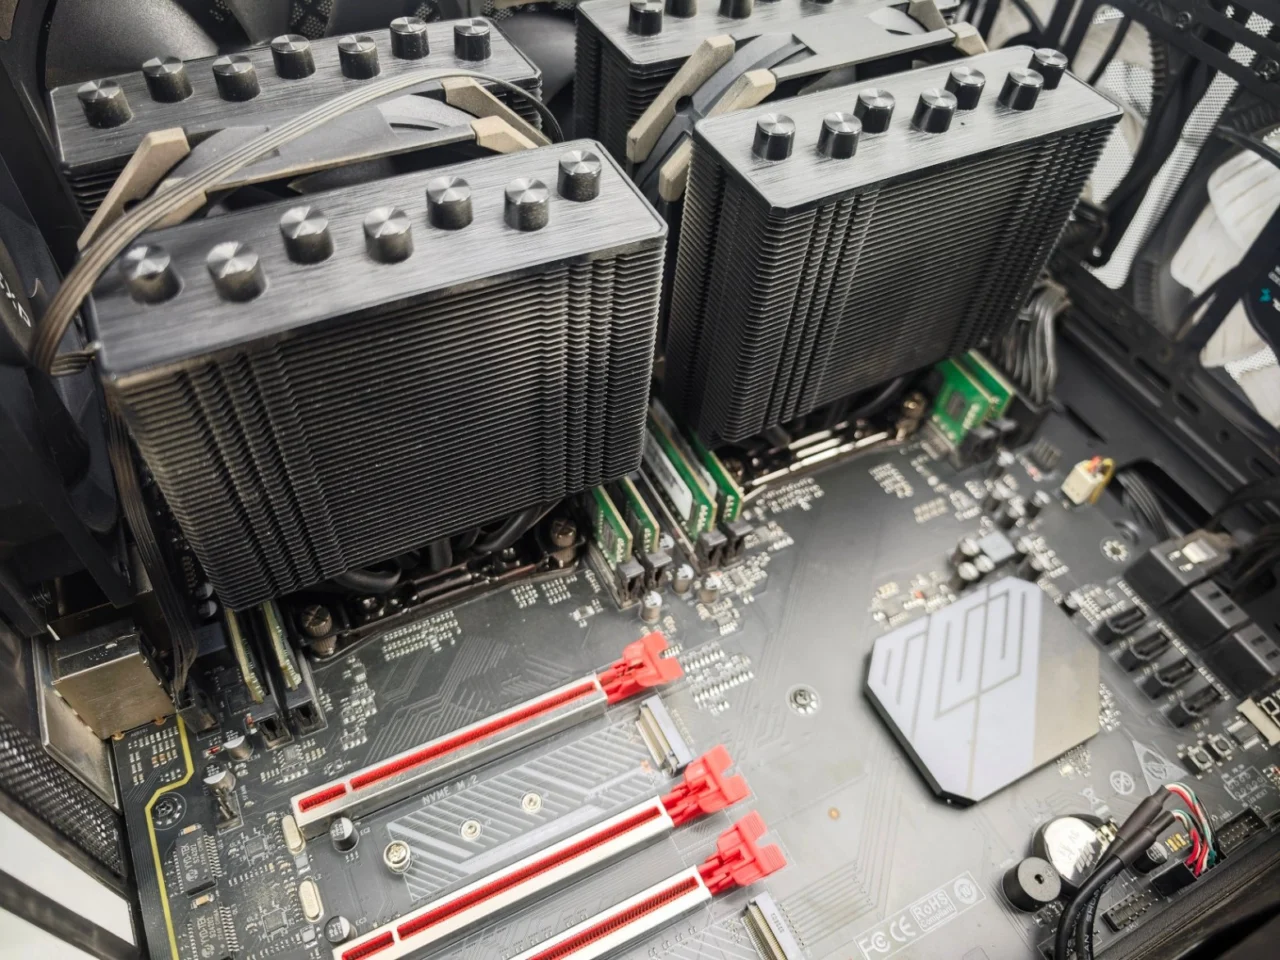
По моему убеждению, воздушное охлаждение подобных чипов — это шаг на грани фола. Серверная V100 лишена привычного игрового радиатора с кожухом: инженеры NVIDIA изначально закладывали эксплуатацию в специализированных стойках с мощным принудительным продувом. При теплопакете в 300 Вт одна такая плата выделяет колоссальное количество тепла. Сборка из двух V100 привносит в систему 600 Вт чистой тепловой энергии только от видеочипов, а квартет устройств удваивает эту цифру до 1200 Вт. Если прибавить сюда пару процессоров Xeon E5-2680 с TDP по 120 Вт каждый, становится очевидно, что наивная попытка приспособить компактный процессорный кулер обречена на провал. Для отвода тепла требуются массивные медные или алюминиевые радиаторы с тепловыми трубками и производительными вентиляторами серверного типа.

И если для временных тестовых стендов воздушный обдув еще допустим, то для стабильного функционирования связки из двух или четырех карт единственно разумным выбором видится интеграция контура СЖО (системы жидкостного охлаждения) — особенно если сервер планируется эксплуатировать в круглосуточном режиме вблизи рабочего места. На фотографиях представлен пример NVIDIA Tesla V100 с монтируемым кастомным водоблоком.

Кристалл V100 имеет абсолютно ровную открытую поверхность, что облегчает подбор специализированных водоблоков под форм-фактор SXM2. Ниже показан тестовый макет с двухсекционной СЖО и стандартным крепежом по аналогии с сокетами LGA 115x. Подобная конфигурация не только кардинально тише ревущих «турбин», но и уверенно справляется с рассеиванием 300 ватт тепла.

Сервер на двух V100 SXM2
Для домашних экспериментов я бы советовал стартовать именно с пары ускорителей. На выходе мы получаем 2 × 16 ГБ = 32 ГБ VRAM, чего достаточно для запуска локальных весов вроде Qwen3.8–27B и Gemma4-26b. Выбрав старшую модификацию V100, мы задействуем 2 × 32 ГБ = 64 ГБ видеопамяти и теоретические 2 × 900 = 1800 ГБ/с совокупной пропускной способности канала благодаря интерфейсу NVLink. Не следует забывать про емкость системной ОЗУ и требования к блоку питания — демонстрационный стенд с иллюстраций потребляет порядка 1 киловатта энергии под нагрузкой.

Сколько стоит такая система
Теперь перейдем к самому увлекательному аспекту — финансовой составляющей. Актуальные расценки на вторичке позволяют приобрести модуль V100 SXM2 на 32 ГБ в диапазоне 100–150 долларов. Переходник формата SXM2→PCIe обойдется примерно в $220. Для сравнения, розничный прайс на новую RTX 5070 держится около отметки $550–570, тогда как б/у RTX 4070 Ti стартует от $680. Популярная среди энтузиастов ИИ модель RTX 3090 с 24 ГБ памяти на вторичном рынке сильно подорожала относительно исторических минимумов и нередко оценивается дороже $1000. Безусловно, любые цифры условны и зависят от рыночной конъюнктуры. Давайте посчитаем смету для полноценных сборок, включая шасси, элементы охлаждения, материнскую плату, процессор и оперативную память:
|
Конфигурация |
GPU |
Переходники |
Платформа и охлаждение |
Итого |
|
2× V100 16 ГБ |
~$240 |
~$240 |
~$900 |
~$1400 |
|
2× V100 32 ГБ |
~$460 |
~$240 |
~$900 |
~$1600 |
|
4× V100 32 ГБ |
~$920 |
~$480 |
~$1300 |
~$2700 |
|
4× RTX 5070 |
~$2240 |
— |
~$1250 |
~$3490 |
|
4× RTX 4070 Ti |
~$2730 |
— |
~$1250 |
~$3980 |
|
4× RTX 3090 |
~$6000 |
— |
~$1500 |
~$6700 |
Данные расчеты носят ориентировочный характер, но прекрасно иллюстрируют порядок цен и позволяют сделать взвешенный выбор. Лично я свой выбор сделал в пользу домашнего сервера на базе V100. Замечу, что в таблице не учтены расходы на логистику, таможенное оформление, потенциальный ремонт б/у комплектующих, а также сопутствующие расходники вроде термопасты. Для грубой оценки эффективности разделим условный агрегированный показатель пропускной способности на общую стоимость системы:
|
Конфигурация |
Условный throughput |
Стоимость |
Токенов/с на $1000 |
|
2× V100 |
144 |
$1600 |
90 |
|
4× V100 |
288 |
$2700 |
107 |
|
4× RTX 5070 |
320 |
$3490 |
92 |
|
4× RTX 4070 Ti |
308 |
$3980 |
77 |
|
4× RTX 3090 |
200 |
$6700 |
30 |
Что показали тесты Qwen3.8
Особый практический интерес представляют испытания локальных LLM вроде Qwen3.8–27B и Gemma4-26b. На карте V100 с 32 ГБ на борту в квантовании Q4_K_M удается зафиксировать скорость около 36.6 токена в секунду. Модель требует чуть менее 24 ГБ VRAM и полностью умещается в памяти ускорителя. Современные фреймворки для инференса прекрасно адаптированы под распределение слоев между несколькими GPU, причем шина NVLink минимизирует задержки при пересылке данных в сравнении с классическим PCIe. Таким образом, если вы не планируете запускать гигантские модели, а возможностей Qwen3.8–27B или Gemma4-26b вам вполне достаточно, можно смело ограничиться связкой из двух V100 по 16 ГБ. В моем рабочем процессе задействован стек Qwen3.8 + Ollama + OpenCode, дополненный при необходимости инструментами MCP под конкретные задачи — например, генерацию трехмерной графики через Blender MCP или создание скетчей для Arduino CLI.

Вместо итога
Если оценивать подобную архитектуру с позиции пользователя, который далек от промышленного обучения тяжелых нейросетей, но активно гоняет локальные LLM, ретуширует фото и решает бытовые генеративные задачи, итоговое впечатление оказывается крайне любопытным. Спайка из двух V100 на 32 ГБ избавляет от постоянной головной боли в духе «хватит ли 12 или 16 гигабайт». Нейросеть можно развернуть как на одном чипе, так и распараллелить. В то же время пара V100 по 16 ГБ выступает в роли самого доступного входного билета в мир серьезного домашнего ИИ. Тем не менее существует ряд объективных факторов, способных остановить прагматичного покупателя:
-
Во-первых, это б/у комплектующие образца 2017–2018 годов (если речь идет о доступных версиях; более свежие ревизии стоят почти как новые потребительские видеокарты). Риск приобрести изношенный экземпляр и понести убытки на ремонт вполне реален.
-
Во-вторых, ускорители требуют патченных драйверов NVIDIA. Беспроблемная настройка удается далеко не на каждой конфигурации ОС, и в мире Linux ситуация выглядит схожим образом.
-
В-третьих, энергопотребление: станция с четырьмя V100 запросто перешагивает порог в 1.5 кВт, а двухчиповая конфигурация вплотную подбирается к 1 кВт.
-
Как следствие, колоссальное тепловыделение влечет за собой сложности с организацией эффективного охлаждения, высокий уровень шума и повышенные риски перегрева.
-
Две шестнадцатигигабайтные карты, объединенные через NVLink — это вовсе не то же самое, что один монолитный чип на 32 ГБ (аналогично для связки из двух 32-гигабайтных плат и гипотетической 64-гигабайтной карты). Современное ПО умеет фрагментировать нагрузку: если Qwen3.8–27B не влазит в 16 ГБ VRAM первой карты, Ollama автоматически переносит часть слоев на второй ускоритель, а при необходимости — в системную RAM. Однако скорость генерации при этом неизбежно проседает, что необходимо учитывать.
-
Наконец, хотя играть на таких картах технически возможно, практического смысла в этом нет — их стихией остается исключительно искусственный интеллект (инференс и генерация). В классических вычислительных и игровых сценариях актуальные линейки RTX сохраняют колоссальное преимущество.

Тем не менее, Tesla V100 дает энтузиасту то, чего не получить за скромные деньги иными путями: максимальный объем видеопамяти и колоссальную нейросетевую производительность в рамках строгого бюджета. Это одно из самых интригующих предложений вторичного рынка. Несколько плат Tesla V100 в паре с NVLink позволяют сформировать комплекс, по объемам памяти и многочиповым возможностям вплотную приближающийся к дорогостоящим корпоративным решениям. Для домашней станции это прекрасный шанс запускать модели тяжелее 24–32 ГБ без необходимости инвестировать тысячи долларов в профессиональные ускорители. Именно поэтому квартет стареющих V100 на практике оказывается значительно производительнее для масштабных моделей, несмотря на почтенный возраст архитектуры. Приятным бонусом служит модульность: построив базовую платформу, можно постепенно расширять её возможности. Лично я после обкатки двухкартенной конфигурации планирую добавить третий модуль V100 на 32 ГБ, а при удачном стечении обстоятельств с материнской платой — замахнуться и на полный комплект из четырех устройств. Впереди публикация тестов производительности в связке с OpenCode, Android Studio, Arduino CLI и Blender, тем более что теперь есть с чем сравнивать. Если тема вам близка — дайте знать в комментариях, могу подробно расписать процедуру настройки драйверов и связок вроде Qwen3.8 + Ollama + OpenCode или Gemma4-26b + Ollama + OpenCode. Также с удовольствием выслушаю ваш опыт проектирования домашних ИИ-станций и оптимизации работы с крупными моделями. Статья получилась объемной, так что если заметите опечатку — просто дайте знать, я оперативно всё исправлю.
Похожие статьи
 Vivo выпустила защищенный пауэрбанк на 20 000 мА•ч со встроенным кабелем и зарядкой 33 Вт
 Девять спутников выведены на орбиту твердотопливной ракетой Kinetica-1
 Вместо Live Photos: Honor Magic 9 оснастят ARRI-режимом на 3 секунды и двойной 3D-биометрией
 Новый портативный SSD SanDisk E31: до 2 ТБ, скорость 1000 МБ/с и вес всего 33 грамма
 Anker выпустила повербанк MagGo 2 Pro на 10 000 мАч с магнитной зарядкой и встроенным вентилятором
 Moto готовит радикальный флагман с камерой на 200 Мп, зумом 100х, Snapdragon 8 Elite Gen 6 Pro и GrapheneOS
 Бурение в ад: в США создадут скважину глубиной 4,5 км для добычи дешевой энергии из недр с температурой 400 °C
 Китай построит термоядерный токамак нового поколения с рекордным магнитным полем