Алмазы, CXL и терабитный Ethernet: октябрьские анонсы серверного оборудования
Производители подыскивают альтернативы дорогой HBM, объединяют серверную DRAM в общие пулы с помощью CXL, создают отдельные CPU-стойки для ИИ-агентов и, разумеется, представляют новые GPU. Привет, SE7EN! Я Сергей Ковалёв, менеджер продукта Выделенные серверы в Selectel. Собрали главные аппаратные новинки октября в традиционном дайджесте.
Публикации Selectel
NVIDIA Rubin в исполнении PCIe
На презентации сервера HPE ProLiant DL585a Gen13 выяснилось, что NVIDIA разрабатывает ускорители Rubin™ в формате PCIe для стандартных стоек с воздушным охлаждением. Из-за ограничений по отводу тепла и пропускной способности интерфейса эти версии уступят флагманским решениям. Их выход ожидается в 2027 году.
Microsoft Maia 300
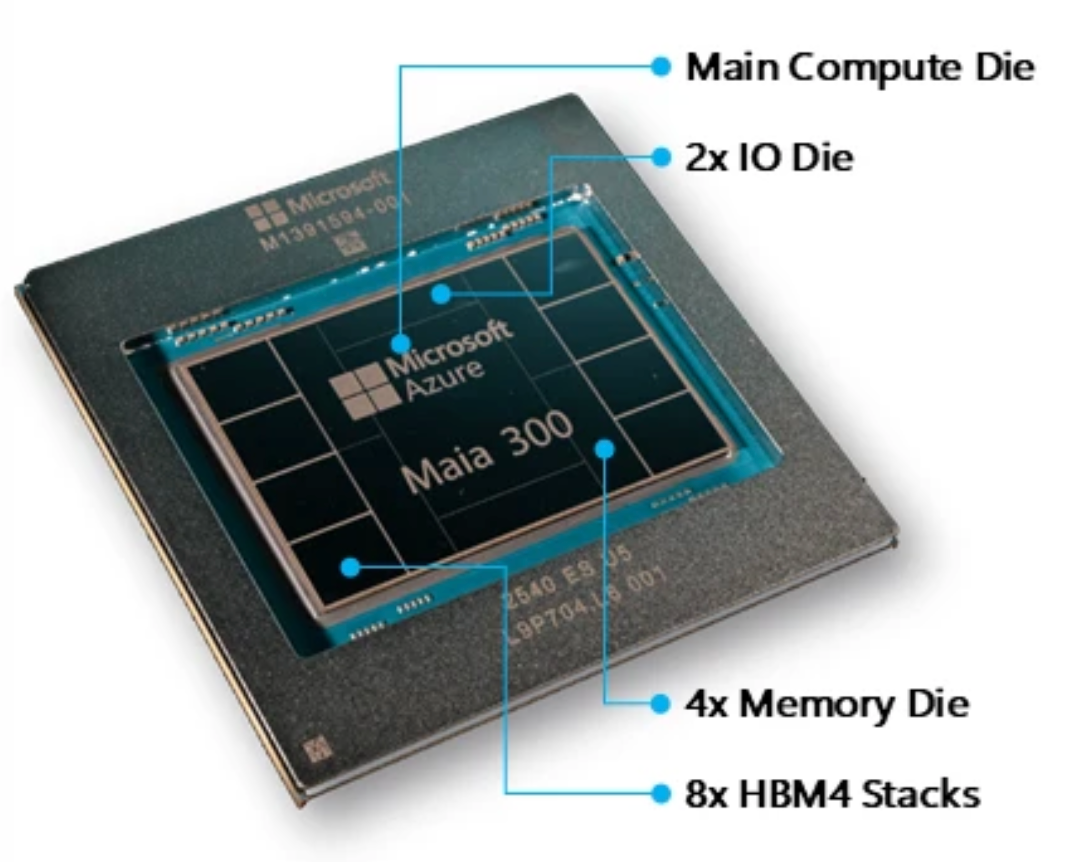
Microsoft показала Azure Maia 300 — ускоритель для инференса LLM и работы ИИ-агентов. Он оснащен 288 ГБ HBM4 с пропускной способностью 18 ТБ/с и потребляет 950 Вт. В одной стойке размещаются 96 ускорителей, а суперпод объединяет до 12 288 устройств. Подробнее — в статье.
Мини-ПК осеннего сезона
Этой осенью ASUS представила два мини-ПК: ProArt GR1X на ARM-платформе NVIDIA RTX™ Spark с объемом общей памяти до 128 ГБ и Ascent QN10 на Snapdragon X2 Elite. AAEON показала промышленный UP Xtreme PTL Edge Air без вентиляторов, оснащенный мембранной системой охлаждения Frore AirJet. А GMKtec EVO-X5 Pro получил 192 ГБ памяти и предназначен для локального запуска моделей с числом параметров до 320 млрд. Обзор всех устройств — в материале.
Другие события
Intel GPU D270 Crescent Island — ускоритель с LPDDR5X
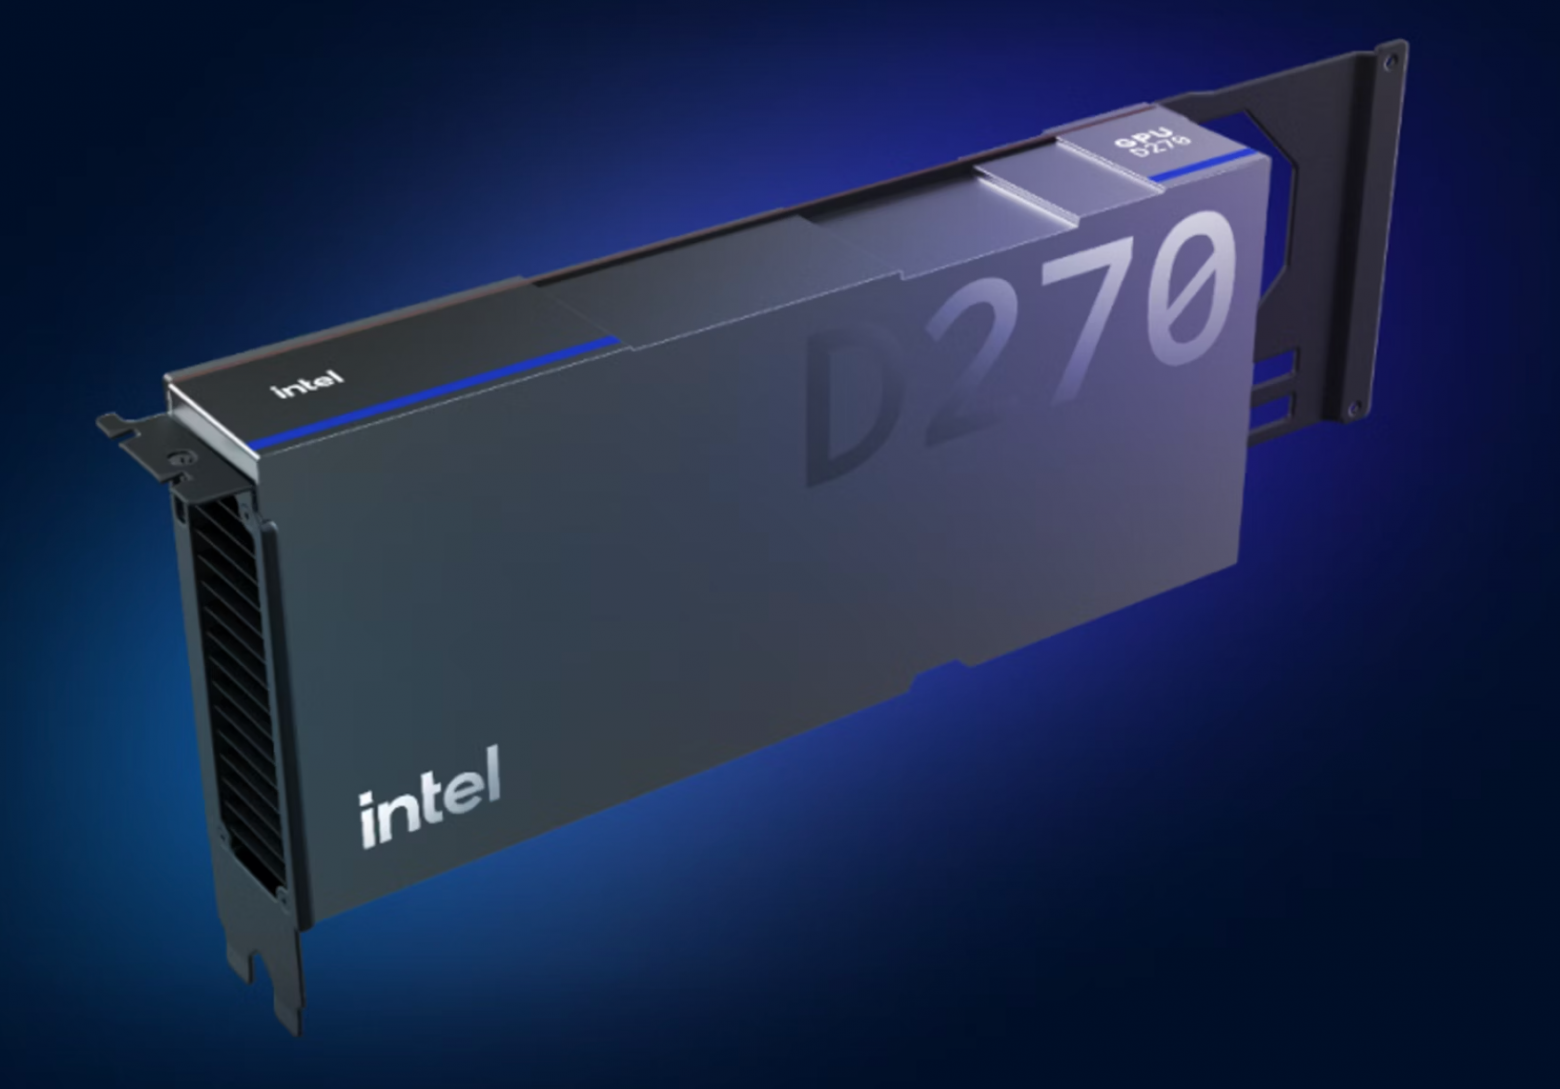
Intel представила ускоритель Crescent Island под названием Intel GPU D270. Он стал первым устройством новой серии D-Series.
Это первые со времен Ponte Vecchio серверные GPU Intel для задач ИИ, которые действительно начинают выходить на рынок: инженерные образцы уже получили OEM-производители, заказчики и западные облачные провайдеры. Для сравнения, продукты линеек Rialto Bridge и Falcon Shores до коммерческих поставок так и не дошли.
Основные характеристики:
-
архитектура Xe3P без графических блоков: 32 ядра Xe, 256 матричных движков XMX и частота около 2,5 ГГц;
-
производительность: 1,3 Пфлопс в FP8 и 10,2 Тфлопс в FP64;
-
память LPDDR5X: до 480 ГБ в партнерских исполнениях и 160 ГБ в референсной карте Intel;
-
двухслотовая карта с интерфейсом PCIe 5.0 x16;
-
воздушная система охлаждения;
-
TDP — 350 Вт.
Память LPDDR5X используют и другие разработчики GPU. В условиях дефицита и роста цен на HBM такой подход может быть полезен для инференса с длинным контекстом, где емкость памяти важнее ее максимальной пропускной способности.
По расчетам Intel, на одной карте поместится модель с 300 млрд параметров, а на восьми — модель более чем с триллионом параметров. Код для Arc Pro можно перенести без переписывания ядер; также заявлена поддержка PyTorch, vLLM, SGLang и Triton. Для сравнения: AMD Instinct™ MI450X предлагает до 432 ГБ HBM4, а NVIDIA Rubin™ — 288 ГБ. Емкость сопоставима, чего нельзя сказать о пропускной способности. Intel также не акцентирует внимание на обмене данными между картами, где ограничением неизбежно станет PCIe.
D270 не претендует на рекорды, и компания этого не скрывает. Вместо этого Intel делает ставку на большой объем сравнительно медленной памяти и стандартные стойки с воздушным охлаждением. Для такого решения есть своя ниша, но многое будет зависеть от готовности ПО и масштабов поставок.
Altera Agilex 2X — FPGA для ИИ и робототехники
Altera анонсировала поколение FPGA Agilex 2X во главе с семейством Agilex 27. Устройства предназначены для инфраструктуры ИИ, терабитного Ethernet, сетей 6G и аэрокосмической отрасли.
Одно из архитектурных нововведений — выделенная внутрикристальная сеть HyperFlow. Она передает данные между блоками на скорости в несколько терабит в секунду, не расходуя ресурсы программируемой логики. Регистры HyperFlex третьего поколения распределены по всей трассировке, благодаря чему Quartus может конвейеризовать проект без дополнительного использования этих ресурсов.
Для защиты предусмотрены постквантовая криптография, MACsec, IDE для PCIe и шифрование памяти на лету.
Agilex 27 включает:
-
трансиверы со скоростью до 256 Гбит/с;
-
аппаратные контроллеры 800GbE и 1,6TbE;
-
интерфейсы PCIe 6.0 и 7.0;
-
UCIe для подключения чиплетов;
-
контроллеры DDR5, LPDDR5X и LPDDR6.
Помимо флагмана, в линейку входят Agilex 25 для обработки видео, Agilex 23 с SoC для промышленной автоматизации, роботов и датчиков, а также Agilex 22 без процессорной части — для систем с большим числом портов ввода-вывода. Все устройства совместимы со средой Quartus Prime и ИИ-помощником QuartusIQ.
Главное ограничение — сроки: инженерные образцы Agilex 27 появятся лишь во второй половине 2027 года. До этого разработчики смогут проектировать устройства в симуляторе.
Iluvatar CoreX Tiangai 300 — соперник NVIDIA H200
Шанхайская компания Iluvatar CoreX на презентации для китайских СМИ заявила, что новый GPU Tiangai 300 по производительности сопоставим с NVIDIA® H200, а в некоторых специализированных задачах превосходит его.
При генерации изображений по текстовому запросу китайский ускоритель показал 0,101 изображения в секунду и успешно выполнил все задания. Результат H200 составил 0,086 изображения в секунду при доле успешных генераций 87,5%. Еще в июле государственная компания INESA зафиксировала для Tiangai 300 коэффициент пропускной способности 1,05 относительно H200 в «типичном развертывании». На MoE-модели новинка обеспечила на 15% большую пропускную способность и до 30% меньшую задержку первого токена на длинных текстах. При дообучении Qwen3-32B чип сравнивали с H100 и получили коэффициент 1,33.
Tiangai 300 впервые показали летом на WAIC 2026, а в январе компания опубликовала дорожную карту с намерением превзойти Rubin™ к 2027 году. Для масштаба: по оценке TrendForce, в 2024 году Iluvatar занимала около 0,3% китайского рынка GPGPU.
Все приведенные показатели исходят от самой компании и лабораторий, связанных с государством. Сравнение с H200, выпущенным в 2023 году, удобно для отчетности: оно одновременно показывает отставание от мировых лидеров и свидетельствует о том, что ряд китайских производителей, включая Huawei и Zhenwu, уже достиг этого уровня. Развертывания с десятками тысяч ускорителей продолжаются, а более конкурентный рынок GPU даст заказчикам больше возможностей для выбора.
AMD Helion — CPU-стойка для агентного ИИ
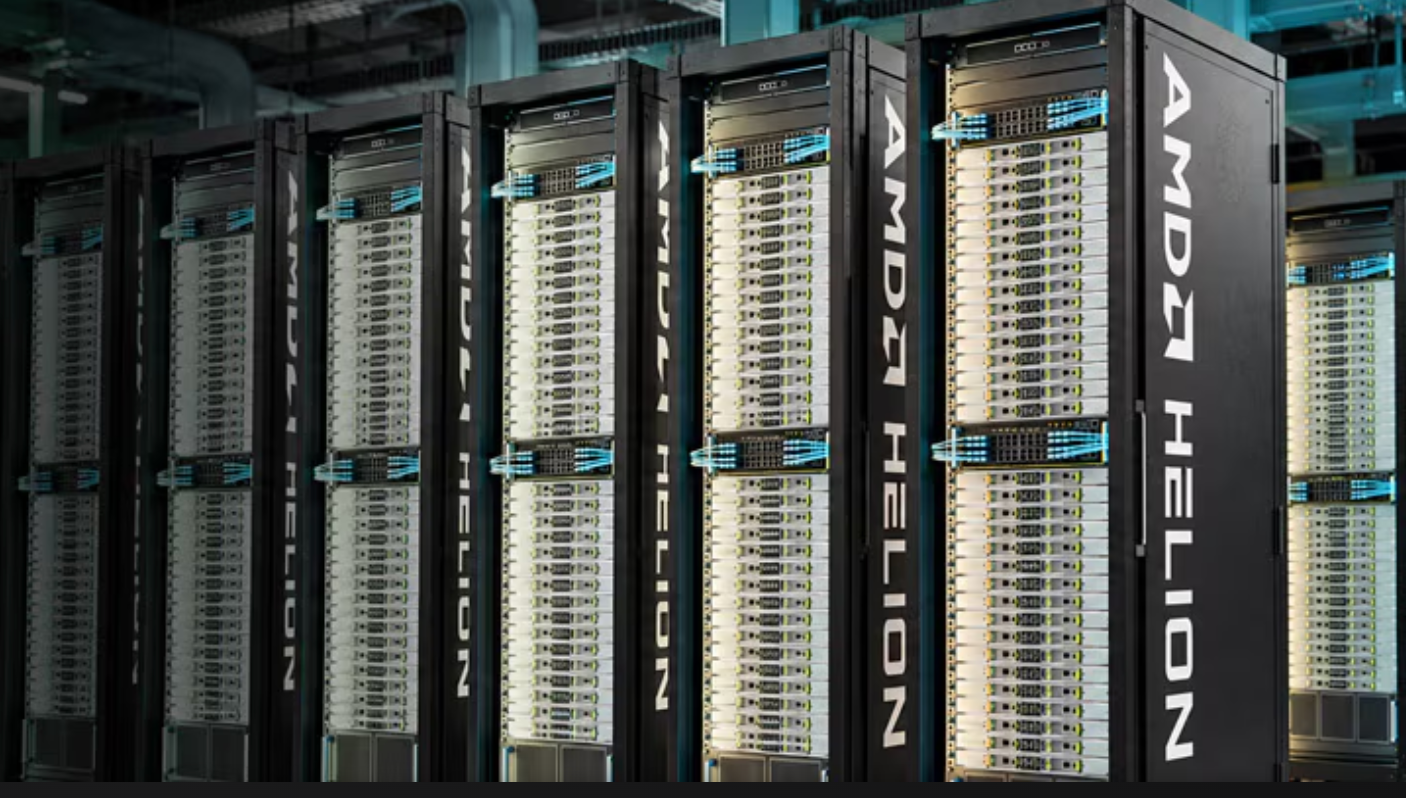
AMD представила эталонный проект Helion™ — стойку ORv3 высотой 44OU для агентного ИИ. Если Helios™ с 72 GPU предназначена для работы моделей, то Helion берет на себя сопутствующие задачи: вызов инструментов, выполнение кода и оркестрацию. Для них используются CPU.
Платформа предлагается в двух вариантах.
-
Для гиперскейлеров — стойка исключительно на EPYC™ Venice 9006 с общим числом ядер до 32 768, подключаемая к отдельной инфраструктуре инференса.
-
Для корпоративных клиентов — комплекс в одном шкафу: узлы EPYC™, до 16 GPU AMD Instinct™ MI350P, интерконнект до 102,4 Тбит/с и ресурсы для вычислений общего назначения.
Предусмотрены конфигурации с воздушным и жидкостным охлаждением.
Поставки систем от OEM-партнеров, включая Dell, HPE, Supermicro, Foxconn и Wiwynn, должны начаться в конце 2026 года.
Это заметное изменение для рынка: раньше стоечные решения для ИИ строились преимущественно вокруг GPU, а теперь CPU-стойка становится самостоятельным продуктом. До 32 000 ядер в одном шкафу выглядят впечатляюще, однако пока перед нами эталонный проект без серийных систем и объявленных цен.
Арендуйте сервер с доставкой на вашу площадку
Предоставим производительные серверы для запуска проекта on-premise: с помесячной оплатой, полным контролем над оборудованием с самого начала и возможностью последующего выкупа.
NVIDIA MGX 1.2 — анонс в день презентации AMD Helion
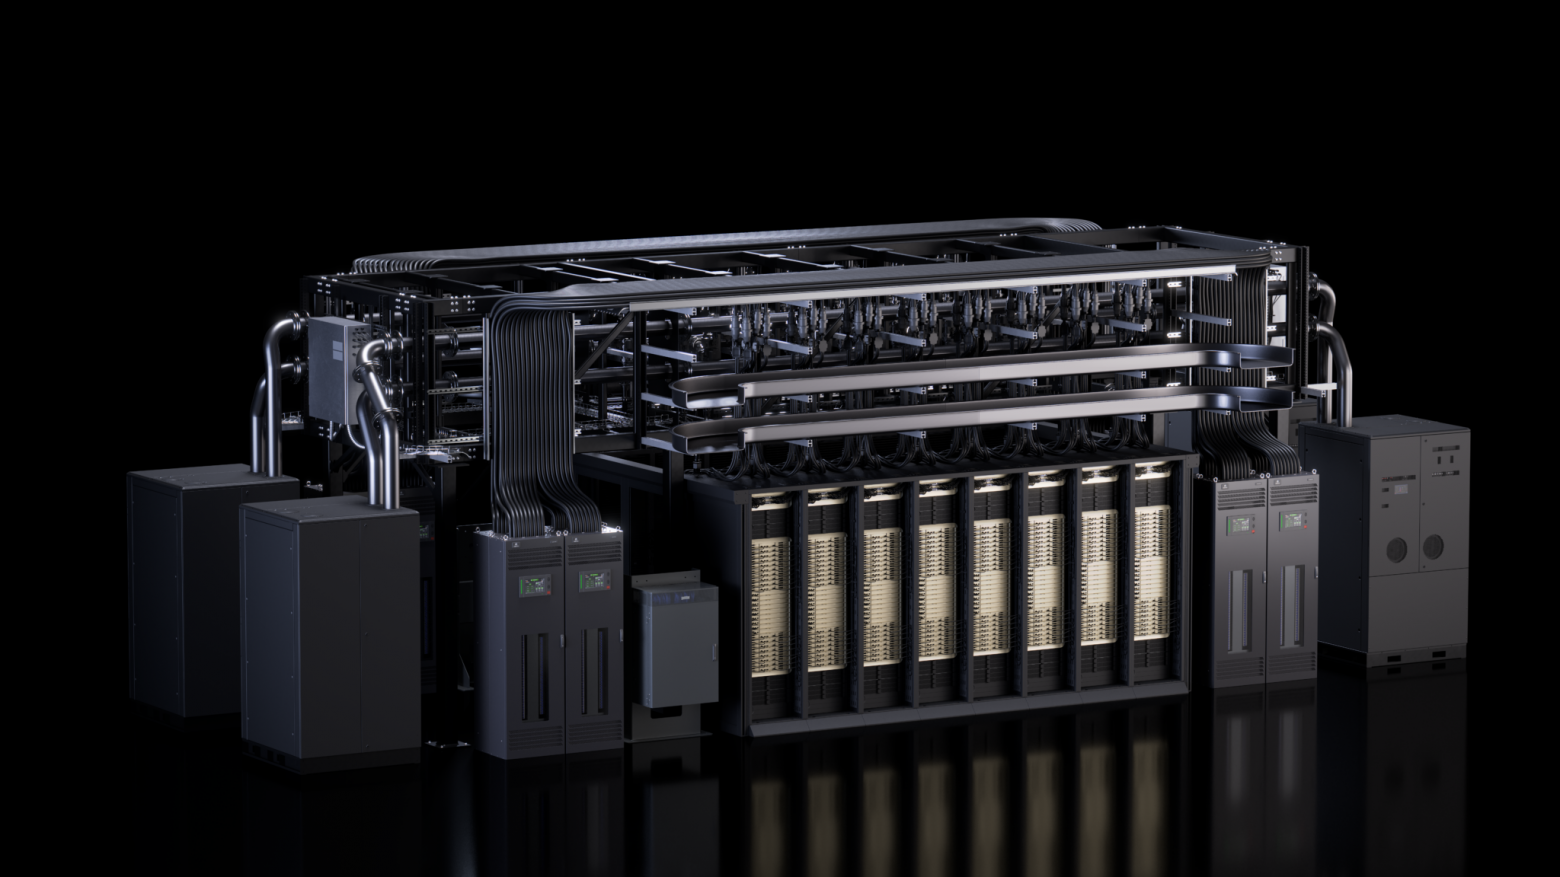
NVIDIA передала в OCP спецификации стоек и узлов Vera Rubin™ в рамках MGX, а также присоединилась к Open DC Initiative, которая разрабатывает эталонный проект ИИ-ЦОД третьего поколения.
Спецификации MGX 1.2 дополнили системами жидкостного охлаждения с соединениями blind-mate, стандартизированной стоечной инфраструктурой интерконнекта и охлаждаемой жидкостью DC-шиной на 5 000 А. Также добавили поддержку 19-дюймового оборудования и стоек повышенной плотности, конфигурируемые модули ввода-вывода, безвентиляторные узлы с СЖО и унифицированные интерфейсы питания и охлаждения. Максимальная мощность достигает 250 кВт на стойку.
Отдельный проект посвящен стойке на CPU Vera™: пока Vera Rubin™ NVL72 выполняет обучение и инференс, процессорная стойка работает с внешними инструментами, оркестрацией и песочницами. Идея совпадает с AMD Helion™, причем обе компании представили решения в один день.
Открытая спецификация MGX выгодна и NVIDIA: чем больше производителей создают совместимые стойки, тем шире потенциальный рынок ее чипов.
Astera Labs Orion — стойка для разных ускорителей
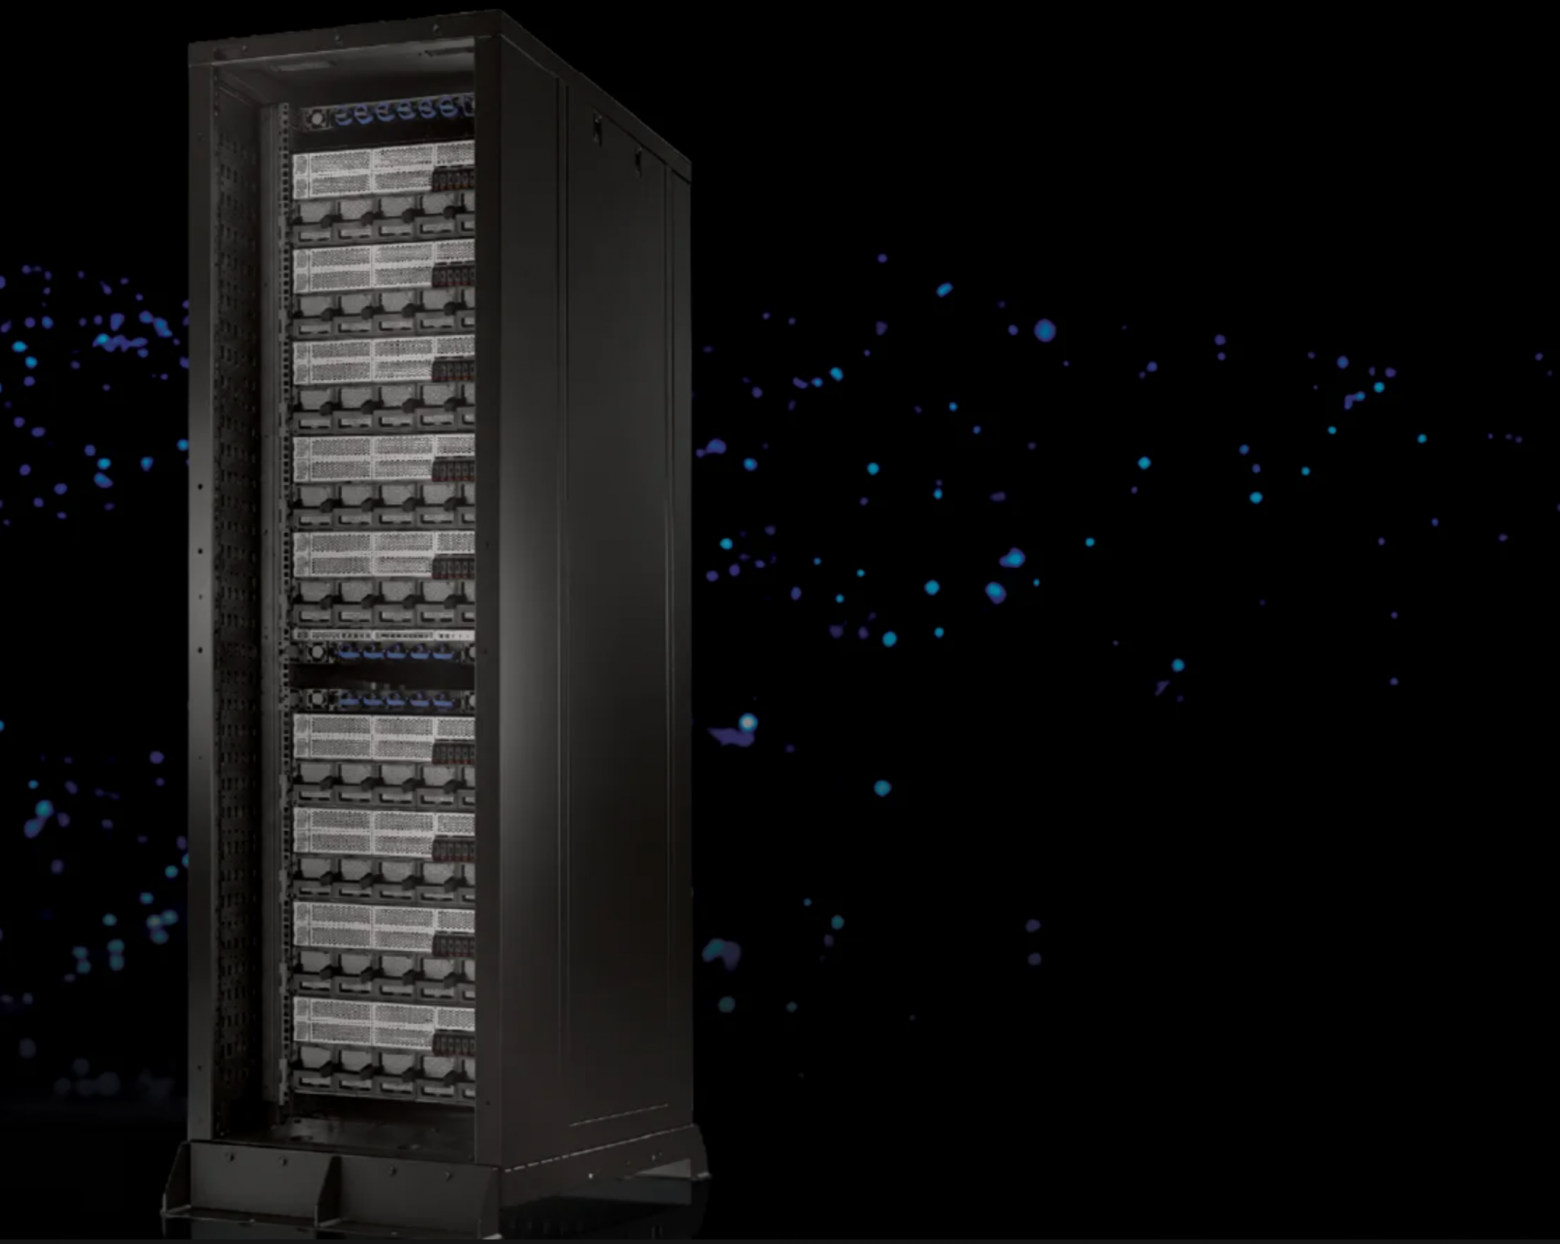
Astera Labs представила эталонную стойку Orion, рассчитанную на любые PCIe-ускорители и не привязанную к проприетарным платформам NVIDIA или AMD. Решение может заинтересовать «неооблака», которым трудно получить флагманские GPU, а создание собственной стоечной платформы обходится дорого и занимает много времени.
Архитектура построена на 320-линейных коммутаторах Scorpio X-Series с PCIe 6.0. Двухуровневая топология позволяет разместить до 80 ускорителей в стойке и до 160 в поде, объединив их в одном домене PCIe без перехода на Ethernet или InfiniBand. Комплект включает шесть эталонных проектов: стойку, вычислительный лоток на восемь карт, коммутационный лоток, модуль расширения памяти с CXL-контроллерами Leo, соединительную и вычислительную платы. Для управления предусмотрены COSMOS Rack Manager и Fabric Manager.
Поставки через OEM- и ODM-партнеров начнутся в первом квартале 2027 года. Собственных ускорителей Astera не выпускает, зато поставляет почти все остальные компоненты стойки: коммутаторы, ретаймеры, CXL-решения и ПО.
SpacemiT Vital Stone V100 — серверный процессор RISC-V
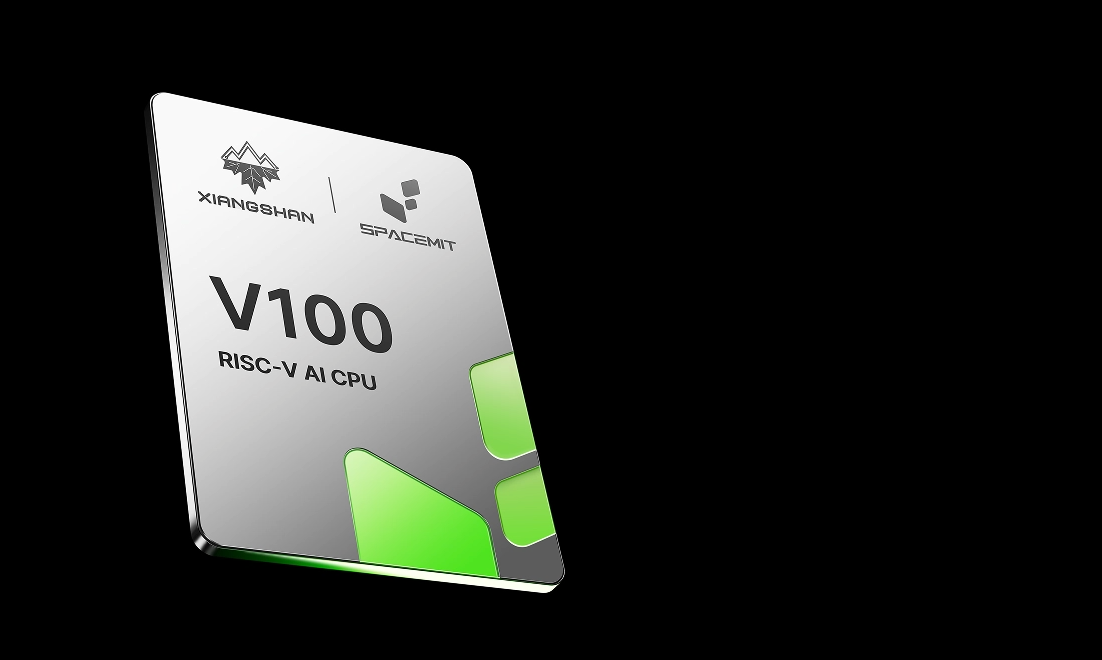
Китайская компания SpacemiT представила серверный RISC-V-процессор Vital Stone V100. По словам разработчиков, это первый в отрасли чип с полным соответствием серверной спецификации RISC-V: он поддерживает UEFI, ACPI, SMBIOS и профиль RVA23.
Характеристики:
-
всего 46 ядер: 40 собственных X100 с частотой до 2,4 ГГц и 2 МБ кэша L2, а также 6 Xiangshan Kunming Lake V2R2 с частотой до 2,1 ГГц и 1 МБ кэша L2;
-
восемь каналов памяти DDR5-4800;
-
52 линии PCIe 5.0;
-
TDP — 120 Вт;
-
12-нм техпроцесс и корпус FCBGA размером 58,5 × 75,4 мм;
-
поддержка двухсокетной конфигурации с общим числом ядер 92;
-
аппаратное ускорение AES, SHA, RSA и китайских алгоритмов SM2, SM3 и SM4.
Интересно сопоставить итоговый продукт с первоначальными планами. В январе 2025 года V100 анонсировали с «до 64 ядер X100» на частоте 2,5 ГГц. В серийном процессоре ядер меньше, а часть из них относится к другой архитектуре. До Xeon®, EPYC™ и даже ARM-серверов ему далеко. Зато из коробки поддерживаются openEuler, openKylin, Ubuntu, Debian и Fedora, а KVM, QEMU, Docker, MySQL и PostgreSQL уже портированы. Для развития экосистемы RISC-V и повседневных задач этого достаточно. Упомянутое в пресс-релизе «обучение ИИ-моделей» выглядит куда смелее: здесь процессор скорее подойдет для подачи данных ускорителям.
Kioxia GP1 — SSD с XL-Flash третьего поколения
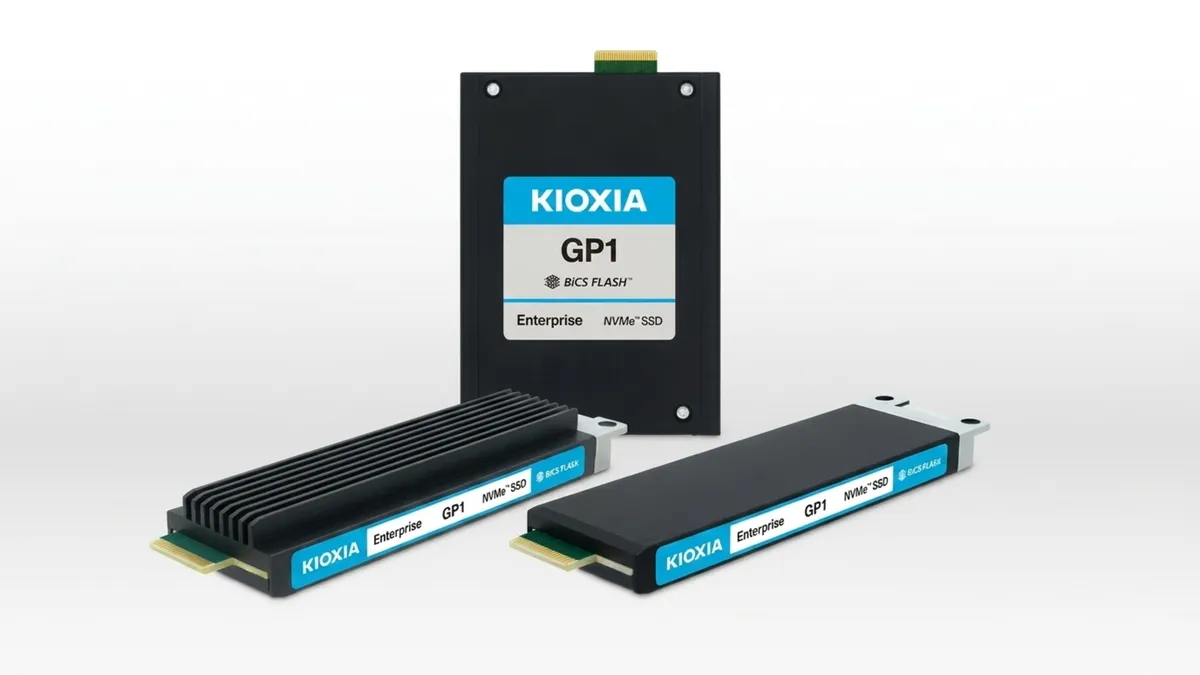
Kioxia сообщила, что превзошла собственный августовский рекорд. Компания показала обновленный SSD GP1 на XL-Flash третьего поколения с производительностью свыше 20 млн IOPS при случайном чтении блоков по 512 байт. Это вдвое больше 10 млн IOPS, достигнутых накопителем первого поколения.
XL-Flash Gen3 считывает данные в три раза, а записывает примерно в 2,5 раза быстрее предшественника. Для уменьшения RC-задержки разработчики укоротили словарные и битовые линии, а также увеличили число плоскостей на кристалл — у Gen2 их было 16. Заявленная энергоэффективность одной операции выросла на 40% при чтении и на 80% при записи.
Известные характеристики:
-
прежние интерфейсы PCIe 6.0 и NVMe 2.2;
-
форм-факторы E3.S и E1.S;
-
в первых GP1 ячейки MLC работают в режиме pSLC;
-
ресурс — до 50 DWPD.
Другие параметры обновленной версии пока не раскрыты, поэтому ее стоит рассматривать прежде всего как демонстрацию технологии.
Накопители GP1 занимают промежуточное положение между HBM и обычными SSD. По сути, их можно считать наследниками Optane. В дорожной карте Kioxia уже фигурирует показатель 100 млн IOPS с PCIe 7.0 — достойное развитие направления, от которого отказалась Intel.
Kioxia CM9-DLC — SSD с жидкостным охлаждением
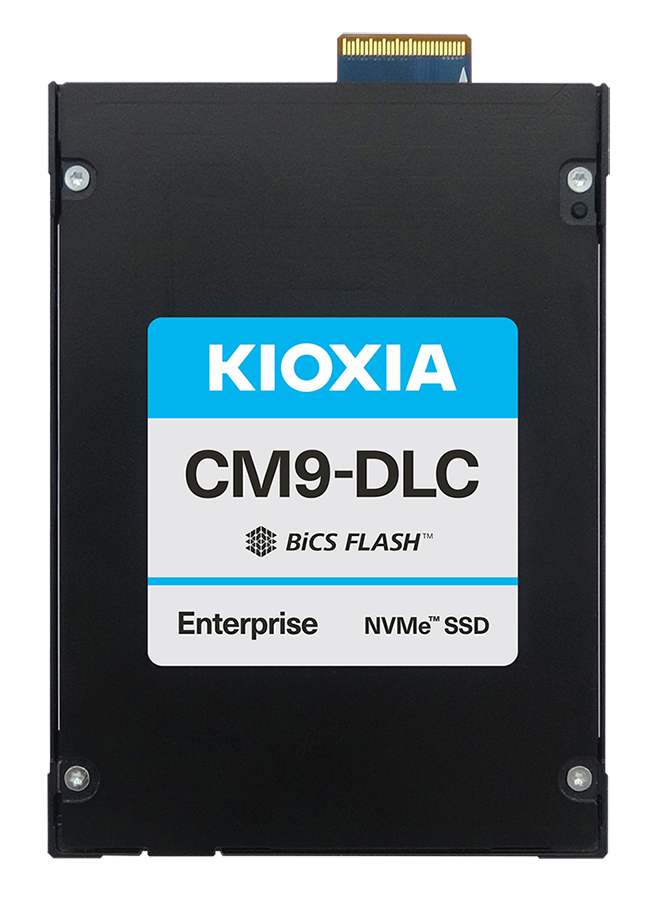
Еще одна разработка Kioxia — серия CM9-DLC. Это накопители E3.S с прямым жидкостным охлаждением, предназначенные для кэширования контекста в ИИ-серверах.
Характеристики:
-
модели для смешанной нагрузки емкостью 6,4, 12,8 и 25,6 ТБ с ресурсом 3 DWPD;
-
модели для преимущественного чтения емкостью 7,68, 15,36 и 30,72 ТБ с ресурсом 1 DWPD;
-
два порта и память BiCS FLASH TLC восьмого поколения;
-
интерфейсы PCIe 5.0 и NVMe 2.0;
-
последовательное чтение до 14 800 МБ/с, запись до 11 000 МБ/с и случайное чтение блоков 4K до 3,4 млн IOPS.
CM9-DLC поддерживают PLP, мгновенное стирание и сквозное шифрование. Их можно устанавливать и в серверы с воздушным охлаждением, но прежде всего они рассчитаны на системы с СЖО. В сервере, где основные компоненты уже охлаждаются жидкостью, SSD с воздушным обдувом оставался одним из последних горячих элементов — теперь накопители тоже можно подключить к контуру.
SP Industrial — SSD на памяти eTLC
Промышленное подразделение Silicon Power представило шесть корпоративных SSD на 3D eTLC с DRAM-буфером и защитой от потери питания. Новые модели E1.S и U.2 перешли на PCIe 5.0, тогда как в предыдущих поколениях U.2 поддерживался максимум PCIe 4.0.
В анонсированную линейку вошли:
-
E1.S (EE1S3F0) емкостью до 7,6 ТБ с аппаратной поддержкой пространств имен;
-
U.2 (ESSU3J0, ESSU3F0, ESSU3I0) объемом до 15,3 ТБ;
-
загрузочные M.2 2280 (EMEC3I0) на PCIe 4.0 емкостью от 480 ГБ до 1,9 ТБ;
-
SATA SFF объемом до 7,6 ТБ.
Заявленный ресурс составляет 1 или 3 DWPD. Подробные характеристики пока не опубликованы, но линейка выглядит подходящей для edge-серверов и сетевого оборудования.
Marvell Structera X 3406 и 3506 — расширение памяти по CXL
Marvell представила второе поколение расширителей памяти CXL. Названия моделей устроены по принципу шифра: первая цифра обозначает поколение CXL, вторая — тип DDR, а две последние — число каналов. Так, 3406 означает CXL 3, DDR4 и шесть каналов.
Характеристики:
-
3406 поддерживает 18 модулей DDR4 RDIMM на 1 600 МТ/с — по три на канал — и формирует пул объемом до 9 ТБ;
-
3506 поддерживает 12 модулей DDR5 RDIMM с общим объемом до 6 ТБ;
-
оба чипа используют CXL 3.2 через PCIe 6.0 x16;
-
число каналов выросло с четырех у моделей 2404 и 2504 до шести;
-
один контроллер обслуживает до четырех хостов с совокупной пропускной способностью до 256 ГБ/с.
Блок сжатия LZ4 обеспечивает 250 ГБ/с — в пять раз больше, чем раньше, — и, по данным Marvell, увеличивает эффективную емкость в 2–3 раза. Для LLM компания обещает снижение TTFT на 40–50% при неизменной длине контекста. В числе средств защиты и надежности — RAS StructGuard, Caliptra 2.0, шифрование канала CXL, AES-256 для памяти и постквантовая защита.
Marvell называет решения первыми CXL-расширителями с таким набором характеристик. Образцы ожидаются в первом квартале 2027 года. Особенно интересна версия для DDR4: серверов с такой памятью на рынке по-прежнему много, и компания предлагает объединить ее в общий пул для KV-кэша. В таком сценарии технология может помочь сократить расходы.
Samsung и AMD — CXL-пул DRAM, часть 1
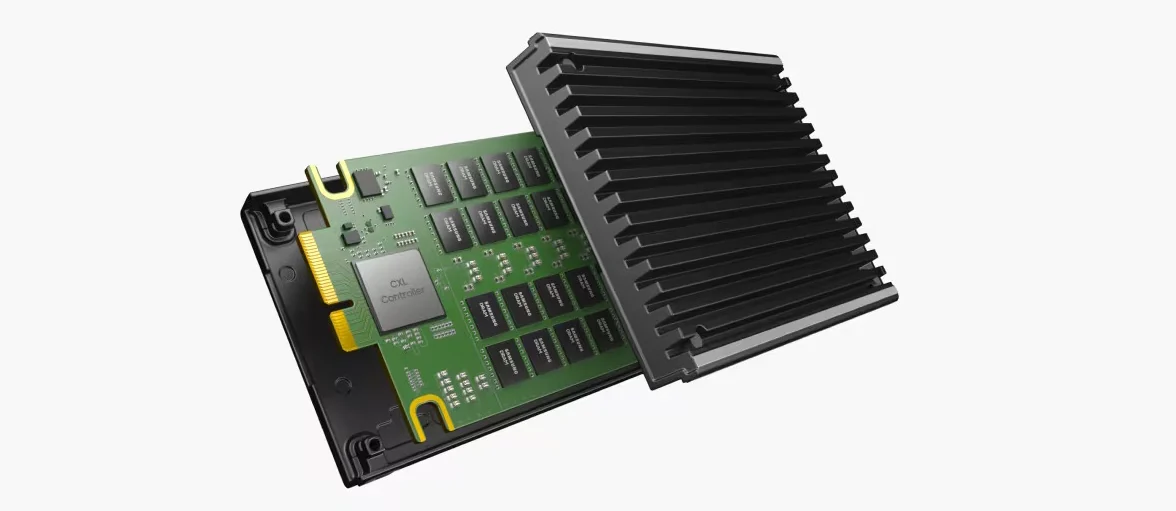
Samsung и AMD продемонстрировали пул памяти на модулях CMM-D для агентного инференса. В основе лежит механизм CXL Dynamic Capacity Device: хост запрашивает память по мере необходимости и затем возвращает ее в пул. Например, экземпляр LLM с увеличившимся контекстом может временно получить дополнительную емкость.
По данным Samsung, по сравнению со статическим распределением технология сокращает TTFT на величину до 38% и повышает полезную пропускную способность, или goodput, до 3,3 раза. Она также помогает уменьшить простои CPU, возникающие, когда емкости и пропускной способности памяти не хватает для имеющегося числа ядер.
Испытания проводились на платформе AMD. Конфигурацию серверов, топологию CXL-коммутаторов, задержки и сроки выхода компании не раскрыли, поэтому пока речь идет о демонстрации, а не готовом продукте.
Astera Labs Leo — CXL-пул DRAM, часть 2
Для аналогичного сценария Astera Labs представила контроллеры Leo X-Series. Они подключают память непосредственно к сетевому слою GPU-ускорителей, минуя CPU, и предназначены для KV-кэша и контекста ИИ-агентов. Leo 2 E-Series с CXL 3.2 и PCIe 6.0 расширяют память одного процессора без дополнительных сокетов, а Leo 2 P-Series объединяют память в пул для нескольких хостов.
За один месяц CXL-пулы продемонстрировали сразу несколько компаний — похоже, технология готова к более широкому применению.
Контроллеры Microchip: Switchtec PCIe 6.0, Flashtec 5016 и SmartRAID 4300
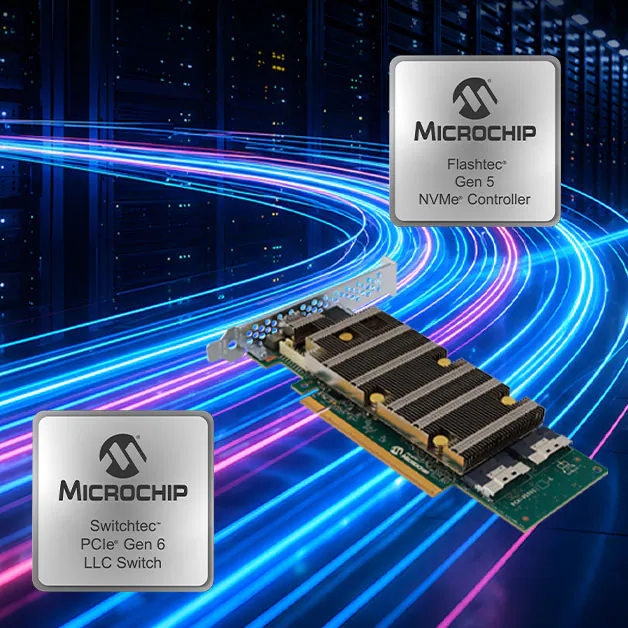
Microchip представила три новых продукта.
Компактный коммутатор Switchtec PCIe 6.0 предлагает:
-
64 линии и 32 порта с бифуркацией от x2 до x16;
-
встроенный DMA и поддержку Multicast;
-
аппаратный RoT и Secure Boot.
SSD-контроллер Flashtec 5016 с PCIe 5.0 получил:
-
16 каналов NAND;
-
поддержку до четырех рангов DDR5-5200;
-
FDP и ZNS;
-
CNSA 2.0;
-
два порта;
-
до 3,5 млн IOPS при случайном чтении 4K и более 14 ГБ/с.
Наиболее примечателен обновленный SmartRAID 4300. Он выполняет RAID-вычисления для NVMe-накопителей, напрямую подключенных к CPU, поэтому совокупная скорость не ограничивается собственным интерфейсом контроллера PCIe 4.0 x16. Характеристики:
-
поддержка до 32 накопителей и 64 логических томов;
-
RAID 0/1/10/5/50/6/60;
-
до 27,2 млн IOPS при чтении и до 300 ГБ/с при последовательном чтении в Linux с RAID 0.
Пересборка выполняется напрямую между SSD по схеме P2P, без участия процессора. Низкопрофильная карта HHHL с потреблением 21 Вт может стать привлекательной альтернативой программному RAID, который занимает часть процессорных ядер.
NVIDIA и Cisco представили формат USFP
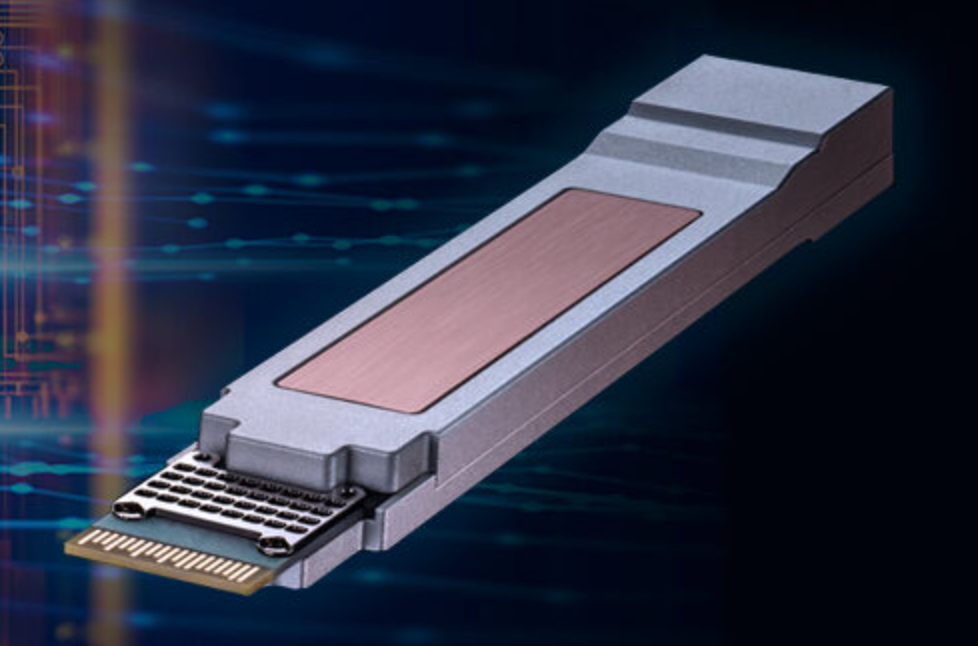
NVIDIA и Cisco предложили USFP — новый форм-фактор сменных оптических трансиверов. Ultra-Dense Small Form Factor Pluggable рассчитан на 400 Гбит/с на электрическую линию. Первые модули получат 16 полнодуплексных линий и обеспечат 6,4 Тбит/с в корпусе размером с OSFP. В дальнейшем планируется удвоить показатели до 32 линий и 12,8 Тбит/с.
Плотность пропускной способности на передней панели в четыре раза выше, чем у современных модулей с 200 Гбит/с на линию, а энергоэффективность лучше примерно в 1,3 раза. При этом один модуль рассеивает до 100 Вт без собственного контура охлаждения. Разъем с двумерной матрицей контактов подключается в два этапа: сначала закрепляется корпус, затем соединяются высокоскоростные контакты. Это уменьшает износ и улучшает качество сигнала.
Корпуса и разъемы производят TE Connectivity и Amphenol, а спецификацию планируют открыть через MSA. При этом Arista в инициативе USFP не участвует и продвигает собственный формат XPO без NVIDIA и Cisco. Не исключено, что для линий 400G развернется новая конкуренция форм-факторов. Сроки и цены пока не объявлены.
Celestica DS6005 и Micas Networks — готовые устройства на Tomahawk 6
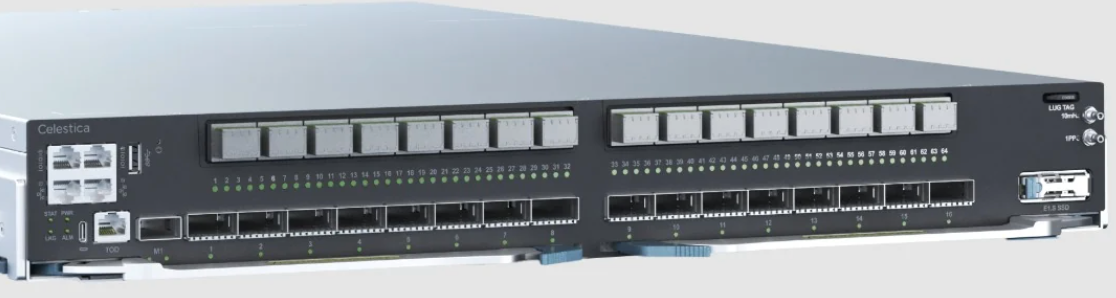
Broadcom Tomahawk 6 с пропускной способностью 102,4 Тбит/с появился в готовых продуктах. Один из них — Celestica DS6005, CPO-коммутатор высотой 1.5OU для ORv3 на базе Tomahawk 6 Davisson:
-
64 порта по 1,6 Тбит/с через 16 разъемов MMC-16;
-
16 сменных лазерных модулей ELSFP на передней панели;
-
полностью жидкостное охлаждение;
-
управляющий процессор AMD Ryzen™ и операционная система SONiC.
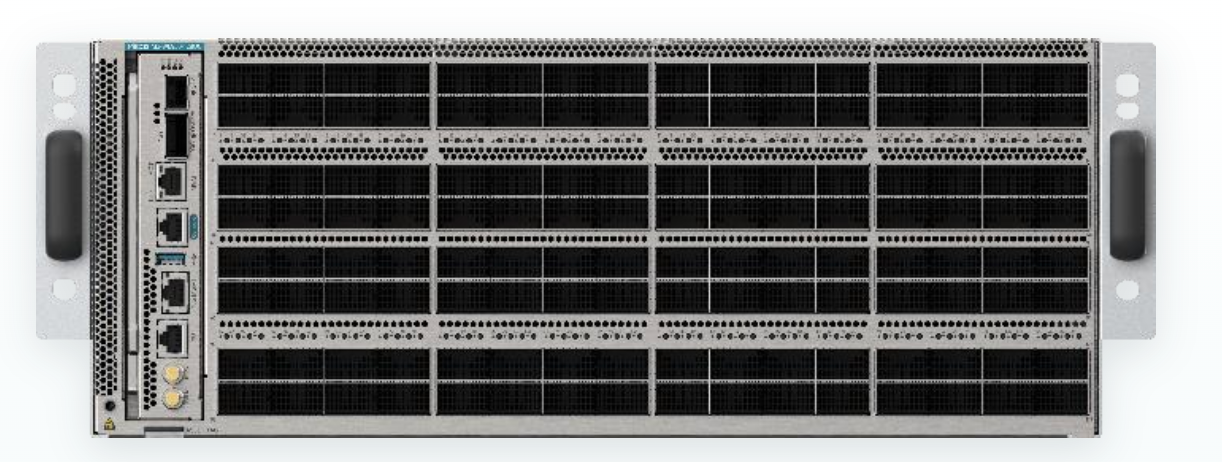
Компания Micas Networks, в свою очередь, представила три модели.
-
M2-W6950-128OC-FA: устройство высотой 4U с воздушным охлаждением и 128 портами OSFP по 800 Гбит/с. Производство начнется в текущем квартале.
-
M2-W6951-64HC-CP: высокоплотный коммутатор высотой 2U с СЖО и 64 портами по 1,6 Тбит/с. Серийное производство намечено на конец 2026 года.
-
CPO-версия высотой 1U на базе Davisson с 64 оптическими портами MMC DR8 появится в первом квартале 2027 года.
Эти модели наглядно показывают, как одну и ту же пропускную способность 102,4 Тбит/с можно разместить в разных объемах: 4U с воздушным охлаждением, 2U с жидкостным и 1U с CPO. Вынесенные лазеры ELSFP снимают одно из главных опасений относительно CPO: при отказе лазера не придется менять коммутатор целиком.

Сервер собственной разработки Selectel
В основе — современные процессоры Intel® Xeon® 6, до 8 ТБ DDR5 и специально разработанная материнская плата. Арендуйте сервер в Selectel или закажите его для своего дата-центра.
Frore LiquidJet Diamond — охлаждение с алмазными вставками
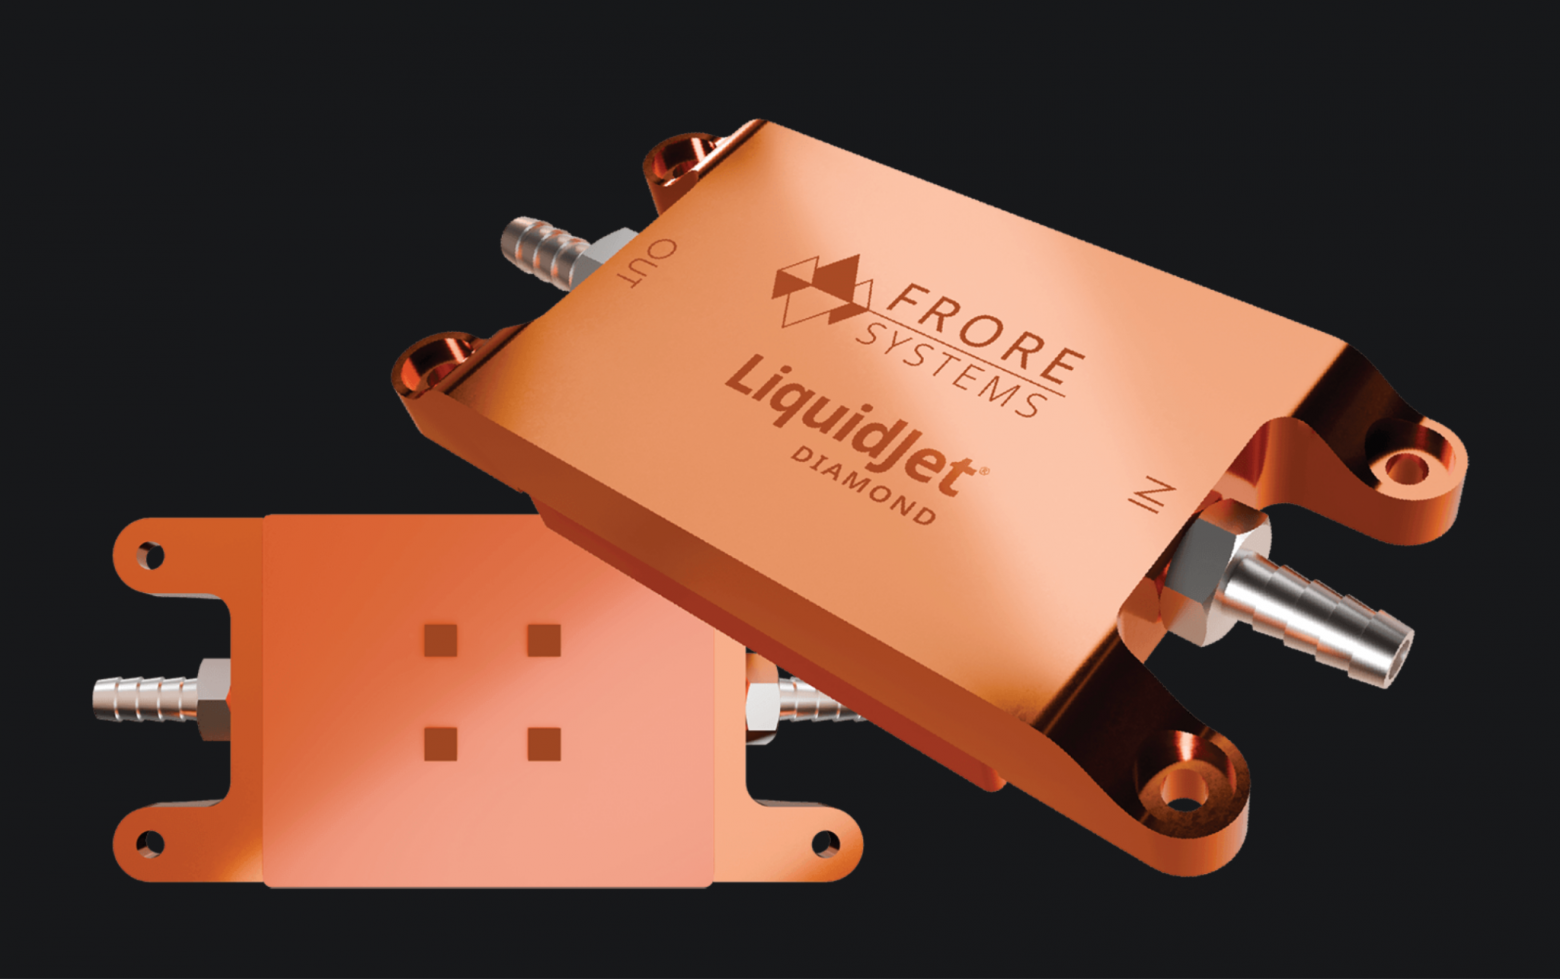
Frore Systems показала LiquidJet Diamond — технологию, в которой синтетические алмазы встроены непосредственно в водоблок. Пластину с теплораспределителем изготавливают под конкретный GPU, размещая алмазные вставки точно над наиболее горячими участками кристалла.
Решение основано на архитектуре LiquidJet с трехмерным многоступенчатым ультракоротким контуром: каналы направляют жидкость сначала к горячим точкам, затем к кристаллу и HBM. Базовая версия снижала температуру GPU на 12 °C по сравнению с обычными ребристыми пластинами, а алмазные вставки дают дополнительное снижение до 10 °C в горячих точках. Общий результат — минус 16–22 °C.
Пластина справляется с горячей точкой размером 5 × 5 мм при плотности теплового потока 770 Вт/см², но условия испытания важны: температура воды на входе составляла 25 °C, Tj — до 95 °C, использовался термоинтерфейс PTM7950 и кристалл без крышки. На OCP компания демонстрировала охлаждение конфигурации NVIDIA® Rubin™ мощностью 2 300 Вт.
Обещанное увеличение числа токенов на ватт на 30–35% получено расчетом по тепловым моделям, а не измерением энергопотребления ЦОД. Источники также не поясняют, как именно Frore изготавливает и закрепляет алмазные пластины, хотя от этого зависят стоимость и выход годных изделий. Сам принцип выглядит разумно: дорогой материал применяется только там, где он действительно необходим.
Итоги
Октябрь обозначил несколько важных тенденций. Во-первых, производители ищут временную альтернативу дорогой и дефицитной HBM: Intel® D270 предлагает до 480 ГБ более доступной LPDDR5X. Во-вторых, AMD и NVIDIA в один день представили отдельные CPU-стойки для агентного ИИ. Большинство новинок превратится в серийные продукты не раньше 2027 года — тогда и можно будет проверить заявления производителей на практике.
Похожие статьи
 Смартфон и карты больше не нужны: в часах Huawei появилась оплата через «Яндекс Пэй»
 200 Мп, перископическая камера и экран до 185 Гц: Xiaomi 18T представят уже в декабре 2026 года
 Project Crystal Sun: Tesla возводит новый гигантский завод в Техасе
 Samsung сосредоточится на Galaxy S27 Ultra и S27 Pro: на них придётся свыше 70% производства новой линейки
 Фонд Гейтсов выделил $2,7 млн на тестирование лекарств от туберкулёза и малярии на мышах с человеческими генами
 Microsoft может платить пользователям за обучение ИИ на их простаивающих видеокартах
 AMD подтвердила проблему в графическом драйвере: atieclxx.exe записывает мусорные данные на накопитель
 Minisforum выпустила мини-ПК T5 Max-38 с APU с мощнейшей встроенной графикой и 48 ГБ ОЗУ за 1560 долларов