Тест на слабом ПК: почему мне не подошел Spark и что лучше выбрать среди pandas, Polars и DuckDB
Ситуация классическая: загружаете объемный файл в pandas, Jupyter Notebook намертво зависает, кулер начинает реветь, а через мгновение процесс аварийно завершается с MemoryError. Разумный совет со стороны сообщества или старших коллег следует незамедлительно: для компактных датасетов используйте pandas, а для масштабных — Spark. Мне захотелось подкрепить это утверждение объективными метриками. Причем тестировал я не в облачном кластере, где Spark чувствует себя вальяжно, а на заурядном железе, сопоставимом с типичным лэптопом дата-аналитика.
Для этих целей я разработал утилиту TableBench. Она автономно формирует синтетические датасеты, выполняет идентичные сценарии на различных фреймворках, фиксирует время выполнения, потребление RAM и верифицирует корректность итоговых результатов. Репозиторий открыт, линк ждет вас в конце статьи, поэтому воспроизвести тесты на своем устройстве можно одной командой.
Материал ориентирован на уверенных пользователей pandas, которые наслышаны о Polars и DuckDB, но никак не находили времени познакомиться с ними на практике.
Подобных бенчмарков в сети предостаточно, самый известный — db-benchmark, курируемый разработчиками DuckDB. Он запускает тесты на мощном «железе» и фокусируется на чистой скорости. Меня же интересовали иные аспекты: поведение систем при дефиците ресурсов, предельные объемы данных для каждого инструмента и неочевидные подводные камни.
Кого и на чем тестировал
В испытании участвовали шесть инструментов. Классический pandas и его вариация с dtype_backend="pyarrow", задействующая внутреннее хранение в стандарте Arrow. Polars в ленивом (lazy) режиме, формирующий комплексный план запроса с отложенным вычислением до вызова collect(), а также Polars с потоковым движком collect(engine="streaming"), обрабатывающим информацию порциями. DuckDB — встраиваемая аналитическая СУБД, позволяющая выполнять чистый SQL прямо над файлами Parquet. И, наконец, PySpark в локальном режиме, задействующий все доступные ядра процессора.
Сценариев было пять, все они отражают типовые рутинные задачи:
|
Операция |
Описание |
|---|---|
|
Импорт в оперативную память |
полное чтение таблицы |
|
Фильтрация и агрегация |
временной срез, группировка по двум ключам, пять вычислений (по мотивам запроса Q1 из TPC-H) |
|
Соединение (Join) |
мэппинг позиций с отфильтрованными заказами и расчет выручки в разбивке по приоритетам |
|
Оконные вычисления |
выборка наиболее дорогой позиции внутри каждого заказа, аналог фильтрации |
|
Сортировка и экспорт |
глобальная сортировка по двум атрибутам с сохранением в формат Parquet |
Код для каждого движка написан в идиоматическом ключе. Никаких экзотических оптимизаций, но и без намеренного ухудшения производительности. Из конфигураций я зафиксировал лишь лимиты RAM для Spark и DuckDB (на уровне 60% от доступного объема) и число shuffle-партиций в Spark, равное количеству ядер.
Использовались следующие версии окружения: pandas 3.0.6, pyarrow 25.0.1, Polars 1.44.2, DuckDB 1.5.5, PySpark 4.2.0 (на базе Java 21) и Python 3.11.
Датасеты и тестовый стенд
Структура данных базируется на схеме TPC-H — признанного эталона в мире баз данных. Набор включает таблицу заказов orders и таблицу их позиций lineitem, причем основная вычислительная нагрузка приходится именно на последнюю. Генератор я написал самостоятельно: это избавляет от необходимости скачивать тяжелые файлы, а фиксированный масштаб гарантирует идентичность генерируемых данных вплоть до последней строки на любом компьютере.
|
Масштаб (Scale) |
Строк в lineitem |
Объем lineitem на диске |
|---|---|---|
|
1 |
6 млн |
149 МБ |
|
3 |
18 млн |
460 МБ |
|
10 |
60 млн |
1,6 ГБ |
|
30 |
180 млн |
5,2 ГБ |
Конфигурация стенда намеренно выбрана скромной. Это облачная виртуальная машина с 2 ядрами Intel Xeon (2,1 ГГц) и 5,8 ГБ доступной оперативной памяти. Ближе к реальности старого рабочего ноутбука. Зато в таких условиях аппаратные ограничения проявляются молниеносно, четко показывая порог выносливости каждого фреймворка.
Методология для обеспечения достоверности
Каждое измерение изолировано в отдельном системном процессе. Это исключает пересечение кэшей между библиотеками, а падение одной из них не прерывает общий пайплайн. Замеры выполнялись трижды, в финальный отчет шла медиана. Перед началом тестов файлы однократно считывались целиком, чтобы ОС поместила их в файловый кэш — иначе первый участник нес бы издержки на «холодное» чтение диска, ставя остальных в неравные условия.
Мониторинг памяти потребовал особого внимания. Фоновый поток опрашивал метрики каждые 50 мс, учитывая и родительский, и все дочерние процессы: у PySpark основные ресурсы поглощает JVM, а не интерпретатор Python, так что без этого Spark казался бы обманчиво экономным. Кратковременные пики между итерациями можно было пропустить, поэтому по завершении теста процесс самостоятельно рапортовал ОС о своем максимальном потреблении. На выполнение отводилось не более 5 ГБ; превышение лимита трактовалось как нехватка памяти, предотвращая уход системы в подкачку (swap), которая полностью разрушает тайминги.
Инициализация Spark-сессии занимает около 5 секунд, поэтому это время было исключено из расчетов, иначе на легких задачах Spark проигрывал бы исключительно из-за накладных расходов на старт. Если инструмент падал на определенном объеме, на более крупных датасетах он уже не запускался.
И главное — система контроля качества. Каждая операция возвращала контрольные хэши, число строк и суммы, которые автоматика сверяла между всеми участниками. Эта верификация помогла обнаружить реальный баг, о котором речь пойдет ниже.
Результаты тестирования
Полный цикл тестов занял около двух часов. Прогоны для DuckDB, оконных функций Polars и потокового режима Polars я переснимал отдельно ввиду оптимизации их кода (об этом позже). Начнем с макрокартины: объемы данных, на которых инструменты впервые потерпели крах.
|
|
Импорт |
Группировка |
Join |
Окно |
Сортировка и экспорт |
|---|---|---|---|---|---|
|
pandas |
18 млн |
60 млн |
180 млн |
180 млн |
18 млн |
|
pandas + pyarrow |
60 млн |
60 млн |
180 млн |
180 млн |
18 млн |
|
Polars |
60 млн |
180 млн |
180 млн |
180 млн |
18 млн |
|
Polars streaming |
как у Polars |
без сбоев |
без сбоев |
180 млн |
как у Polars |
|
DuckDB |
180 млн* |
без сбоев |
без сбоев |
без сбоев |
180 млн* |
|
PySpark |
без сбоев |
без сбоев |
60 млн |
без сбоев |
60 млн |
* DuckDB уперся не в RAM, а в лимит дискового пространства для временных файлов.
Загрузка и сортировка у обеих реализаций Polars выполнялись идентичным кодом, поэтому для streaming-режима эти тесты отдельно не проводились.

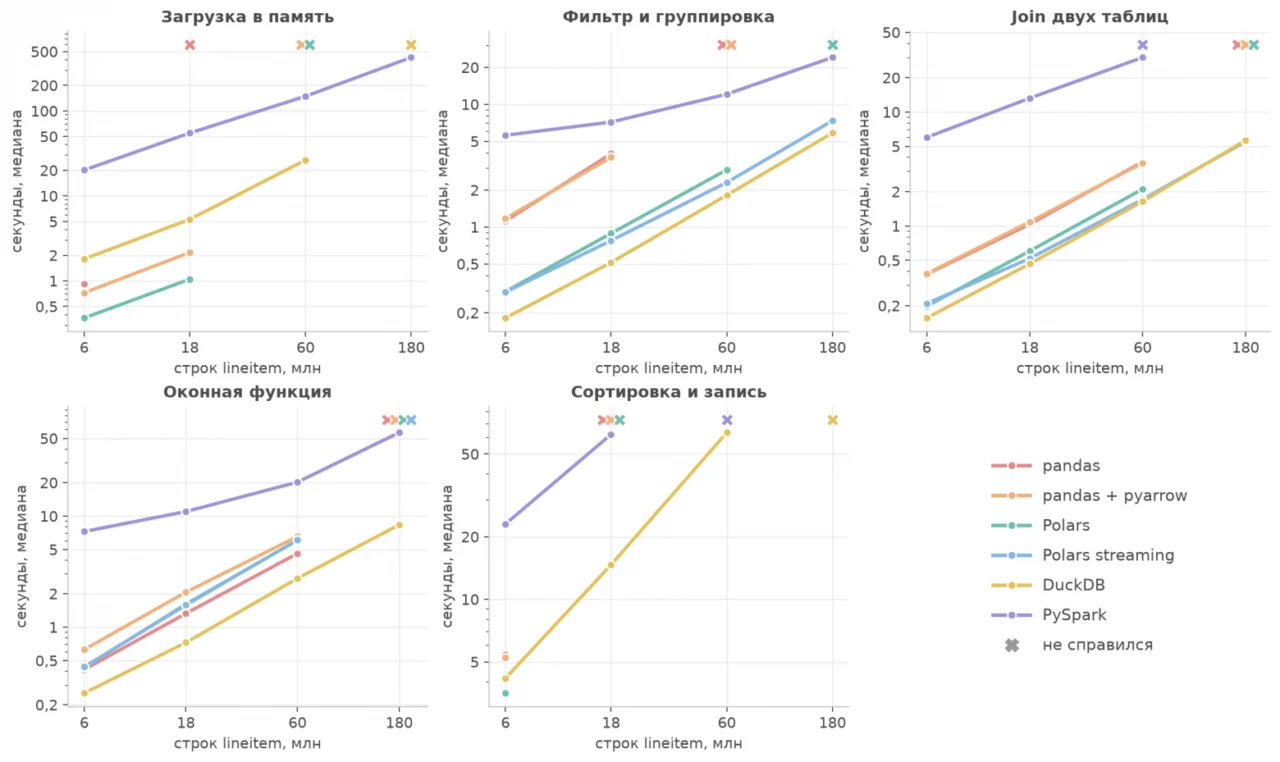
Обе оси графиков имеют логарифмический масштаб. Крестик на графиках обозначает объем, на котором библиотека исчерпала ресурсы.
На малых объемах тормозит исключительно Spark
На датасете в 6 млн строк все участники, за исключением PySpark, укладываются в секунды:
|
Операция |
pandas |
Polars |
DuckDB |
PySpark |
|---|---|---|---|---|
|
Импорт в память |
0,92 с |
0,37 с |
1,81 с |
20,14 с |
|
Фильтрация и агрегация |
1,12 с |
0,30 с |
0,18 с |
5,60 с |
|
Соединение таблиц |
0,38 с |
0,20 с |
0,16 с |
5,98 с |
|
Оконная функция |
0,41 с |
0,43 с |
0,25 с |
7,26 с |
|
Сортировка и экспорт |
5,43 с |
3,54 с |
4,17 с |
23,01 с |
Здесь Spark уступает pandas от 4 до 22 раз, и это без учета инициализации контекста. Дело вовсе не в изъянах Spark: он спроектирован для распределенных сред и трансформирует любой запрос в сложный граф этапов, оптимизированный для распараллеливания по кластеру. При работе с локальными микро-данными эти накладные расходы превосходят полезную работу.
Polars и DuckDB опережают pandas на группировке примерно в 4 и 6 раз соответственно. Разницу между секундой и долями секунды на десктопе заметить трудно, но по мере роста датасета этот разрыв становится критическим.
Пределы возможностей pandas
Начнем с неожиданной цифры. Таблица, занимающая на диске 149 МБ, после десериализации в pandas раздувается до 1,9 ГБ в оперативной памяти — почти в 13 раз. Формат Parquet хранит данные в сжатом колонковом виде, тогда как в памяти каждое поле разворачивается полностью. Отсюда закономерный итог: располагая 5 ГБ RAM, pandas захлебнулся на импорте уже при 18 млн строк, хотя на накопителе это меньше полугигабайта.
Дальше любопытнее. На отметке в 60 млн строк группировка в pandas рухнула, однако соединение и оконная функция на этом же объеме отработали успешно. Ключевой фактор — количество задействованных колонок: агрегации требуется шесть полей, джойну — три, а окну всего два. Загрузка исключительно необходимых столбцов через аргумент columns=[...] звучит банально, но на практике это самый дешевый способ оптимизации в pandas. Все тесты в бенчмарке написаны именно так.
Использование бэкенда pyarrow отодвинуло порог импорта с 18 до 60 млн строк и снизило общее потребление памяти. Тем не менее, на операциях группировки и сортировки он упал ровно там же, где и классический pandas.
Polars: стремительный, пока хватает ресурсов
Polars продемонстрировал абсолютное лидерство по скорости загрузки и сортировки, обогнав pandas во всех тестах, за исключением оконных функций (где idxmax в pandas держался наравне или чуть быстрее). Однако классический подход с вызовом collect() держит весь пайплайн в оперативной памяти. Из-за этого на 180 млн строк группировка и соединения в Polars завершились ошибкой.
Проблема решается одним параметром. Активация collect(engine="streaming") заставляет Polars дробить данные на чанки, благодаря чему группировка на 180 млн строк выполнилась за 7,35 с при скромных 2,3 ГБ RAM. Разница заметна уже на 60 млн строк: стандартный режим потребовал 4,2 ГБ, а потоковый — всего 1,2 ГБ.

Впрочем, потоковый движок не спас сортировку. Хотя сортировка в Polars и без того опирается на потоковый метод sink_parquet, она всё равно исчерпала лимит памяти на 18 млн строк.
DuckDB: абсолютный сюрприз
Я прогнозировал, что DuckDB займет позицию наравне с Polars. Реальность оказалась иной: СУБД справилась со всеми тестами, где хватало дискового пространства под временные файлы, и практически везде показала минимальное время выполнения. Группировка 180 млн строк заняла 5,84 с при потреблении RAM всего в 0,4 ГБ. Напомню, pandas на этой же задаче капитулировал на 60 млн строк.
Секрет прост: DuckDB не загружает датасет целиком в оперативную память. Он точечно вычитывает из Parquet нужные колонки и вычисляет агрегаты «на лету». От разработчика не требуется сложных манипуляций, достаточно стандартного SQL:
import duckdb
con = duckdb.connect()
con.execute("SET memory_limit="3.5GB"")
rows = con.execute("""
SELECT l_returnflag, l_linestatus,
sum(l_quantity), sum(l_extendedprice  (1 - l_discount)), count()
FROM read_parquet('lineitem.parquet')
WHERE l_shipdate <= DATE '1998-09-02'
GROUP BY ALL
""").fetchall()
Строка с конфигурацией memory_limit появилась в коде не сразу. В первом прогоне без этого параметра сортировка 60 млн строк завершилась с ошибкой out-of-memory. По умолчанию DuckDB резервирует 80% системной RAM и, по-видимому, некорректно оценил жесткие лимиты виртуальной машины. С явным ограничением СУБД начала выгружать излишки на диск и успешно отсортировала 60 млн строк за 63 секунды. На масштабе 180 млн строк для этого уже не хватило свободного места на диске.
Единственный сценарий, где DuckDB уступает — это первичный импорт в память: 1,81 с против 0,37 с у Polars на 6 млн строк. Логично, ведь при этом создаются внутренние структуры данных СУБД. Однако в реальных сценариях предварительная загрузка таблиц в память DuckDB избыточна, запросы исполняются напрямую над файлами.
PySpark: неторопливый, но несгибаемый
На одномашинной инсталляции Spark стабильно демонстрировал худшую скорость в каждой категории. На 180 млн строк группировка заняла 24,1 с (у DuckDB — 5,8 с), а оконная функция — 56,4 с против 8,3 с.
Зато отказоустойчивость Spark впечатляет. Закешировать 180 млн строк не удалось никому, кроме него, хотя на это ушло 426 секунд. Правда, понятие «загрузки» у систем различается: pandas и Polars формируют датафреймы в RAM, DuckDB создает табличное хранилище, а Spark строит кэш, при нехватке памяти частично вытесняемый на диск. Поэтому данный результат корректнее трактовать как «способность довести задачу до конца», а не как честную гонку производительности. Оконная обработка на 180 млн строк также завершилась успешно. Сбои у Spark произошли лишь на джойнах и сортировке при 60 млн строк, причем в двух запусках из трех джойн отрабатывал успешно, балансируя на грани.
Мой итоговый вывод таков: Spark незаменим, когда объем данных превышает емкость одной машины либо когда развернута готовая кластерная инфраструктура. Если же pandas просто начал «тормозить» на вашем лэптопе, Spark — далеко не оптимальный выбор, поскольку Polars и DuckDB решают аналогичные задачи значительно быстрее и проще.
Ниже приведено сопоставление с pandas в разрезе каждой операции. Для каждого инструмента взят максимальный объем, который pandas еще был в состоянии осилить.

Подводный камень первый: Spark потерял суточные данные
Уже во время первого прогона автоматическая сверка показала расхождение: группировка в PySpark выдала иную сумму по сравнению с остальными участниками. Расхождение составляло около 0.03%, невооруженным глазом заметить такое невозможно.
Корень проблемы крылся в фильтрации по дате. Я передавал классический объект datetime:
df.where(F.col("l_shipdate") <= F.lit(datetime(1998, 9, 2)))
PySpark интерпретирует подобные литералы с учетом часового пояса локального Python-процесса. В часовом поясе Москвы (UTC+3) граница смещалась на три часа назад, отсекая время на 21:00 первого сентября. Поскольку даты в Parquet хранятся без информации о таймзонах, все транзакции за 2 сентября выпали из выборки. На 6 млн строк это составило 1882 утерянные записи.
Решение тривиально: передавать дату строкой с последующим явным приведением типов к «таймстампу без зон» (timestamp_ntz).
Самое неприятное, что соединение (join) с аналогичным фильтром по датам отработало корректно. Там смещались обе границы диапазона, а данные квантованы с точностью до суток, поэтому результирующее множество строк случайно совпало. Без автоматической кросс-проверки эта ошибка могла бы незаметно перекочевать в продакшн.
Подводный камень второй: идентичный результат, 9-кратная разница в скорости
Оконную функцию вычисления «самой дорогой позиции в заказе» в pandas можно реализовать через дословный перенос SQL-логики:
place = df.groupby("l_orderkey")["l_extendedprice"].rank(method="first", ascending=False)
top = df[place == 1]
А можно лаконичнее:
top = df.loc[df.groupby("l_orderkey")["l_extendedprice"].idxmax()]
Результат совпадает вплоть до копеек. Время выполнения — нет. На датасете в 6 млн строк картина следующая:
|
Реализация |
Время |
|---|---|
|
pandas, |
2,11 с |
|
pandas, |
3,25 с |
|
pandas, |
0,24 с |
|
Polars, |
1,30 с |
|
Polars, |
0,80 с |
|
Polars, |
0,29 с |
В итоговый бенчмарк для pandas и Polars вошли наиболее быстрые варианты, иначе сравнение было бы некорректным. Вы можете перепроверить это скриптом scripts/window_variants.py.
Получается парадоксальный факт: внутри самого pandas разница между двумя способами написания кода выше, чем разница между pandas и DuckDB на этой же задаче. Следовательно, прежде чем менять технологический стек, стоит критически оценить эффективность текущего кода.
Подводный камень третий: pandas 3.0 задает новые правила
Долгое время стандартом индустрии был совет импортировать данные с флагом dtype_backend="pyarrow". Это позволяло хранить строки в формате Arrow вместо объектов Python, кратно ускоряя вычисления. Начиная с pandas 3.0, этот бэкенд стал дефолтным, из-за чего рекомендация отчасти утратила актуальность. Я сопоставил скорость загрузки 6 млн строк на двух версиях:
|
|
pandas 2.2.3 |
pandas 3.0.6 |
|---|---|---|
|
по умолчанию |
1,42 с |
0,89 с |
|
с |
0,73 с |
0,73 с |
В pandas 2 указанная опция удваивала скорость чтения, тогда как в pandas 3 прирост минимален. В предварительных тестах на старом ноутбуке под управлением Windows и pandas 2.1 ускорение достигало четырехкратных значений. Если вы до сих пор используете pandas 2, обновление или включение этой опции при чтении могут обеспечить существенный прирост производительности без рефакторинга кодовой базы. Соответствующий скрипт доступен в scripts/pandas_versions.py.
Что в итоге выбрать
Если объем информации укладывается в оперативную память (порядка пары гигабайт в RAM или сотен мегабайт в формате Parquet), возможностей pandas хватит с избытком. Загружайте исключительно нужные колонки и следите за качеством написания кода.
Если вам ближе декларативное мышление в терминах SQL, оптимальным выбором станет DuckDB. В моих тестах она продемонстрировала минимальное потребление RAM и абсолютное лидерство по скорости, а развернуть её можно локально, прямо поверх привычного окружения с pandas.
Тем, кто предпочитает привычный API датафреймов, отлично подойдет Polars. Главное — не забывать про аргумент engine="streaming" при обработке масштабных файлов.
Spark оправдан лишь тогда, когда датасет физически не помещается на одном компьютере, либо когда у вас уже развернута инфраструктурная экосистема. Вот там он находится на своем месте.
Отдельно подчеркну нюанс с памятью. Ошибка OOM в pandas при импорте — вовсе не повод спешно мигрировать на другой инструмент. В данном эксперименте таблица занимала в памяти в 13 раз больше места, чем на диске, и простейшим лекарством оказалось элементарное отсечение неиспользуемых столбцов.
<
Ограничения исследования
Тесты проводились на слабой конфигурации. На мощной рабочей станции абсолютные показатели изменятся, а пропорции между фреймворками могут скорректироваться. Больше всех от этого ограничения страдает Spark, изначально спроектированный для кластеров: здесь ему выделили всего два ядра. На многоядерном процессоре его отставание от DuckDB и Polars, вероятнее всего, сократится, поэтому выводы по Spark актуальны именно для бюджетного железа.
Облачная среда обладает естественным «шумом». В большинстве замеров разброс между итерациями не превышал 10% (медиана около 4%), но самые быстрые операции длительностью в доли секунды порой давали выбросы почти вдвое. По этой причине в отчет вошла медиана, а колебания в пределах 10–15% не стоит воспринимать как абсолютную истину. Сырые логи всех прогонов сохранены в results/results.csv.
Использовались синтетические данные. Структура приближена к TPC-H, однако это не официальный бенчмарк, и сопоставлять полученные цифры с эталонными результатами TPC-H некорректно. Ключи в генераторе распределены равномерно, тогда как реальные данные часто страдают перекосами (skew), когда на единичный ключ приходится львиная доля строк — в таких условиях операции вроде Join ведут себя иначе. Все файлы хранились в Parquet; парсинг CSV, на котором чаще всего спотыкаются новички, не тестировался. Пять типовых операций также не охватывают всего спектра реальных аналитических задач.
Как воспроизвести
Требуется Python версии 3.11 или выше, а для работы PySpark — Java 17 или 21. Дальнейшие шаги стандартны:
git clone https://github.com/Gregory-Bondarenko/tablebench
cd tablebench
./setup.sh                                 # для Windows: setup.bat
source .venv/bin/activate                  # для Windows: .venv\Scripts\activate
python run.py --scales 0.1 --repeats 1     # быстрый дымовой прогон (пара минут)
python run.py                              # полноценное тестирование
Утилита самостоятельно сгенерирует файлы, выполнит бенчмарк и сформирует подробный отчет results/REPORT.md с графиками и таблицами. Для выборочного запуска конкретных инструментов или операций предусмотрены флаги:
python run.py --scales 1 10 --engines polars duckdb --ops groupby join
Пользователям Windows для корректного экспорта данных из PySpark потребуется предварительно настроить winutils.exe и hadoop.dll — инструкция приложена в README.
Больше заметки про аналитику данных, инженерные практики и закулисье разработки я публикую в своем Telegram-канале ЛОГОВО.DATA, присоединяйтесь!
Похожие статьи
 Intel готовит новые процессоры Core 2000HX: старый добрый Raptor Lake в новой обёртке
 ИИ от Google позволяет создавать игры всего по одной идее
 Яндекс 360 проведёт Yandex Connect 22 октября в Москве и онлайн
 «Сферум» открыл платформу школьных олимпиад
 Роботы-пылесосы Xiaomi Robot Vacuum X20 Pro поступили в продажу в России: уборка с искусственным интеллектом
 Уникальный остаток сверхновой 1181 года в Млечном Пути запечатлен в виде «жемчужных нитей»
 JaCarta Management System 4LX для Linux подтвердила совместимость с Termidesk VDI
 В тесте Adversa AI Copilot CLI передал локальные файлы через инструкции на веб-странице