Какая секретная модель скрывается у OpenAI и как DeepSeek удается сокращать отрыв
Внутренние архитектуры ведущих ИИ-лабораторий закрыты от широкой общественности. Я скептически отношусь к конспирологическим теориям в духе «у OpenAI в закромах спрятан полноценный AGI, а пользователям скармливают урезанную версию ChatGPT». Модель, с которой работают штатные исследователи компании, и коммерческий продукт в API вовсе не обязаны совпадать. Передовые лаборатории разрабатывают не просто отдельную нейросеть, а целую конвейерную линию моделей: исследовательские чекпоинты > экспериментальные образцы > reward-модели > модели-наставники > генераторы синтетических данных > оценочные модули (evaluators) > дистиллированные аналоги > финальные production-версии. До конечного потребителя добирается лишь заключительное звено этой цепочки.
Зачем прибегают к дистилляции
Представьте, что вы создали колоссально дорогостоящую модель с выдающимися способностями к логике, программированию и математике, однако каждый вызов обходится в астрономические вычислительные ресурсы. Для внутреннего использования исследователями это оправданно, когда на кону стоят триллионные рынки. Но в условиях продукта с аудиторией в 100 миллионов пользователей масштабировать такой доступ экономически нецелесообразно. Поэтому вместо того чтобы задействовать тяжеловеса для каждого запроса, его превращают в наставника: он генерирует эталонные ответы, пути рассуждений, синтетические датасеты и распределения вероятностей. На основе этого массива данных обучается более компактная модель-студент. Ей не требуется в точности копировать учителя целиком — достаточно перенять ключевые компетенции. Это классический метод дистилляции знаний, ставший настолько рутинным, что та же OpenAI внедрила официальный рабочий процесс Model Distillation: разработчики могут брать выходы более мощных систем (вроде GPT-4o или o1-preview) и дообучать на них более бюджетные решения. Сама формулировка компании предельно точна — взять передовую разработку и добиться сопоставимого качества в узкой дисциплине при кратно меньших затратах. Отсюда вытекает очевидный вывод: флагманская исследовательская модель и флагманская рабочая модель оптимизируются по совершенно разным критериям. Первая нацелена на абсолютный максимум возможностей, тогда как вторую приходится одновременно балансировать по уровню интеллекта, задержке (latency), нагрузке на GPU, пропускной способности, надежности и безопасности.
За последние пару лет наглядных примеров подобного подхода накопилось множество. Корпорация Apple подробно описывала внутреннюю Mixture-of-Experts систему, задействованную при создании компактной базовой модели для локального запуска на устройствах. Google задействовала более мощную Gemini в качестве учителя для обучения EmbeddingGemma. Meta опиралась на логиты Llama 3.1 (на 8B и 70B) при проектировании миниатюрных версий Llama 3.2 (1B и 3B). Microsoft открыто заявляла, что ранние итерации семейства Phi во многом обязаны своими навыками дистилляции из GPT-4. В свою очередь, DeepSeek после релиза R1 представила целую экосистему дистиллированных вариаций — от 1.5B до 70B параметров. Связка «мощный учитель — экономичный студент» доказала свою состоятельность на практике и детально задокументирована.
Чего из этого не следует
Из вышесказанного порой делают ошибочный вывод, будто любая доступная пользователю нейросеть — это заведомо кастрированная модификация секретного супер-ИИ. Зачастую в роли учителя выступают вполне открытые решения: Meta задействовала общедоступные Llama 3.1, а DeepSeek выложила в открытый доступ как флагманскую R1, так и её дистиллированные производные. При этом в ряде случаев модель-студент превосходит учителя на конкретных бенчмарках или узких задачах благодаря специализированному посттренингу. Было бы опрометчиво утверждать, что весь открытый сегмент (open source) представляет собой искусственно ухудшенные копии закрытых разработок. Тем не менее, куда более скромное утверждение полностью справедливо: публичный каталог продуктов с высокой долей вероятности не отражает актуальный технологический предел конкретной лаборатории.
«Внутренняя модель OpenAI»
Начиная с 2026 года в математических академических изданиях стала регулярно фигурировать интригующая формулировка. 31 марта группа математиков опубликовала исследование с решением трех задач Эрдёша, где в аннотации прямо указано: «в каждом случае доказательство целиком получено внутренней моделью OpenAI». Это далеко не единичный эпизод: в феврале проприетарная система OpenAI выстроила принципиально новое решение проблемы Эрдёша — Нешетрила — Рёдля, в апреле вышла новая статья с пятью аналогичными доказательствами, а следом та обнаружила контрпример к гипотезе Эрдёша о единичных расстояниях (unit distances), державшейся около восьми десятилетий (корректность выкладок подтвердили независимые математики). В сопутствующих материалах отмечалось, что исходный математический результат был сформирован внутренней нейросетью за один проход, после чего исследователи лишь привели его к академическому виду при помощи Codex. Известный математик Т. Гауэрс признался, что если бы подобную работу прислал живой автор, он без колебаний рекомендовал бы её к печати в престижном журнале *Annals of Mathematics*. Мехтааб Сахни лаконично прокомментировал это в соцсетях: «решение найдено внутренней моделью OpenAI», а Кевин Вейл (на тот момент один из топ-менеджеров компании) репостнул запись, добавив, что искусственный интеллект справляется со всё большим числом открытых задач, а качество выкладок растет по мере эволюции архитектур. Таким образом, существование передовых моделей для внутреннего применения задолго до их коммерческого релиза — это уже не домыслы, а задокументированный научный факт.
Тем не менее, спустя несколько месяцев Ноам Браун из OpenAI изложил эту историю несколько иначе, чем принято в медиа: компания просто обучила свежую внутреннюю модель, чтобы оценить её потенциал. Контрпример отыскался при сравнительно скромных затратах на инференс, однако после огласки выяснилось, что аналогичный результат можно извлечь и из уже публичной GPT-5.5, если задействовать грамотный обвязочный каркас (scaffolding). Получается, что жесткой грани между «это умеет внутренняя разработка» и «это недоступно публичной версии» может не существовать вовсе. Потенциал изначально заложен в публичных весах, но остается латентным до тех пор, пока не подобраны правильный промпт, стратегия поиска, верификатор и вычислительный ресурс на этапе инференса. Как следствие, уровень «интеллекта» перестает быть неотъемлемым свойством исключительно весов — он превращается в комплексную характеристику связки из модели, фреймворка, вспомогательных инструментов, инференс-бюджета, верификаторов и методов посттренинга. Привычный же чат-интерфейс оказывается крайне несовершенным инструментом для оценки реального технологического фронтира.
Что насчет Astra
Появление Astra стало своего рода естественным экспериментом. Еще до официального анонса OpenAI активно применяла мощнейшие внутренние системы в исследовательских целях, а 3 сентября 2026 года презентовала GPT-6 Astra, назвав её наиболее универсальной и производительной массовой моделью: 98% на бенчмарке FrontierMath Tier 4 и, по заверениям разработчиков, реальный вклад в решение давних математических загадок. Вполне вероятно, что упомянутая в научных статьях внутренняя система и Astra принадлежат к одной технологической ветке. Впрочем, это лишь умозаключение по косвенным признакам: OpenAI не раскрывала происхождение тех чекпоинтов настолько подробно, чтобы можно было безошибочно протянуть нить к Astra. Равно как отсюда не следует обязательное наличие где-то в недрах компании системы на поколение опережающей Astra. Подобное развитие событий не исключено, но прямых доказательств пока нет.
Обратная сторона дистилляции, или феномен DeepSeek
Вы инвестируете миллиарды в вычислительные кластеры, научные кадры, алгоритмы обучения с подкреплением (RL), синтетические данные и оценочную инфраструктуру, а конкуренту для воспроизведения львиной доли результатов достаточно выкачать из вашего API несколько миллионов качественных ответов. Ему не нужны ваши веса и архитектурные секреты — он эксплуатирует вашу модель в качестве наставника, генерирует массивы заданий, собирает отклики, отфильтровывает наиболее перспективные траектории рассуждений, обучает собственную нейросеть, после чего привлекает вашу же разработку в роли беспристрастного судьи для нового цикла доработки. Экономика процесса искажается: вы финансируете рождение интеллекта, а соперник платит лишь за API-токены ради его беззастенчивого переноса.
Еще в 2025 году в OpenAI заявляли о фиксации попыток масштабной дистилляции её продуктов. В феврале 2026 года Anthropic обнародовала куда более детальную статистику: по данным компании, DeepSeek, Moonshot и MiniMax развернули против Claude промышленные кампании по перекачке знаний, задействовав свыше 24 000 мошеннических аккаунтов и более 16 миллионов транзакций. При этом объектом интереса становились не случайные реплики, а дорогостоящие кластеры компетенций: написание кода, логический анализ, работа с инструментами, агентные сценарии, оценивание и взаимодействие с компьютером. В официальном блоге Anthropic этот процесс охарактеризовали не как банальную кражу моделей (model stealing), а как экспроприацию знаний (knowledge extraction), поскольку копировать веса никто не обязан — достаточно перенять эффективную функциональную модель поведения.
В итоге складывается парадоксальная ситуация: передовые лаборатории сами постоянно практикуют дистилляцию, поскольку это оптимальный путь удешевления высоких технологий, и одновременно отчаянно защищаются от аналогичных посягательств извне. С технической точки зрения здесь нет лицемерия — ключевая разница заключается в правах на владение учителем и правомерности использования его ответов сторонними игроками. Тем не менее, на уровне технологий происходит ровно одно и то же: сильная нейросеть обеспечивает надзор (supervision), на базе которого прогрессирует следующая. Именно поэтому API перестал быть тривиальным продуктовым интерфейсом, превратившись в канал утечки ценных возможностей. Чем больше информации отдается наружу (сырые логиты, логика рассуждений, судейские оценки и миллионы запросов без ограничений), тем дешевле конкуренту обходится выращивание собственного «студента». Вполне логично, что жесткие лимиты запросов (rate limits), сокрытие цепочек мыслей (chain-of-thought), мониторинг скоординированных учетных записей и запреты на обучение конкурентных систем в пользовательских соглашениях обретают сугубо экономическое обоснование. Как отмечал в текущем году Клеман Деланг (глава Hugging Face), его не удивит сценарий, при котором ведущие разработчики начнут еще сильнее ограничивать доступ к API, перенаправляя дефицитные мощности на собственные нужды.
Какие выводы из этого можно сделать
Мы привыкли воспринимать вывески вроде GPT, Claude, Gemini или Llama как изолированные законченные продукты: раз компания обучила GPT-6, значит, именно она и олицетворяет её совокупный интеллект. Подобное представление всё дальше отстоит от реальности. Сегодня лаборатория напоминает скорее непрерывный конвейер по генерации когнитивных способностей: масштабные циклы обучения > промежуточные чекпоинты > алгоритмы RL > синтетические данные > модели-наставники > критики > верификаторы > дистилляция > вспомогательный инструментарий > вычислительные мощности на инференсе > развертывание в продакшене. При этом привычное пользователю имя модели — лишь одна фиксированная точка на конвейере, выбранная исходя из баланса рисков и издержек.
Следовательно, постановка вопроса в духе «какая модель сегодня самая умная?» теряет практический смысл. Гораздо продуктивнее интересоваться иным: каков максимум возможностей уже скрыт внутри стен лаборатории, какая их часть законсервирована в исследовательских чекпоинтах, что именно уже заложено в публичные веса в ожидании правильной обвязки, и какая доля была дешево перенесена в продакшн через дистилляцию. И главное — насколько далеко реальный технологический фронтир оторвался от того, что видит рядовой пользователь в окне чат-бота. Публичные лидерборды давно перестали служить адекватным мерилом истинного потенциала искусственного интеллекта.
Больше полезного контента в моем тг‑канале: t.me/airamongush
Похожие статьи
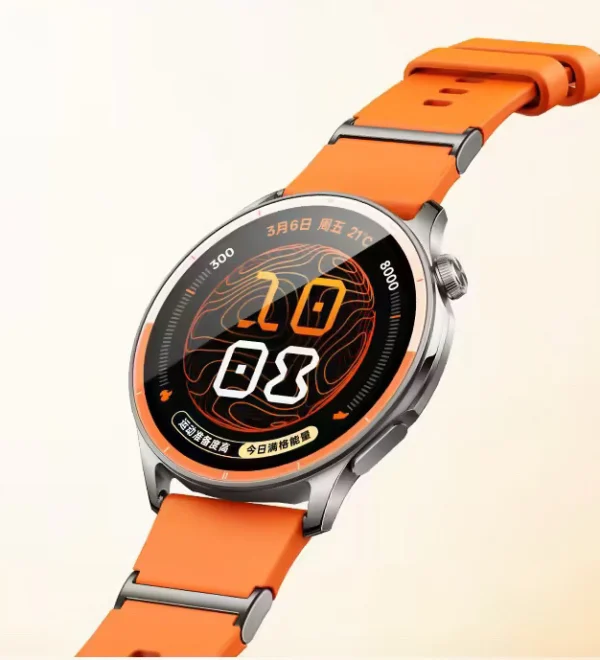 Анонсированы Oppo Watch S2: тонкие умные часы с ЭКГ, измерением температуры и 10 днями автономности
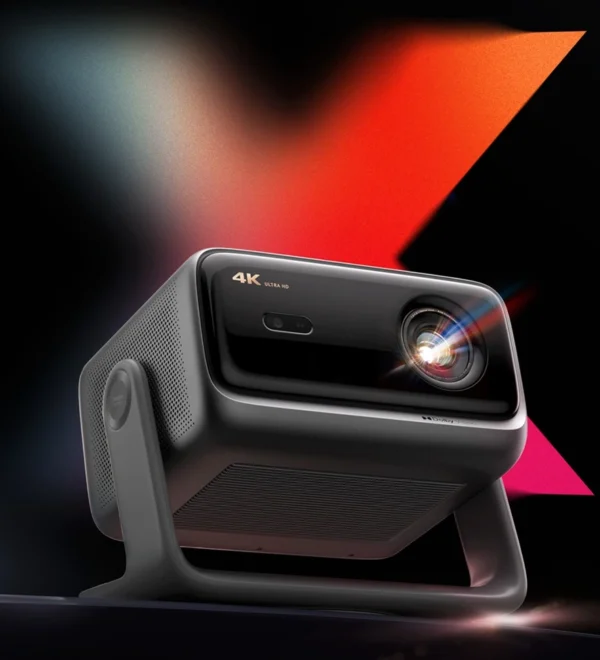 Анонсирован флагманский 4K-проектор Dangbei X9 Max с лазером QuaLas42 и яркостью 5000 ISO люмен
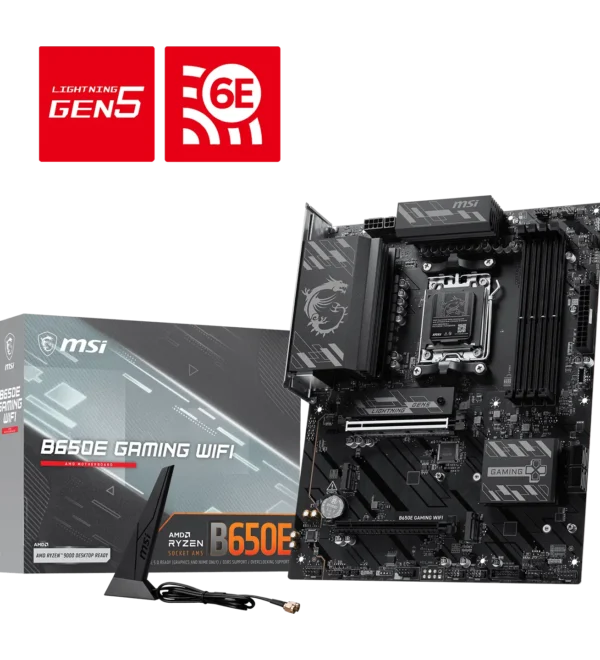 MSI представила первую материнскую плату на чипсете AMD B650E спустя четыре года после его анонса
 Видеокарты GeForce RTX 5090 стремительно исчезают из продажи, а их начальные цены в США подскочили до $6500
 Aoostar анонсировала компактный ПК NEX495S с поддержкой до 192 ГБ оперативной памяти
 Главная уязвимость российской микроэлектроники: 84% материалов свои, но 90% из них производятся на зарубежном сырье
 У 16-контактного разъема питания GeForce RTX 5090 проплавилась дыра
 Эволюция советского кодинга: от «Агата» до «Микроши». Часть 1