Как я обошел еще одно ограничение NVIDIA: первый в мире запуск P2P на CMP90HX с помощью инженеров компании
В предыдущих публикациях я изрядно помучал NVIDIA CMP 90HX. Сперва выяснилось, что под маской майнингового ускорителя скрывается полноценный чип GA102, которому просто программно запретили заниматься чем-либо, кроме добычи криптовалюты. Затем оказалось, что вендор принудительно заблокировал и линии PCIe, хотя сам кристалл прекрасно поддерживает полноценную шину. После серии манипуляций с паяльником, дампом регистров и нестандартными методами работы с аппаратной частью сервер стал выглядеть куда интереснее в сравнении с базовой версией.
Однако оставался один нерешенный нюанс — графические адаптеры по-прежнему не умели напрямую обмениваться информацией друг с другом. Для моего сценария это стало серьезным препятствием, поскольку сервер собирался ради инференса масштабных языковых моделей на связке из недорогих GPU. Каждая из пяти карт отлично справлялась со своими вычислениями по отдельности, но стоило им попытаться передать данные соседу, как пакеты отправлялись в долгое путешествие через весь узел.
В итоге я задался вопросом: можно ли активировать на CMP 90HX полноценный режим P2P? И у меня получилось — впервые запустить прямой обмен между этими ускорителями, заставив одну карту обращаться к памяти другой на адекватной скорости.
Самое забавное, что на этом пути мне неоценимо помогли инженеры NVIDIA. Разумеется, не лично, а через механизмы, оставленные в драйвере для внутренних нужд разработки и отладки.
Мне оставалось лишь разобраться, как эта кухня функционирует.
Спойлер: слово «лишь» здесь катастрофически уменьшает масштаб пережитых трудностей.
Зачем мне вообще понадобился P2P
Сделаю краткое отступление для тех, кто не следил за предыдущими частями. Если модель не помещается в видеопамять одного ускорителя, её приходится разделять между несколькими GPU. В llama.cpp это реализовано по-разному. При разбиении по слоям (layer split) части модели распределяются последовательно: один GPU просчитывает свои слои и передает эстафету следующему.
Альтернативный сценарий — tensor split. Здесь единая тяжелая математическая операция распараллеливается на несколько видеокарт одновременно. Они синхронно считают фрагменты матриц, после чего обязаны обменяться промежуточными массивами. И чем мощнее сами чипы, тем острее встает проблема простоя: вычисления давно завершены, а GPU сидят в ожидании входящего трафика.
Без прямого доступа путь между двумя картами в моей конфигурации выглядел следующим образом:
Сначала блок вычитывается из VRAM первого ускорителя, через его контроллер и линии PCIe следует в корневой комплекс ЦП, а затем через системный контроллер памяти записывается в обычную RAM. После этого стартует второй этап — тот же массив снова забирается из системной памяти, повторно преодолевает процессорный узел, катится по шине и наконец попадает в видеопамять второй карты.
То есть вместо одной транзакции фактически совершается две:
GPU 0 -> RAM
и далее:
RAM -> GPU 1
Системная ОЗУ работает как транзитный склад, куда я сначала полностью выгружаю багаж, чтобы тут же забрать его обратно и везти на соседний объект.
В моих бенчмарках этот круговой маршрут выдавал эффективную пропускную способность на уровне:
STAGED_E2E_EFFECTIVE_GBPS ... 1.60То есть около 1,60 ГБ/с.
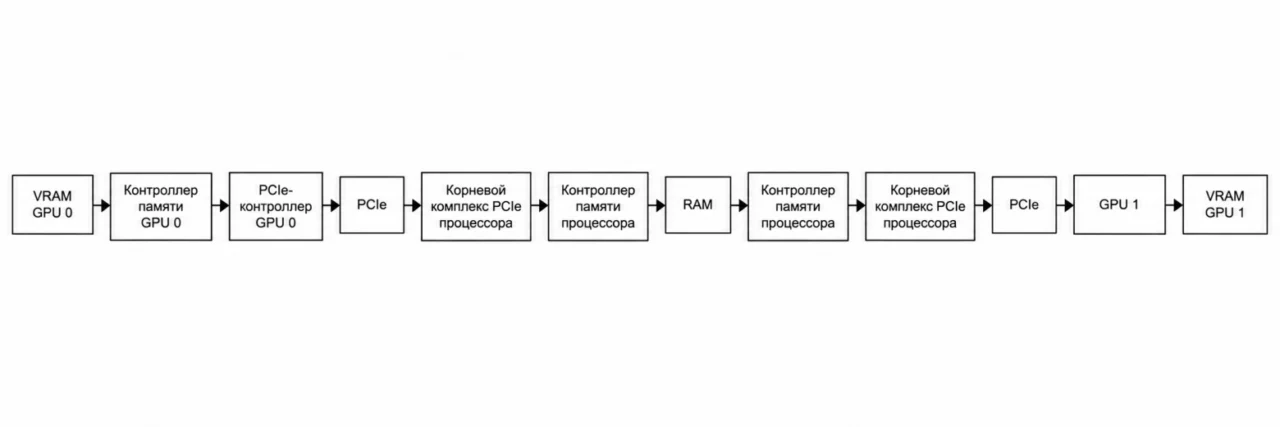
При организации настоящего прямого обмена между картами в пределах одного процессорного сокета путь должен быть значительно короче:
VRAM GPU 0 -> PCIe-контроллер GPU 0 -> PCIe -> корневой комплекс процессора -> PCIe -> GPU 1 -> VRAM GPU 1

Поскольку мои видеокарты не объединены выделенными шлейфами вроде NVLink, инфраструктура PCIe никуда не денется — на этом железе иначе обойтись нельзя. Однако из цепочки полностью исключаются лишние операции записи и чтения.
Такое прямое межсетевое взаимодействие устройств называют P2P (peer-to-peer). Один графический процессор обретает способность напрямую достучаться до памяти соседа, минуя системную ОЗУ в качестве перевалочной базы.
Официальный драйвер NVIDIA для CMP 90HX категорически заявлял, что это невозможно, но после прошлых экспериментов слово «нельзя» я стал воспринимать лишь как любопытную гипотезу, требующую практической проверки.
Для начала опросим сам драйвер
Для начала я изучил, как именно драйвер NVIDIA видит топологию моих пяти ускорителей:
Две CMP базируются на первом процессоре — 02:00.0 и 03:00.0. Еще три — 81:00.0, 82:00.0 и 83:00.0 — висят на втором.
Упрощенная схема выглядит так:

Устройства в рамках одного процессорного узла замыкались через общий корневой мост PCIe (обозначение PHB). Между картами из разных сокетов значился узел NODE, означающий, что трафику придется курсировать через межпроцессорный интерконнект — к этому мы еще вернемся.
Для пар внутри одного PCIe-сегмента утилиты выдавали статус GNS (GPU not supported), для некоторых других комбинаций — TNS (Topology not supported), а для прочих опций и вовсе лаконичное NS. Общий вердикт был однозначен: прямой обмен заблокирован программно.
При этом физически аппаратная база выглядела подозрительно готовой к таким нагрузкам. Мы имеем дело со всё тем же чипом GA102, который в потребительской и профессиональной линейках (речь об аналогах из серии RTX) без проблем справляется с P2P.
Отсюда логичный вопрос: какой именно элемент драйвера устанавливает этот барьер и можно ли заставить его следовать сценарию, заложенному для карт серий RTX и Tesla?
Как видеокарта видит чужую память?
Чтобы избежать иллюзии из серии «просто исправил строчку в коде — и всё заработало», стоит вкратце погрузиться в архитектуру доступа к памяти периферийных устройств PCIe.
В адресном пространстве ПК PCIe-девайсам выделяются специализированные окна, через которые центральный процессор и прочие компоненты могут взаимодействовать с их ресурсами. Базовые адреса этих зон определяются регистрами BAR (Base Address Register).
Для графических чипов NVIDIA ключевое значение имеет область BAR1. Если не вдаваться в дебри, именно через неё фрагмент локальной видеопамяти проецируется во внешнюю систему как линейный диапазон адресов. Запрос поступает на конкретную точку этого пула, после чего видеокарта транслирует его в свой внутренний банк памяти.
В случае с моими CMP размер доступного региона BAR1 составлял 16 384 МиБ.
То есть речь шла не о крошечном окне в пару сотен мегабайт — адресное пространство позволяло смаппить всю видеопамять целиком.
Однако одного лишь BAR1 недостаточно. Допустим, первый GPU сформировал буфер в своей памяти. Чтобы второй ускоритель мог с ним взаимодействовать, драйвер обязан построить для него проекцию этого участка. В результате определенный адрес в пространстве второго GPU будет перенаправляться не в его локальную VRAM, а через шину PCIe к памяти соседа.
Сама видеокарта оперирует виртуальными адресами. Для их конвертации в реальные ячейки служит внутренний модуль управления памяти — GMMU (GPU Memory Management Unit). Он опирается на таблицы страниц, где прописано соответствие виртуальных адресов и характеристики конкретных областей.
При штатной работе записи в таблицах ссылаются на локальную память. Для P2P драйвер должен сгенерировать дескрипторы, описывающие память соседнего устройства и правила доступа к ней по шине.
Выстраивается следующая цепочка: драйвер проверяет совместимость GPU, отбирает разрешенные команды (чтение, запись, атомарные функции), создает удаленное отображение, настраивает окно BAR1, формирует записи в таблицах GMMU — и лишь после этого CUDA выдает рабочий адрес.
Снова погружаемся в исходники драйвера NVIDIA
К счастью, бóльшую часть исходного кода открытых модулей ядра NVIDIA для Linux сегодня можно изучать изучить напрямую. Правда, это вовсе не значит, что вся логика управления чипом лежит на поверхности.
В современных архитектурах часть критически важных рутин исполняется отдельным микроконтроллером внутри самого GPU — GSP (GPU System Processor). Открытый модуль ядра выступает лишь посредником, запрашивая у него актуальные сведения о состоянии и возможностях ускорителя.
Я начал с кодовой базы, отвечающей за межсистемный обмен, логику шины, удаленный маппинг памяти и генерацию таблиц страниц:
nv-p2p.c
kern_bus_gm107.c
kern_bus_gp100.c
nv_gpu_ops.c
gmmu_fmt.c
Пришлось проследить весь путь целиком: от валидации возможностей соседа до момента, когда его память физически мапится в адресное пространство смежного GPU.
И здесь сделаем небольшое отступление. По мере анализа мне стали попадаться любопытные внутренние флаги:
PeerMappingOverride
RMForceP2PType
ForceP2P
RMDisableFeatureDisablement
Перечисляю их заранее. На том этапе я еще не понимал до конца зоны ответственности каждого параметра, их реальную роль в цепочке и необходимую комбинацию.
Но сами их наименования интриговали.
Особенно выделялся этот:
RMDisableFeatureDisablementЕсли переводить дословно — «отключить отключение функционала».
Судя по всему, в определенный момент разработчики NVIDIA настолько устали от нагромождения искусственных ограничений, что добавили мастер-переключатель, вырубающий сам механизм блокировок, и разработчиков вполне можно понять.
Первая гипотеза: хватит ли одного ForceP2P?
Первым по-настоящему перспективным рычагом выглядел параметр ForceP2P.
Он представляет собой битовую маску, где каждый бит отвечает за принудительную активацию конкретных режимов прямого доступа.
В изученной кодовой базе значение:
0x11принудительно открывало базовые операции чтения и записи.
А расширенный вариант:
0x111активировал дополнительные возможности, включая атомарные транзакции.
Атомарные операции выполняются как неделимые транзакции с памятью. Они незаменимы, когда несколько вычислительных потоков параллельно работают с общими данными, гарантируя корректное изменение переменных без гонки потоков.
На этом моменте безумно хотелось поверить в красивую сказку: инженеры NVIDIA оставили потаенный тумблер, я прописывалю 0x111, пересобираю драйвер — и триумфально завершаю материал.
Разумеется, чуда не произошло.
Я пересобрал модифицированные NVIDIA Open Kernel Modules версии 610.43.03, задействовав найденный флаг принудительного P2P для идентификаторов CMP90HX.
Драйвер компилировался без ошибок, модуль успешно подгружался в систему, все пять карт определялись корректно. Система не падала в синий экран и не ругалась в логах.
Тестирую P2P — не функционирует.
Разумеется…
Версия вторая: дело в GSP?
Дальнейший реверс-инжиниринг показал, что открытая часть драйвера не принимает решения единолично. Значительная доля телеметрии о возможностях GPU поступает от закрытого микроконтроллера GSP.
Для каждой отдельной пары видеокарт в памяти существуют структуры, описывающие доступные варианты взаимодействия. В частности, там жестко прописаны статусы прямых чтений и записей по PCIe. Для CMP 90HX штатно возвращался вердикт:
NOT_SUPPORTEDРодилась логичная догадка:
Допустим, я снимаю блокировки в ядре ОС. Но затем драйвер опрашивает GSP, получает от него актуальный статус карты, где черным по белому написано NOT_SUPPORTED, и послушно сворачивает лавочку. Сколько ни правь софтверный верхний уровень, закрытая прошивка заблокирует всё обратно.
Следовательно, нужно перехватить ответ от GSP в момент опроса характеристик и подменить результат на лету.
Я начал изучать структуры вроде peerGpuCaps, поля pcieP2PReadCaps, pcieP2PWriteCaps и все точки их дальнейшего использования. Логика казалась безупречной: GSP говорит «нельзя», а я поверх отвечаю «можно».
Но именно в этот момент до меня дошло, что я пытаюсь изобрести велосипед, который инженеры NVIDIA уже смастерили до меня.
Помощь от разработчиков NVIDIA
Те самые внутренние параметры, о которых я обмолвился ранее, начали складываться в целостную картину.
Инструменты вроде ForceP2P, RMForceP2PType, PeerMappingOverride и сопутствующие проверки действительно дают драйверу возможность переопределять зашитые ограничения.
Иными словами, микрокод GSP может рапортовать:
NOT_SUPPORTEDпоскольку конкретная модель CMP 90HX занесена в реестр как не поддерживающая P2P.
Но следом в коде драйвера срабатывает заложенный разработчиками предохранитель, который при активации принудительного режима отменяет этот запрет.
Создавая драйвер, инженеры неизбежно сталкивались с необходимостью тестировать нестандартные комбинации железа, обходить искусственные барьеры и валидировать код вне зависимости от строгих таблиц совместимости. Для этого они и оставили себе подобные лазейки.
Но одного разрешения P2P всё равно мало
Даже если драйвер перестал сопротивляться, это вовсе не значит, что память одного ускорителя мгновенно стала доступна соседнему. Мы преодолели лишь первый рубеж.
Следом за валидацией возможностей драйвер обязан реально создать удаленное отображение: выделенный пул VRAM на одной карте должен быть спроецирован в адресную сетку другой. Для этого штатные алгоритмы должны выбрать корректный протокол доступа, подготовить окно BAR1, инициализировать служебные структуры и сформировать дескрипторы GMMU. Становилось очевидно: существует огромная пропасть между «драйвер не против P2P» и «видеокарта реально получила указатель на чужую память».
Опыт работы с обычными GA102
На этом этапе неоценимую услугу оказали более ранние наработки по активации P2P на обычных потребительских картах семейств RTX 3080 и RTX 3090.
Архитектура идентична, поэтому по уже изученным паттернам можно было восстановить последовательность вызовов, которые NVIDIA задействует после успешного прохождения проверок.
Готовых патчей под CMP 90HX там, разумеется, не содержалось — версии драйверов разнятся, часть логики уехала в прошивку GSP, а идентификаторы оборудования отличаются.
Однако это сузило зону поисков. Вместо исследования всего драйвера целиком задача свелась к анализу нескольких ключевых и крайне запутанных функций.
Урок терпения
Дальше начался этап, который в голливудском кино уместился бы в минутный ролик под бодрый саундтрек. В реальности это вылилось в бесконечные часы компиляции модуля nvidia.ko и анализ логов.
Цикл повторялся до тошноты: правка кода, сборка модуля, загрузка в ядро, опрос устройств, запуск тестов, получение очередного сбоя и возврат к исходникам.
Для верификации использовался специализированный CUDA-тест, пересылавший данные из памяти одного GPU в другой с одновременным замером скорости.
В одних сборках среда CUDA упорно отказывалась инициировать прямой трансфер. В других — проверки проходили успешно, но чужая память оставалась недоступной.
Временами казалось, что драйвер полностью покорен, но тестовый утилит придерживался противоположного мнения.
Постепенно сформировалось четкое понимание двухэтапной природы проблемы. Сначала нужно принудительно разрешить P2P через внутренние ключи драйвера, а затем обеспечить выполнение штатной процедуры маппинга удаленной памяти.
Момент капитуляции
В какой-то момент мне показалось, что без глубокого вмешательства в закрытый код GSP здесь не обойтись.
К тому моменту вычислительные блоки CMP были разблокированы, шина PCIe мучилась нещадно, а функция P2P уже несколько дней подряд отвечала мне отказами в самых разных вариациях.
В комментариях под прошлой статьей как раз интересовались судьбой прямого обмена.
Я честно ответил, что проект, судя по всему, зашел в тупик.

Закрыв вкладку с обсуждением, я машинально продолжил ковырять исходники.
И тут штатный алгоритм отработал до конца
Прорыв случился, когда драйвер впервые успешно довел до конца инициализацию служебной зоны, необходимой для межсетевого взаимодействия.
В кодовой базе NVIDIA этот компонент именуется mailbox («почтовый ящик»). Это штатный инструмент межмодульной коммуникации.
В системном логе мелькнула заветная строка — маркер, который я закладывал для отладки:
CMP90HX_TRACE_GP100_CREATE_MAILBOX
attributes=0x1
А следом произошло главное: среда выполнения CUDA наконец активировала доступ к памяти соседа.
Проверочный скрипт отрапортовал:
can_access = 1После этого кастомное CUDA-ядро смогло прочесть удаленный буфер, причем контрольная сумма совпала с эталонной. Это был настоящий P2P.
Оставалось оценить пропускную способность.
250 МБ/с. Превосходный результат
Сразу оговорлюсь: все замеры на данном этапе выполнялись при работе шины в режиме PCIe Gen1.
Причина крылась не только в стремлении изолировать переменные. Моя текущая процедура разблокировки PCIe — процесс, мягко говоря, небыстрый. Полный цикл реинициализации пяти карт отнимает минут 20–30, причем каждая проходит от 1 до 26 циклов перезапуска связки.
Поскольку это единственный стабильный метод заставить CMP работать на повышенных скоростях, переключение шины между Gen1 и Gen2 после каждой гипотезы заставило бы меня состариться раньше написания этой статьи. На этапе отладки я сознательно оставил PCIe в режиме Gen1.
Тем не менее, даже на Gen1 x16 я рассчитывал увидеть скорости хотя бы в пределах гигабайт в секунду.
Реальность оказалась скромнее:
0,24-0,26 ГБ/сТо есть около 250 МБ/с.
Прямой обмен между GPU, ради которого я убил несколько дней на реверс драйвера, работал в разы медленнее банальной пересылки через системную оперативную память.
Для контраста напомню показатель классического транзитного маршрута через RAM:
STAGED_E2E_EFFECTIVE_GBPS ... 1.60Промежуточное копирование через системную ОЗУ оказалось примерно в шесть раз быстрее новоявленного P2P.
Технически это был триумф. Эмоционально же возникало непреодолимое желание захлопнуть ноутбук и выбросить его в окно.
Аномальные 250 МБ/с как ключ к разгадке
Странные цифры неожиданно сузили круг подозреваемых.
До появления рабочего обмена под подозрение попадало абсолютно всё: от битов в конфигурации драйвера до дефектов дорожек на текстолите. Теперь львиная доля вариантов отпала.
Удаленные адреса резонируют корректно. CUDA-ядро вычитывает данные напрямую. Процедура маппинга завершается штатно.
Вопрос трансформировался: не «почему P2P не заводится», а «почему функционирующий P2P ползет со скоростью 0,25 ГБ/с».
Ищем дальше. Подозреваемый номер один — ACS
В спецификациях PCI Express предусмотрен механизм, регулирующий допустимость прямых коммуникаций между периферийными устройствами минуя транзитные мосты.
Речь идет об ACS (Access Control Services).
Технология создавалась для изоляции компонентов и особенно критична в средах виртуализации. Два контроллера могут физически висеть на одном ответвлении дерева PCIe, но ACS принудительно завернет их трафик через корневой порт.
С точки зрения безопасности — безупречно. Для P2P — смертельно.
В конфигурации ACS за перенаправление запросов отвечают флаги ReqRedir и CmpltRedir. Если они активны, пакеты путешествуют длинным обходным путем вместо оптимального внутрисистемного маршрута. А 250 МБ/с подозрительно смахивали на результат именно такого изнурительного вояжа пакетов по дорожкам материнской платы.
Инспектирую текущие регистры ACS на нужных корневых портах 00:02.0 и 00:03.0. Значение равнялось 001d, то есть редирект был активен.
Принудительно сбрасываю перенаправление:
0000:00:02.0 ACSCtl old=001d new=0011
0000:00:03.0 ACSCtl old=001d new=0011
Проверяю статус флагов:
ReqRedir-
CmpltRedir-
Казалось бы, виновник пойман! Теория стройна, параметры изменены, изменения зафиксированы.
Запускаю бенчмарк:
STAGED_E2E_EFFECTIVE_GBPS ... 1.60
P2P_BATCHED_GBPS ........... 0.24
Цифры не изменились ни на йоту.
Технология ACS торжественно реабилитирована. Правда, от этого осознания легче не стало.
А настоящий ли это P2P?
Закралось подозрение: а вдруг драйвер настолько уверовал в легитимность P2P, что отчитывается об успехе, тогда как сама среда CUDA тихонько перенаправляет трафик через системную ОЗУ?
Доверять стандартной функции cudaMemcpyPeerAsync я больше не мог.
Я разделил тесты: прогнал стандартные рутины копирования CUDA и параллельно задействовал кастомное ядро, которое самостоятельно выбирало целевой адрес и сбрасывало результат в локальный буфер.
Если бы какая-то из подсистем скрытно гоняла трафик через RAM, оба метода продемонстрировали бы разную динамику.
Однако оба варианта упорно выдавали те же злосчастные 0,24–0,26 ГБ/с.
Более того, в логах стабильно фиксировалась отработка штатного механизма инициализации:
CMP90HX_TRACE_GP100_CREATE_MAILBOX
attributes=0x1
Следовательно, P2P функционировал на аппаратном уровне. Просто работал чудовищно медленно.
Заглянем в таблицы виртуальной памяти GPU
Следующей гипотезой стала проверка дескрипторов удаленной памяти в таблицах страниц GMMU.
Именно эти структуры определяют вектор обработки запросов к виртуальным адресам и определяют атрибуты работы с целевыми диапазонами.

Теоретически можно было допустить сценарий, при котором адрес генерируется верно, но удаленная память описана с деструктивными атрибутами, из-за чего каждое обращение натыкается на софтверные задержки.
Но здесь вновь упирался в упрямый факт: система вела себя слишком корректно.
Буферы верифицировались, исключения доступа отсутствовали, драйвер не падал в панику, а пропускная способность была стабильно низкой, а не плавающей. Хуже подобных неисправностей не бывает.
Когда элемент просто не работает — ты хотя бы видишь причину. Когда всё функционирует правильно, но со скоростью старой флешки — приходится напрягать извилины.
Очевидные подозреваемые исчерпаны
К этому моменту я перепробовал, кажется, всё доступное.
Каждая тупиковая ветка одновременно раздражала и отсекала лишнее.
Теперь я располагал точными данными: P2P функционирует, чужая память считывается напрямую, целостность байтов соблюдена, размер окна BAR1 достаточен, а отключение редиректа ACS ничего не меняет. Логично было сместить фокус с самих видеокарт на инфраструктуру трансляции адресов со стороны центрального процессора.
Я забыл про IOMMU
В современных архитектурах PCIe-устройства не обязаны оперировать физическими адресами напрямую.
Между девайсом и остальной системой может функционировать отдельный аппаратный блок, выполняющий трансляцию адресов и параллельно изолирующий периферию друг от друга.
Это IOMMU (Input-Output Memory Management Unit).
Концептуально он дублирует классический блок управления виртуальной памятью (MMU) центрального процессора. Софт обращается по одному адресу, а аппаратура преобразует его в другой. Только IOMMU проделывает этот фокус с устройствами ввода-вывода — в том числе с графическими адаптерами.
Технология критически важна для виртуализации, безопасного проброса PCIe-устройств и защиты памяти от несанкционированных атак со стороны железа.
Словом, вещь выдающаяся. Особенно до тех пор, пока вы не пытаетесь заставить пару майнинговых ускорителей напрямую ковыряться в памяти друг друга.
Проверяю активный режим:
iommu: Default domain type: TranslatedСтатус Translated означает, что все запросы устройств проходят через полноценный этап трансляции адресов силами IOMMU. Подозрение пало именно на этот узел — других вариантов попросту не осталось.
Переключаем режим IOMMU
Вместо полного отключения подсистемы я решил перевести конкретные группы PCIe-устройств, к которым подключены CMP, в режим прямого проецирования адресов.
Меняю тип домена для целевых групп на identity.
В данном режиме транзитные адреса минуют классические таблицы преобразования IOMMU — входящий адрес жестко привязывается к исходящему.
Прогоняю тест на той же паре ускорителей.
До внесения правок:
0,24-0,26 ГБ/сПосле:
KERNEL_DST_EXEC_READ_PEER_WRITE_LOCAL ... gbps=3.080
KERNEL_SRC_EXEC_READ_LOCAL_WRITE_PEER ... gbps=3.350
Сперва я даже не поверил глазам.
Перепроверяю через другую утилиту:
P2P_BATCHED_GBPS ... 3.08
P2P_BATCHED_GBPS ... 3.35
Для сравнения, старый метод пересылки через системную оперативку:
STAGED_E2E_EFFECTIVE_GBPS ... 1.60Вот теперь картина выглядела именно так, как подобает настоящему P2P.
А что с межсокетными коммуникациями?
У карт, закрепленных за одним процессорным сокетом, P2P функционирует безупречно — 3,08–3,35 ГБ/с на шине Gen1 против скромных 1,60 ГБ/с через транзитную RAM.
Но мой сервер построен на двухпроцессорной архитектуре. Часть ускорителей привязана к первому Xeon, остальные — ко второму. При обмене данными между такими картами трафик вынужден пересекать межсокетный интерконнект, что неизбежно отражается на производительности.
Поэтому задействовать P2P с одинаковой эффективности между всеми пятью картами в моей системе не выйдет. Узким горлышком становится сама двухсокетная топология материнской платы, и здесь софтворно проблему не решить.
Переходим к Gen2
На этом этапе эксперименты с Gen1 можно было считать завершенными. Технология заработала, а природа аномальных 250 МБ/с была раскрыта.
Появился смысл потратить время на тестирование в режиме Gen2.
Как упоминалось ранее, мой алгоритм переключения всех CMP в Gen2 не сводится к смене одной переменной. Полный цикл реинициализации занимает около получаса. Проводить его после каждой гипотезы означало бы состариться раньше составления финальной таблицы.
Но теперь я менял лишь один параметр — пропускную способность самой физической шины.
Gen1 функционирует на скорости 2.5 GT/s на линию. Gen2 удваивает этот показатель до 5 GT/s.
После завершения процедуры разблокировки обе карты зафиксировали скорость 5.0 GT/s при ширине интерфейса x16.
Тестирую ту же связку из 02:00.0 и 03:00.0.
Результат:
0000:02:00.0 -> 0000:03:00.0 : 6.70 GB/s
0000:03:00.0 -> 0000:02:00.0 : 6.70 GB/s
Симметричные 6,70 ГБ/с в обе стороны.
Двукратное ускорение физического интерфейса практически линейно удвоило пропускную способность P2P. Пожалуй, это лучший итоговый контрольный тест: после череды хаков и патчей железо ведет себя предсказуемо и стабильно.
Послесловие: вопреки собственным прогнозам
Тот скептический комментарий я стирать не стану.
Я затевал эту авантюру с дешевыми майнинговыми ускорителями ради наращения доступного объема VRAM. По ходу дела выяснилось, что за вывеской CMP скрывается куда больший потенциал, чем разработчики из NVIDIA планировали оставить пользователям.
Функционал активации P2P я в итоге интегрировал в свою утилиту CMP90HX PWNER. Теперь вместо ручного применения патчей, редактирования параметров драйвера и многоэтапных проверок можно задействовать готовый профиль, который автоматизирует подготовку карт к прямому обмену. Очередной эксперимент, начинавшийся с ковыряния исходников ядра, закономерно превратился в штатную опцию скрипта.
https://github.com/iatethelogs/cmp90hx_pwner
И теперь мне чертовски интересно: кто знает, какие еще секреты удастся извлечь из этих подержанных чипов.
Похожие статьи
 Корабль Starship впервые вернулся на базу SpaceX после 75-дневного морского путешествия
 В Китае создали рекордный нейроинтерфейс весом всего 3 грамма
 DeepSeek привлек почти $12 млрд: крупнейшие инвестиции поступили от Tencent и CATL
 Intel готовит новые процессоры Core 2000HX: старый добрый Raptor Lake в новой обёртке
 ИИ от Google позволяет создавать игры всего по одной идее
 Яндекс 360 проведёт Yandex Connect 22 октября в Москве и онлайн
 «Сферум» открыл платформу школьных олимпиад
 Роботы-пылесосы Xiaomi Robot Vacuum X20 Pro поступили в продажу в России: уборка с искусственным интеллектом